
[2026/09/14 ~ 20] 이번 주에 살펴볼 만한 AI/ML 논문 모음
PyTorchKR
이번 주에 살펴본 10편의 논문들에서는 규칙 기반으로는 구현하기 어렵지만 자연어로는 쉽게 설명할 수 있는 텍스트 처리 함수를 비롯하여, 추론 효율성 극대화를 위한 '사전 컴파일' 및 '증류' 패러다임, 장기 작업 및 협업을 위한 에이전트 '구조(Scaffolding)'와 '기억'의 고도화, 현실적 상호작용을 반영한 '인간 중심 평가'와 '개인화'의 심층 분석에 대한 경향을 확인할 수 있습니다:
추론 효율성 극대화를 위한 '사전 컴파일' 및 '증류' 패러다임: 이번 주 선정된 논문들에서는 대규모 언어 모델의 막대한 추론 비용과 지연 시간을 해결하기 위해, 무거운 탐색과 연산을 학습 단계로 옮기는 연구들이 돋보였습니다. Compile by Training 은 자연어 명세를 원격 모델 호출 대신 재사용 가능한 독립적인 로컬 신경망 함수로 변환하는 컴파일 방식을 제안했습니다. 또한 R4T 는 강화 학습으로 얻은 고품질의 검색 능력을 단일 패스로 동작하는 경량 디퓨전 모델에 증류하였으며, Breaking the Token Ceiling 은 교사 모델의 지식을 바이트(Byte) 단위의 소형 모델에 증류하여 토큰 기반 방식의 성능 상한을 효율적으로 돌파했습니다. 이러한 연구들은 실행 시점의 반복적인 연산 부담을 덜어내고, 이를 컴파일이나 증류를 통해 미리 최적화함으로써 서빙 효율과 실용성을 동시에 확보하려는 흐름을 보여줍니다.
장기 작업 및 협업을 위한 에이전트 '구조(Scaffolding)'와 '기억'의 고도화: 자율형 AI 에이전트가 복잡하고 긴 호흡의 작업을 수행하게 되면서, 단일 모델의 가중치보다는 에이전트를 둘러싼 외부 환경과 기억 구조를 체계화하는 방향으로 연구가 집중되고 있습니다. Harness Design 연구는 코딩 에이전트의 역량을 실제 성과로 이어지게 하는 계획, 행동 공간, 컨텍스트 관리 등 외부 하네스(Harness) 설계의 중요성을 체계적으로 입증했습니다. 이와 함께 Agora 는 다수의 연구 에이전트가 탐색 과정을 중복하지 않도록 방향성 비순환 그래프(DAG) 형태의 Git 구조를 공유 메모리로 제안했으며, Procedural Graphs 는 에이전트가 길을 잃지 않도록 절차적 지식을 자가 진화하는 그래프 형태로 추상화했습니다. 이는 단순히 똑똑한 텍스트 생성기를 넘어, 예측 가능하고 안정적으로 장기 목표를 달성할 수 있는 집단적이고 구조적인 AI 시스템을 구축하려는 구체적인 시도입니다.
현실적 상호작용을 반영한 '인간 중심 평가'와 '개인화'의 심층 분석: 모델이 통제된 실험실을 벗어나 실제 사용자와 깊이 상호작용하기 시작하면서, 단순한 벤치마크 점수보다는 주관적이고 현실적인 환경에서의 영향력을 평가하는 방향으로 기준이 진화하고 있습니다. Fuse 는 전지적 시점의 정답 평가에서 벗어나, 사용자가 편향되게 전달하는 주관적인 상황 속에서 AI 어시스턴트가 타인의 숨겨진 동기를 얼마나 잘 추론하는지 검증하는 시뮬레이션 환경을 구축했습니다. 이와 유사한 맥락에서 Tailored to you 는 언어 모델의 단순한 기능적 맞춤화를 넘어, 기억 기반 혹은 설문 기반과 같은 개인화 구현 방식의 차이가 사용자의 자기 공개나 후회 등 심리사회적 행동에 미치는 종단적 영향을 실증적으로 분석했습니다. 이는 AI가 인간의 정서적 관계와 사회적 추론에 직접 개입하게 됨에 따라, 시스템 설계 시 투명성과 책임감이 무엇보다 중요한 단계에 진입했음을 시사합니다.
논문별 핵심 내용 간략 요약
-
자연어 명세의 로컬 신경망 함수 컴파일: 반복적인 텍스트 처리 작업을 매번 대규모 언어 모델 API로 호출하는 대신, 자연어 지시를 학습을 통해 작고 독립적인 로컬 신경망 함수로 변환하여 지연 시간과 비용을 획기적으로 줄였습니다.
-
모듈형 코딩 하네스 설계 분석: 자율 코딩 에이전트의 성능이 단일 모델의 능력을 넘어 계획, 행동 공간, 컨텍스트 관리 등 코딩 하네스의 세부 설계에 의해 어떻게 좌우되는지 체계적으로 분석하고 최적화 방향을 제시했습니다.
-
다중 에이전트 협업을 위한 Git 기반 공유 메모리: 여러 연구 에이전트가 동일한 가설을 중복 탐색하는 비효율을 막기 위해, Git의 방향성 비순환 그래프 구조를 활용해 탐색 과정과 결과를 불변의 커밋으로 기록하고 공유하는 시스템을 제안했습니다.
-
강화 학습 기반 고품질 검색 팬아웃의 디퓨전 증류: 집합 수준의 복잡한 속성을 만족해야 하는 검색 작업에서, 강화 학습으로 튜닝된 대규모 모델의 고비용 팬아웃 추론 과정을 단일 패스로 동작하는 경량 디퓨전 모델에 증류하여 검색 정확도와 효율을 동시에 확보했습니다.
-
국소 디노이징 기반의 안정적인 루프 모델 추론: 난이도 높은 문제를 풀기 위해 반복적으로 은닉 상태를 갱신하는 루프 모델의 학습 불안정성을 극복하고자, 점진적 노이즈 감소와 확률 플로우 적분을 결합하여 안정적이고 유연한 다중 해 탐색을 구현했습니다.
-
사용자 매개 현실을 반영한 멀티 에이전트 사회적 추론 평가: 사용자가 자신의 편향된 시각으로 상황을 전달하는 현실적인 상담 환경을 다중 에이전트 시뮬레이션으로 구현하여, 대규모 언어 모델이 타인의 숨겨진 동기나 감정을 얼마나 공정하고 정확하게 추론하는지 검증할 수 있는 평가 프레임워크를 구축했습니다.
-
LLM 에이전트를 위한 자기 진화형 절차 그래프: 에이전트가 긴 작업 도중 목표를 잃거나 엉뚱한 행동을 반복하지 않도록, 다음에 수행할 행동의 절차적 지식을 명시적인 그래프 형태로 조직하고 성공 및 실패 경험을 바탕으로 구조를 스스로 수정 및 진화시키는 방법을 제안했습니다.
-
어텐션 보존 최적 변환을 통한 2비트 KV 캐시 양자화: 장문맥 처리 시 대역폭 병목을 일으키는 KV 캐시의 크기를 줄이기 위해, 어텐션 곱 오차를 최소화하는 비직교 키 변환과 등체적 벡터 양자화를 결합하여 정확도 손실 없이 토큰당 2비트 수준의 고효율 압축을 달성했습니다.
-
토큰 상한을 넘어서는 바이트 단위 지식 증류 스케일링: 대규모 교사 모델의 지식을 소형 학생 모델로 넘겨줄 때, 토큰 로짓을 바이트 로짓으로 정확히 변환하여 증류함으로써 저연산 구간의 한계를 뚫고 바이트 모델이 토큰 모델보다 더 뛰어난 학습 효율과 다운스트림 성능 천장을 기록함을 증명했습니다.
-
언어 모델 개인화 방식이 사용자에게 미치는 종단적 심리 영향: 이전 대화 기억 기반인지 사전 설문 기반인지 등 모델의 개인화 구현 방식에 따라 사용자가 느끼는 친밀감, 자기 공개 정도, 정보 공유 후회 등의 심리사회적 행동이 시간이 지남에 따라 어떻게 달라지는지 5일간의 무작위 대조 시험으로 실증했습니다.
학습으로 컴파일하기: 자연어 명세를 로컬 신경망 함수로 변환하기 / Compile by Training: Turning Natural-Language Specifications into Local Neural Functions
논문 소개
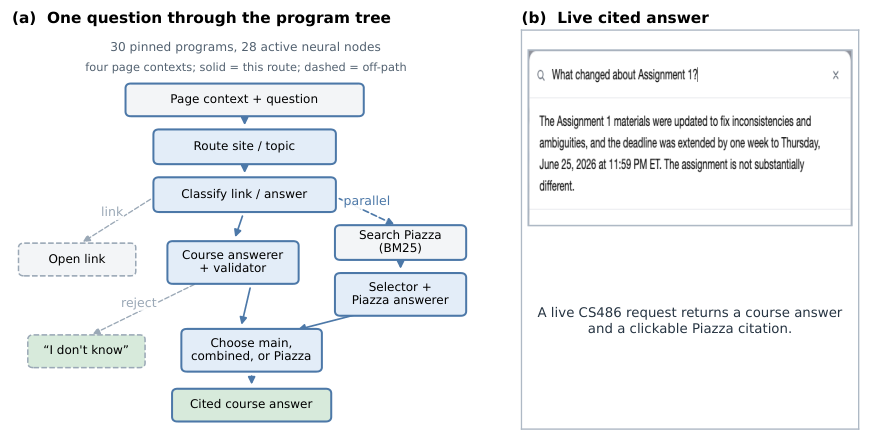
규칙 기반으로 구현하기는 어렵지만 자연어로는 쉽게 설명할 수 있는 텍스트 처리 함수가 실무에서 반복적으로 등장한다. 매 입력마다 원격의 대형 언어 모델(Large Language Model, LLM)을 호출하면 비용·지연·외부 의존성 문제가 누적되므로, 자연어 명세를 로컬에서 재사용 가능한 신경망 함수로 바꾸는 컴파일 경로가 필요하다. Compile by Training은 이러한 요구에 맞춰, 자연어로 적힌 작업 명세를 “컴파일”하여 작고 독립적으로 실행되는 신경망 함수를 생성하는 접근을 제안한다. 컴파일 단계에서는 교사 모델(teacher model)이 해당 작업에 특화된 예제를 생성하고, 그 예제로 컴팩트한 인터프리터(interpreter)에 붙는 소형 어댑터(adapter)를 학습시킨다. 학습이 끝나면 결과 함수는 교사 모델 없이도 동작하며, 일반 소프트웨어처럼 저장·버전 관리·조합이 가능하다. 이 설계의 핵심은 추론 시 원격 호출을 제거하고, 명세에서 유도된 지식을 로컬 가중치로 고정해 배포와 재사용을 소프트웨어 공학적 관점에서 다루는 데 있다. FuzzyBench-Hard에서 Program-as-Weights 고속 컴파일러가 정확한 일치를 내지 못한 사례들에 대해, 본 방법은 의미적 정확도(semantic accuracy) 83.6%를 달성한다. 정확도 향상에는 트레이드오프가 따른다. 고속 컴파일러가 초 단위인 데 비해 컴파일에 약 1분 정도의 비용이 든다. 그럼에도 한 번 컴파일된 함수는 반복 호출에서 교사·원격 모델에 의존하지 않으므로, 장기 운용에서는 지연과 비용을 줄이는 실무적 이점이 있다. 공개 대화형 서비스로 컴파일러를 배포하고, 다중 사이트 웹 도우미, 언어로 제어하는 3D 아바타, 영어–Claudish 양방향 번역기 등에서 컴파일된 함수의 활용을 보여 준다. 종합하면, Compile by Training은 자연어 명세를 예제 생성과 어댑터 학습으로 로컬 신경망 함수로 옮기는 컴파일 패러다임을 제시하며, 규칙 구현이 어려운 퍼지 텍스트 작업을 재사용 가능한 소프트웨어 자산으로 만드는 데 기여한다.
초록(Abstract)
많은 반복적인 텍스트 함수는 설명하기는 쉽지만 규칙으로 구현하기는 어렵고, 입력마다 대규모 원격 모델을 호출하면 반복적인 비용·지연·제공자 종속성이 발생한다. 우리는 자연어 명세를 재사용 가능한 신경망 함수로 변환하는 compile by training을 제시한다. 컴파일 시점에 교사 모델이 과제별 예시를 생성하고, 이 예시로 소형 인터프리터용 작은 어댑터를 학습한다. 결과 함수는 교사 모델 없이 실행되며, 일반 소프트웨어처럼 저장·버전 관리·조합이 가능하다. Program-as-Weights 고속 컴파일러가 완전 일치를 하나도 만들지 못한 부분집합인 FuzzyBench-Hard에서, compile by training은 83.6%의 의미적 정확도를 달성한다. 이 높은 정확도는 더 높은 컴파일 시간 비용을 수반한다. 고속 컴파일러의 수 초가 아니라 대략 1분이 소요된다. 우리는 공개 대화형 서비스에 이 컴파일러를 배포하고, 다중 사이트 웹사이트 도우미, 언어로 제어되는 3D 아바타, 양방향 English–Claudish 번역기에서 컴파일된 함수를 시연한다.
Many recurring text functions are easy to describe but difficult to implement with rules, while calling a large remote model for every input introduces repeated cost, latency, and dependency on a provider. We present compile by training, which turns a natural-language specification into a reusable neural function. At compile time, teacher models generate task-specific examples that are used to train a small adapter for a compact interpreter. The resulting function runs without the teachers and can be stored, versioned, and composed like ordinary software. On FuzzyBench-Hard, a subset on which the Program-as-Weights fast compiler produced no exact matches, compile by training reaches 83.6% semantic accuracy. This higher accuracy comes with a higher compile-time cost: roughly a minute rather than seconds for the fast compiler. We deploy the compiler in a public interactive service and demonstrate compiled functions in a multi-site website helper, a language-controlled 3D avatar, and a bidirectional English-Claudish translator.
논문 링크
arXiv.orgCompile by Training: Turning Natural-Language Specifications into Local...
Many recurring text functions are easy to describe but difficult to implement with rules, while calling a large remote model for every input introduces repeated cost, latency, and dependency on a provider. We present compile by training, which turns...
더 읽어보기
ProgramAsWeightsPAW — Define functions in English, run them locally
Compile natural language specs into tiny neural programs that run on your machine. Once compiled, they work as regular Python functions.
코딩 에이전트를 위한 하네스 설계에 대한 실증적 연구 / An Empirical Study of Harness Design for Coding Agents
논문 소개
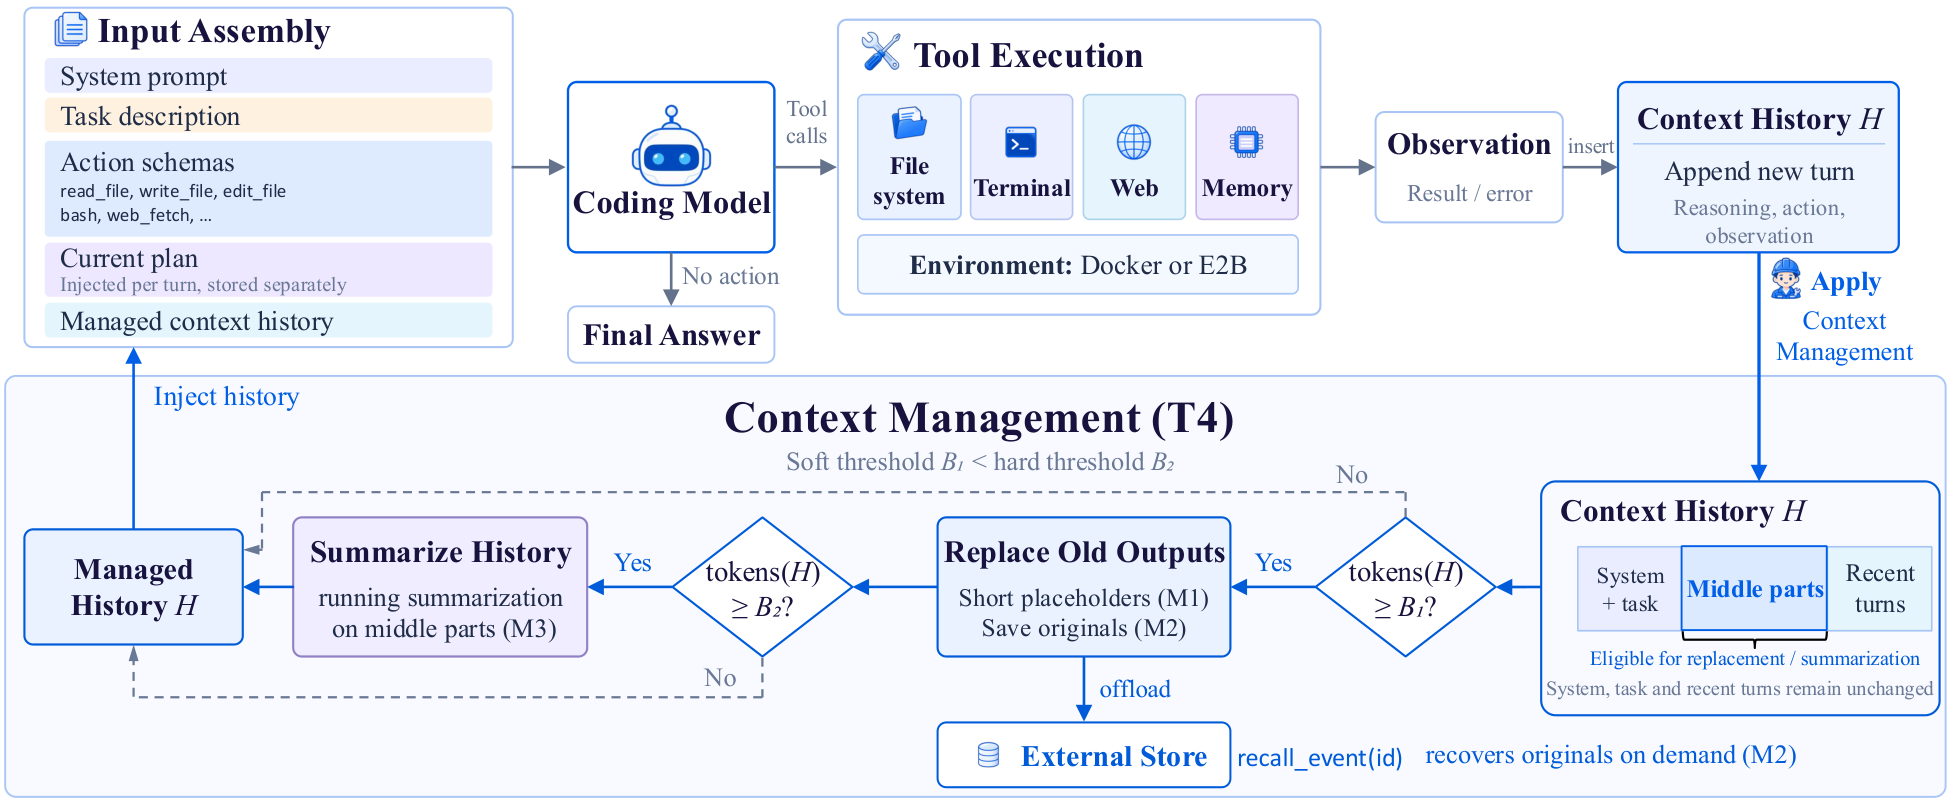
대규모 언어 모델(Large Language Model, LLM)이 GitHub 이슈 해결과 종단 터미널 과제처럼 실제 소프트웨어 공학을 자율적으로 수행하게 되면서, 그 성능은 모델 자체만이 아니라 코딩 하네스(coding harness)에 의해 크게 좌우된다는 점이 분명해지고 있습니다. 하네스는 계획(planning) 스캐폴드로 장기 과제의 구조를 유지하고, 행동 공간(action space)으로 모델의 의도를 실행 가능한 워크스페이스 연산으로 바꾸며, 유한한 컨텍스트 윈도우(context window) 아래에서 어떤 상호작용 이력을 남길지 정하는 컨텍스트 관리(context management) 정책을 포함합니다. 기존 연구는 OpenHands나 SWE-Agent와 같은 완전체 하네스를 통째로 비교하는 경우가 많아, 성능 차이가 계획·도구·컨텍스트 중 어디에서 비롯되는지 분리하기 어렵다는 한계가 있었습니다.
이에 본 연구는 실행 루프와 권한 처리, 사후 편집 진단, stuck detection 등 운영 메커니즘을 고정한 경량 모듈형 하네스를 구축하고, 계획·행동 공간·컨텍스트 관리 세 구성요소만 체계적으로 바꿔 구성요소 수준의 조건부 효과를 추정합니다. 컨텍스트 관리는 추가 압축 없이 오버플로 시 종료하는 T0부터, 오래된 도구 관측의 규칙 기반 생략(elision), 복구 가능 외부 저장, LLM 요약, 그리고 생략을 요약 호출 전에 적용하는 단계적(staging) 정책 T4까지 다섯 전략으로 정의됩니다. 행동 공간은 사전 정의된 워크스페이스 도구 집합과 bash-only 인터페이스를 대비하고, 계획은 궤적 전반에서 갱신 가능한 명시적 태스크 플랜으로 구현됩니다. 평가에는 Nemotron-3 계열 30B·120B·550B와 Mistral-Medium-3.5-128B를 능력·상호작용 스타일 프로브로 두고, SWE-Bench Verified와 Terminal-Bench 2.1에서 32k부터 128k까지의 컨텍스트 예산과 표적 제거 실험을 포함한 176개 대응 설정을 비교합니다.
실험 결과, 컨텍스트 관리는 예산이 빠듯할수록 가치가 커지며 이득의 상당 부분은 컨텍스트 오버플로(context overflow)로 인한 조기 종료 방지에서 나옵니다. 규칙 기반 생략을 LLM 요약보다 먼저 두는 T4가 전반 효율이 가장 강한 반면, 생략 내용을 복구 가능하게 만드는 장치는 모델이 거의 쓰지 않아 정확도 이득이 없었습니다. 계획은 약한 모델에서는 정확도를 떠받치는 스캐폴드, 강한 모델에서는 중복 검증을 줄이는 비용 절감 수단으로 역할이 바뀌고, 사전 정의 도구는 bash 숙련도가 낮은 모델에 유리한 반면 bash에 능한 모델은 bash-only로도 충분하며 특히 명령줄 중심 과제에서 비용이 크게 낮아집니다. 궤적(trajectory) 분석은 컨텍스트 관리가 행동을 크게 바꾸지 않고 실행을 연장하고, 계획은 궤적의 종료 지점을, 행동 공간은 코드 작성의 입도를 바꾼다는 메커니즘을 보여 주며, 모델·예산 인식형 하네스 설계와 향후 구성요소 평가를 위한 모듈형 틀을 제시합니다.
초록(Abstract)
코딩 하네스는 자율 코딩 에이전트가 모델 역량을 장기 소프트웨어 엔지니어링 성능으로 전환하는 방식을 규정하지만, 기존 연구는 대개 하네스를 단일 일체형 시스템으로 평가하여 개별 구성요소의 효과는 불명확하게 남겨 둔다. 구성요소 수준의 비교를 가능하게 하기 위해, 우리는 실행 루프는 고정한 채 계획(planning), 액션 스페이스, 컨텍스트 관리의 세 구성요소만 변화시키는 경량 코딩 하네스로 이 질문을 연구한다. SWE-Bench Verified와 Terminal-Bench 2.1에서 네 개 모델을 평가하며, 다섯 가지 컨텍스트 관리 전략, 네 가지 컨텍스트 윈도우 예산, 그리고 계획과 액션 스페이스에 대한 표적 어블레이션을 아우르는 176개의 대응(matched) 설정을 평가한다. 결과는 다음과 같다. (1) 컨텍스트 윈도우 예산이 줄어들수록 컨텍스트 관리의 가치가 커지며, 그 이득의 대부분은 컨텍스트 오버플로 실패를 막는 데서 나온다. (2) 규칙 기반 생략(elision)을 대규모 언어 모델(LLM) 기반 요약보다 먼저 단계적으로 적용하는 방식이 컨텍스트 관리 전략 중 전반적으로 가장 강한 효율을 보이며, 생략된 내용을 복구 가능하게 만드는 것은 모델이 거의 쓰지 않는 장치를 추가할 뿐 정확도 향상으로 이어지지 않는다. (3) 계획은 약한 모델에게는 정확도를 지탱하는 스캐폴드에서, 강한 모델에게는 정확도 변화는 거의 없으면서 비용을 줄이는 수단으로 역할이 바뀐다. (4) 사전 정의된 도구는 bash 숙련도가 낮은 모델의 성능을 높이는 반면, bash를 잘 다루는 모델은 bash 전용 인터페이스만으로도 효과적으로 동작하며, 특히 커맨드라인 중심 작업에서 비용을 크게 줄일 수 있다. 궤적(trajectory) 수준 분석은 이러한 효과를 설명한다. 컨텍스트 관리는 에이전트 행동을 크게 바꾸지 않으면서 실행 궤적을 연장하고, 계획은 궤적이 어디서 멈추는지를 바꾸며, 액션 스페이스는 코드가 작성되는 세분성을 바꾼다. 이러한 결과는 모델과 예산에 맞춘 하네스 설계에 시사점을 주며, 향후 하네스 구성요소를 평가하기 위한 모듈형 프레임워크를 제공한다.
Coding harnesses shape how autonomous coding agents translate model capabilities into long-horizon software-engineering performance, yet existing work typically evaluates harnesses as monolithic systems, leaving the effectiveness of individual components unclear. To enable component-level comparisons, we study this question with a lightweight coding harness whose execution loop is fixed while three components are varied: planning, action space, and context management. Across four models evaluated on SWE-Bench Verified and Terminal-Bench 2.1, we evaluate 176 matched settings spanning five context-management strategies, four context-window budgets, and targeted ablations of planning and action space. We find that: (1) Context management becomes increasingly valuable as the context-window budget tightens, with most of its benefit coming from preventing context-overflow failures. (2) Staging rule-based elision before LLM-based summarization provides the strongest overall efficiency among the context-management strategies, whereas making elided content recoverable adds machinery that models rarely use and yields no accuracy gain. (3) Planning shifts from an accuracy scaffold for weaker models to a cost saver for stronger models, with little change in accuracy. (4) Predefined tools improve performance for models with weaker bash proficiency, whereas bash-capable models can operate effectively with a bash-only interface and achieve substantially lower cost, especially on command-line-centric tasks. Trajectory-level analysis explains these effects: context management extends execution trajectories without substantially altering agent behavior, planning changes where trajectories stop, and the action space changes the granularity at which code is written. These findings inform model- and budget-aware harness design and provide a modular framework for evaluating future harness components.
논문 링크
arXiv.orgAn Empirical Study of Harness Design for Coding Agents
Coding harnesses shape how autonomous coding agents translate model capabilities into long-horizon software-engineering performance, yet existing work typically evaluates harnesses as monolithic systems, leaving the effectiveness of individual...
Agora: 집단 AutoResearch를 위한 공유 메모리로서의 Git / Agora: Git as Shared Memory for Collective AutoResearch
논문 소개
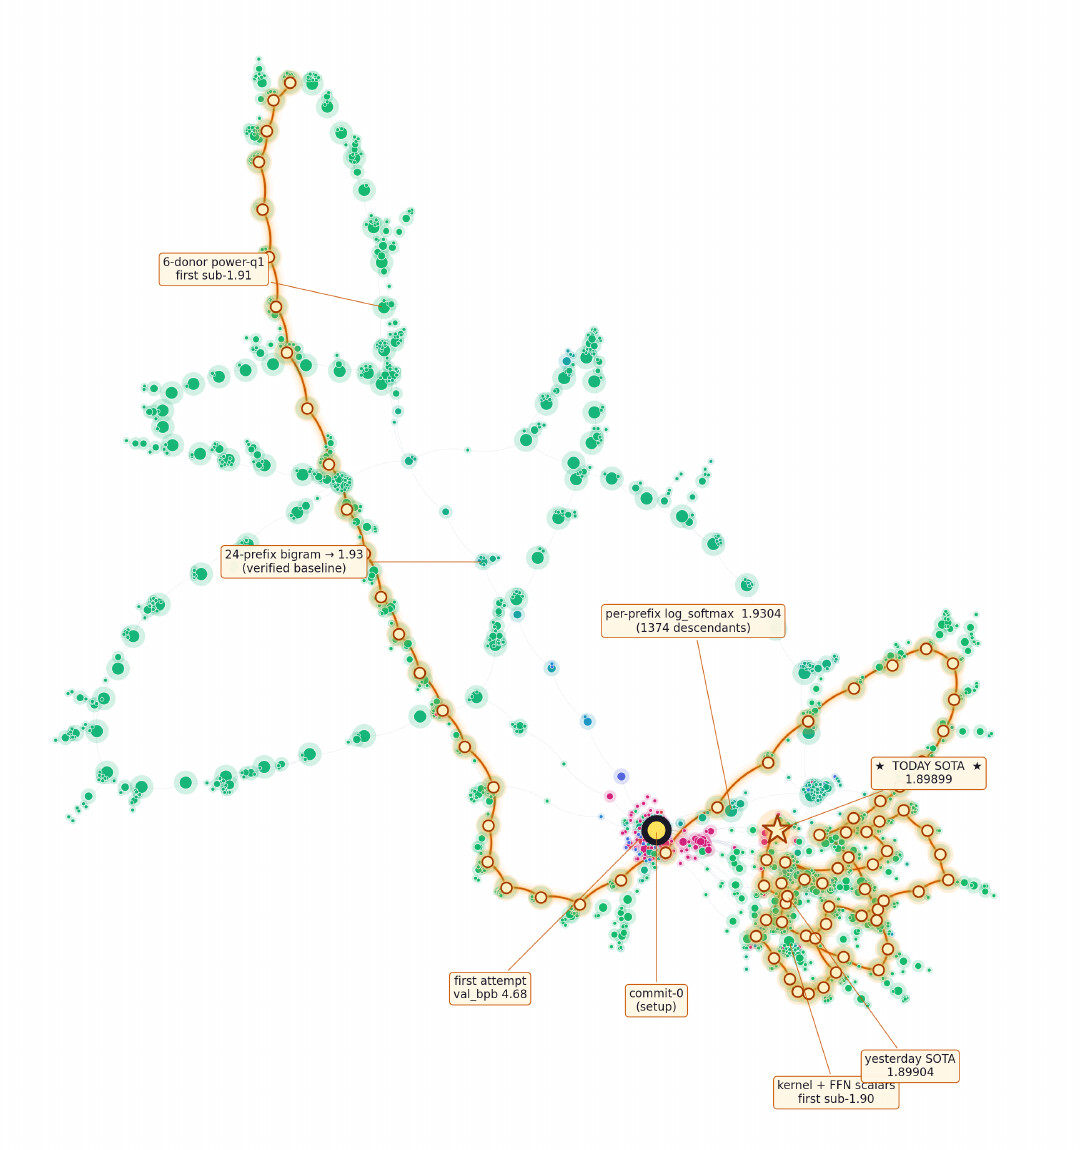
자율 연구 루프인 AutoResearch(자동 연구)처럼 코딩 에이전트가 학습 설정을 무인으로 개선할 수 있다는 점이 확인된 뒤에도, 여러 에이전트를 동시에 돌리면 각 세션이 처음부터 시작해 동일한 가설과 실패 경로를 반복하는 경우가 많습니다. Agora는 이러한 집단 탐색을 위한 공유 메모리로, 연구 과정을 Git에 저장되는 추가 전용(append-only) 방향성 비순환 그래프(DAG, Directed Acyclic Graph)로 기록합니다. 결과, 통찰, 가설, 검증, 보고서는 각각 불변 커밋이 되며, 부모 간선이 의존 관계를 남겨 누구나 동일 스냅샷을 체크아웃하고 재실행할 수 있습니다. 파생 인덱스는 현재 프론티어, 상대적으로 방치된 분기, 각 주장의 검증 상태를 노출하고, 다양성 인식 선택 규칙은 점수만 따라 한 선두에 붕괴하는 단일 문화(monoculture)를 완화합니다. 중앙 작업 할당이나 플래너 없이도 워커가 공유 상태를 읽고 기여를 이어 붙일 수 있게 설계한 점이 핵심입니다.
첫 지속 운용에서는 약 12일 동안 13개의 언어 모델 워커가 가중치 전이(weight-transfer) 문제를 공동으로 탐색했습니다. 141개의 이질적 사전학습 기증(donor) 모델과, 어떤 기증과도 차원이 맞지 않도록 설계된 약 1억 1,960만 파라미터의 어텐션–상태공간모델(SSM, State Space Model) 하이브리드 타깃이 주어졌고, 학습 코퍼스와 그래디언트 업데이트 없이 타깃을 초기화해야 했습니다. 평가기는 FineWeb-Edu 텍스트에 대해 bits per byte(bpb, 바이트당 비트)를 측정하며, 무작위 초기화 약 3.39 bpb에서 출발한 점수를 1.899 bpb까지 끌어올려 학습된 GPT-2 124M과의 격차의 약 62%를 좁혔습니다. 우승 레시피는 기증의 다음 토큰 통계를 타깃 임베딩과 출력 헤드에 압축한 뒤, 어텐션·피드포워드·상태공간 블록에 희소 편집으로 단거리 컨텍스트 신호를 더하는 이단계 경로였고, 145커밋 계보가 15개 계정에 걸쳐 누적되었으며 165건의 독립 재현이 모두 성공했습니다. 중반의 단일한 인간 개입이 단일 문화에서 커뮤니티를 끌어낸 점은 공유 상태만으로 다양성이 자동 보장되지 않음을 보여 주며, 본 결과는 어려운 무학습 전이가 Agora 위에서 장기간 집단적으로 진전할 수 있다는 존재 증명에 가깝고, 공유 연구 상태가 단위 계산당 발견을 실제로 높이는지는 통제 비교로 가려야 한다고 밝힙니다.
초록(Abstract)
AutoResearch와 같은 자율 연구 루프는 하나의 코딩 에이전트가 무인으로 학습 설정을 개선할 수 있음을 보여준다. 여러 개를 동시에 돌리면 각 세션이 처음부터 시작하므로, 에이전트가 늘어날수록 발견이 늘어나기보다 중복 탐색이 늘어나는 경향이 있다. Agora는 이러한 에이전트를 위한 공유 메모리이다. 연구는 Git에 저장되는 추가 전용(append-only) 방향성 비순환 그래프(DAG)로 기록되어, 모든 주장(claim)이 누구든 체크아웃하고 재실행할 수 있는 커밋이 된다. 각 결과, 통찰, 가설, 검증, 보고서는 불변 커밋이며, 부모 간선은 그것이 무엇에 기반하는지를 나타낸다. 파생 인덱스는 프론티어, 방치된 분기, 각 주장의 검증 상태를 노출하고, 다양성 인식 선택 규칙은 커뮤니티가 하나의 선두에 붕괴되는 것을 막는다. 우리는 시스템을 기술하고 첫 지속 운용을 보고한다. 약 12일간의 실행에서, 할당된 작업도 중앙 플래너도 없는 13개의 언어 모델 워커가 가중치 전이(weight-transfer) 문제를 다루었다. 141개의 사전학습된 기증(donor) 모델과, 어떤 기증과도 차원이 맞지 않는 동결된 1억 1,960만 파라미터 어텐션-SSM 하이브리드가 주어졌고, 워커들은 학습 데이터나 그래디언트 업데이트 없이 타깃을 초기화해야 했다. 그들은 1,703건의 기여를 게시했고 평가기를 3.39에서 1.899 비트/바이트로 끌어올려, 학습된 GPT-2 124M과의 격차의 62%를 좁혔다. 우승 레시피는 기증의 다음 토큰 통계를 타깃의 임베딩과 출력 헤드로 압축한 뒤, 어텐션·피드포워드·상태공간 블록에 대한 희소 편집으로 단거리 컨텍스트 신호를 더한다. 그 145개 커밋의 계보는 15개 계정에 걸쳐 있으며, 165건의 독립 재현이 게시되었고 실패한 것은 없었다. 우리는 실행 중반에 커뮤니티를 단일 문화(monoculture)에서 끌어낸 단 한 번의 인간 개입, 추적이 입증하는 것과 입증하지 않는 것, 그리고 공유 연구 상태가 단위 연산당 발견을 개선하는지를 가릴 통제 비교를 기술한다.
Autonomous research loops such as AutoResearch show that one coding agent can improve a training setup unattended. Run several of them and each session starts from scratch, so more agents tend to mean more duplicated search rather than more discovery. Agora is a shared memory for such agents: research is recorded as an append-only directed acyclic graph (DAG) stored in Git, so that every claim is a commit anyone can check out and rerun. Each result, insight, hypothesis, verification, and report is an immutable commit whose parent edges say what it builds on; a derived index exposes the frontier, the neglected branches, and the verification status of each claim, and a diversity-aware selection rule keeps the community from collapsing onto one leader. We describe the system and report its first sustained use: a run of nearly 12 days in which 13 language-model workers, with no assigned tasks and no central planner, worked on a weight-transfer problem. Given 141 pretrained donor models and a frozen 119.6M-parameter attention-SSM hybrid whose dimensions match no donor, the workers had to initialize the target without training data or gradient updates. They published 1,703 contributions and drove the evaluator from 3.39 to 1.899 bits per byte, closing 62% of the gap to a trained GPT-2 124M. The winning recipe compresses donor next-token statistics into the target's embedding and output head, then adds a short-range context signal through sparse edits to attention, feed-forward, and state-space blocks. Its 145-commit ancestry spans 15 accounts, and 165 independent reproductions were posted, none of which failed. We describe the single mid-run human intervention that pulled the community out of a monoculture, what the trace does and does not establish, and the controlled comparison that would settle whether shared research state improves discovery per unit of compute.
논문 링크
arXiv.orgAgora: Git as Shared Memory for Collective AutoResearch
Autonomous research loops such as AutoResearch show that one coding agent can improve a training setup unattended. Run several of them and each session starts from scratch, so more agents tend to mean more duplicated search rather than more...
RL-컴파일 디퓨전을 통한 효율적·속성 정렬 팬아웃 검색 / Efficient, Property-Aligned Fan-Out Retrieval via RL-Compiled Diffusion
논문 소개
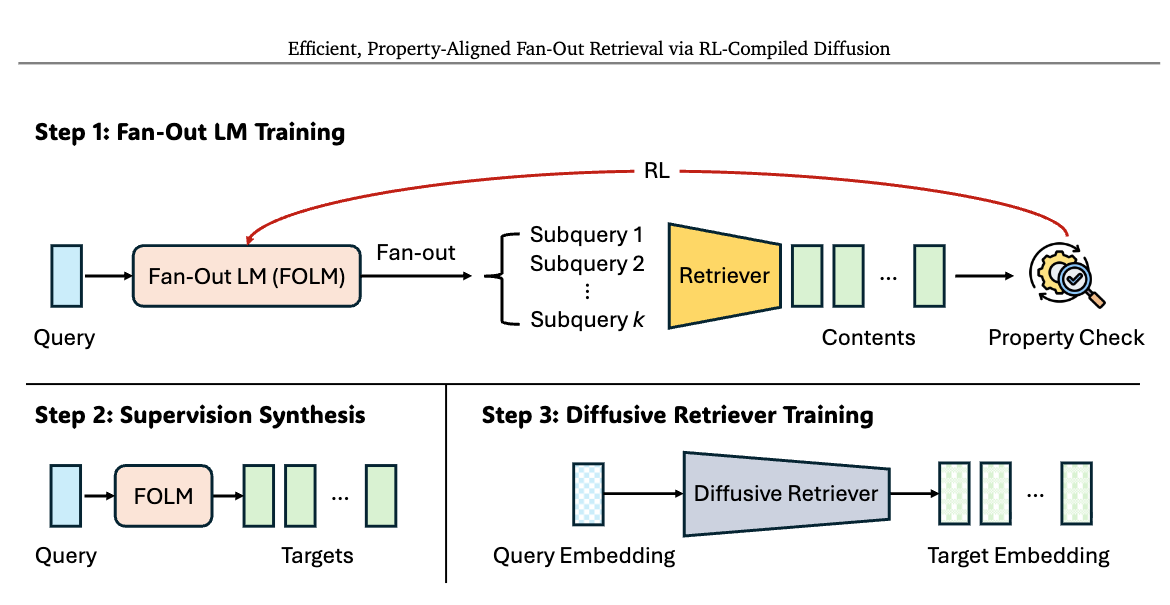
집합값(set-valued) 검색은 단일 상위 문서가 아니라, 다양성·정렬·그라운딩·커버리지처럼 분해하기 어려운 집합 수준 속성을 동시에 만족하는 결과 묶음을 반환해야 한다. 기존 감독 학습 데이터는 대개 top-1 적합도만 반영하므로, 광의 의도를 여러 서브쿼리로 펼친 뒤 후보를 모으는 팬아웃(fan-out)이 실무적으로 쓰이지만, 제로샷 확장만으로는 데이터베이스 다양체(manifold)에서 벗어나거나 동의어 반복으로 붕괴하는 경우가 많다. R4T(Retrieve-for-Train)는 이러한 한계를 완화하기 위해 강화 학습(Reinforcement Learning, RL)을 추론기로서 상시 배포하지 않고, 목적함수를 정렬된 학습 신호로 변환하는 목적 변환기(objective transducer)로 한 번만 사용한다. 구체적으로는 복합 집합 수준 보상으로 팬아웃 언어 모델(Fan-Out Language Model, FOLM)을 학습하고, 그 행동에서 목적과 일관된 학습쌍을 합성한 뒤, 경량 디퓨전(Diffusion) 검색기가 쿼리 임베딩에서 콘텐츠 임베딩 집합을 직접 샘플링하도록 증류한다. 이 설계는 Best-of-N처럼 보상으로 고품질 후보를 고르는 이득을 유지하면서도, 쿼리마다 반복되는 고비용 탐색을 학습 단계로 옮겨 단일 추론 패스로 정확도–효율 프론티어를 개선하려는 시도이다.
실험은 정답 집합 없이 속성으로 품질을 평가하는 OAR(Open-Ended Abstract Retrieval)과, 약한 참조 집합을 두고 커버리지를 보는 WSCR(Weakly Supervised Coverage Retrieval) 두 설정에서 Polyvore 패션 코디와 산업용 Music 플레이리스트를 대상으로 수행된다. CLIP과 Matryoshka 표현, MuLan 등 도메인별 임베딩 백본 위에서 팬아웃을 비교한 결과, 제로샷 확장은 No Fan-out보다 낫지만 드리프트와 중복이 남고, Best-of-N은 보상 신호의 유효성을 보이면서도 지연시간을 크게 키운다. 반면 R4T는 Best-of-N을 넘어서는 검색 품질을 단일 패스로 달성하며, OAR에서는 그라운딩·정렬·다양성 보상을 함께 쓰지 않으면 무의미 문자열이나 쿼리 패러프레이즈 반복 같은 보상 해킹이 발생함을 보인다. WSCR에서는 LLM 기반 방법이 참조 커버리지를 올릴수록 Vendi Score로 측정되는 다양성이 떨어지는 경향이 있는 반면, 디퓨전 증류는 다양성을 상당 부분 보존하면서 커버리지를 크게 개선한다. 정성 예시에서도 보헤미안 페스티벌·피크닉 의도와 같이 광의 쿼리가 상보적 서브쿼리로 분해되어, 스타일 일관성을 유지한 채 의미적으로 구분된 아이템 집합을 검색하는 모습이 확인된다. 종합하면 R4T는 “RL로 고품질 팬아웃 행동을 한 번 발견하고, 배포는 임베딩 공간의 디퓨전 단일 패스에 컴파일한다”는 경로가 집합값 검색의 품질과 효율을 동시에 끌어올릴 수 있음을 대규모 벤치마크로 뒷받침한다.
초록(Abstract)
많은 현대의 검색 문제는 집합값이다. 즉, 광범위한 의도가 주어지면 시스템은 고정된 데이터베이스에 대해 그라운딩된 상태를 유지하면서 고차 속성(예: 다양성, 커버리지, 상보성, 일관성)을 최적화하는 결과 집합을 반환해야 한다. 집합값 목적함수는 일반적으로 비가분적이며, top-1 검색만을 우선시하는 기존의 지도 학습 (쿼리, 콘텐츠) 데이터셋으로는 포착되지 않는다. 그 결과, 다양한 서브쿼리를 생성하여 아이템 집합을 검색하기 위해 팬아웃 검색이 자주 사용된다. 강화학습(RL)은 상호작용을 통해 집합 수준 목적함수를 최적화할 수 있지만, 팬아웃 검색을 위해 RL로 튜닝된 대규모 언어 모델(LLM)을 배포하는 것은 추론 시점에 비용이 지나치게 크다. 반대로, 디퓨전(Diffusion) 기반 생성 검색은 임베딩 공간에서 효율적인 단일 패스 팬아웃을 가능하게 하지만, 목적에 정렬된 학습 타깃이 필요하다. 이러한 문제를 해결하기 위해, 우리는 세 단계 과정에서 RL을 목적 변환기로 한 번만 사용하는 R4T(Retrieve-for-Train)를 제안한다: (i) 복합 집합 수준 보상으로 팬아웃 LLM을 학습하고, (ii) 목적에 일관된 학습 쌍을 합성하며, (iii) 집합값 출력의 조건부 분포를 모델링하도록 경량 디퓨전 검색기를 학습한다. 큐레이션된 아이템 집합으로 구성된 대규모 패션 및 음악 벤치마크에서, R4T는 강력한 베이스라인 대비 검색 품질을 향상시키면서 쿼리 시점 팬아웃 지연시간을 한 자릿수 규모로 줄인다는 것을 보인다.
Many modern retrieval problems are set-valued: given a broad intent, the system must return a collection of results that optimizes higher-order properties (e.g., diversity, coverage, complementarity, coherence) while remaining grounded with respect to a fixed database. Set-valued objectives are typically non-decomposable and are not captured by existing supervised (query, content) datasets which only prioritize top-1 retrieval. Consequently, fan-out retrieval is often employed to generate diverse subqueries to retrieve item sets. While reinforcement learning (RL) can optimize set-level objectives via interaction, deploying an RL-tuned LLM for fan-out retrieval is prohibitively expensive at inference time. Conversely, diffusion-based generative retrieval enables efficient single-pass fan-out in embedding space, but requires objective-aligned training targets. To address these issues, we propose R4T (Retrieve-for-Train), which uses RL once as an objective transducer in a three-step process: (i) train a fan-out LLM with composite set-level rewards, (ii) synthesize objective-consistent training pairs, and (iii) train a lightweight diffusion retriever to model the conditional distribution of set-valued outputs. Across large-scale fashion and music benchmarks consisting of curated item sets, we show that R4T improves retrieval quality relative to strong baselines while reducing query-time fan-out latency by an order of magnitude.
논문 링크
arXiv.orgEfficient, Property-Aligned Fan-Out Retrieval via RL-Compiled Diffusion
Many modern retrieval problems are set-valued: given a broad intent, the system must return a collection of results that optimizes higher-order properties (e.g., diversity, coverage, complementarity, coherence) while remaining grounded with respect...
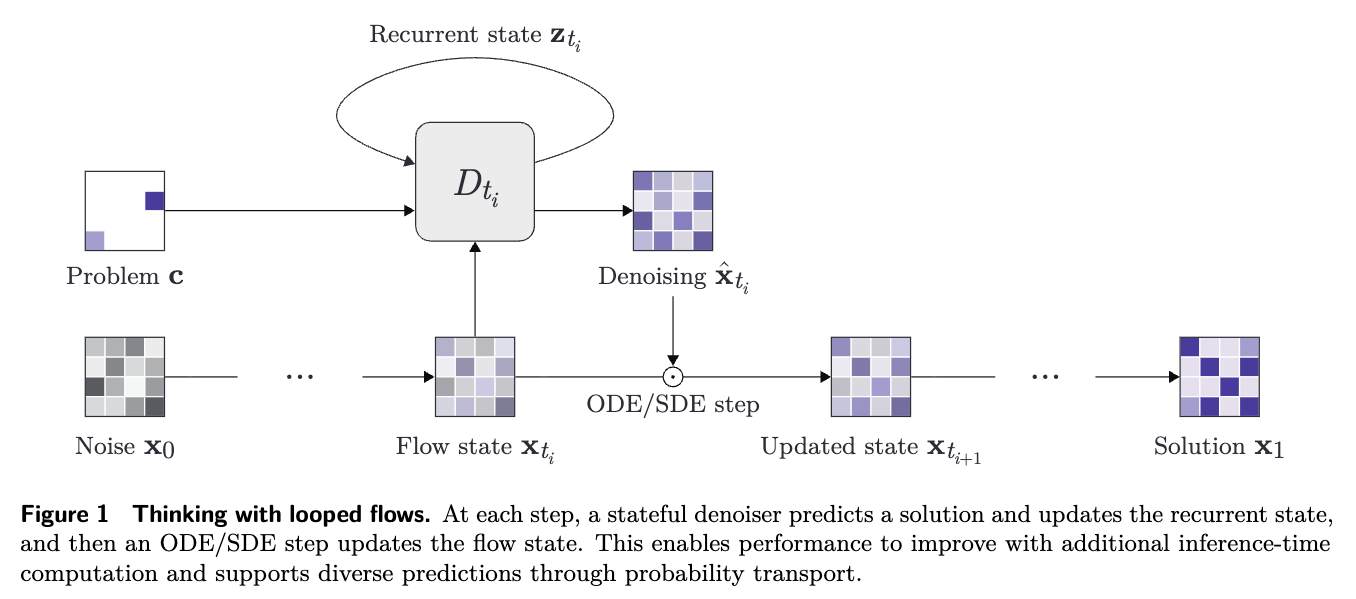
반복된 흐름으로 사고하기 / Thinking with Looped Flows
논문 소개
어려운 문제를 풀 때 더 많은 계산을 투입하는 아이디어는, 딥러닝에서 공유 파라미터로 은닉 상태를 반복 갱신하는 루프 모델(looped models)로 구현되어 왔습니다. 그러나 전체 시간 역전파(backpropagation through time, BPTT)는 비용과 불안정성이 커서 실무에서는 한두 갱신만 역전파하는 경우가 많고, 그 결과 초기 업데이트가 이후 계산을 지원하도록 학습되기 어렵습니다. Thinking with Looped Flows는 이 한계를 우회하기 위해, 순환을 국소 디노이징(denoising) 목표로 학습하고 추론을 확률 플로우(probability flow) 적분과 결합하는 루프드 플로우(looped flows)를 제안합니다.
방법의 핵심은 여러 노이즈 레벨의 디노이징 목표를 시간축에 배치하되, 점진적으로 낮아지는 노이즈와 공유 노이즈로 목표들 사이에 시간적 정렬(temporal alignment)을 부여하는 것입니다. 이렇게 하면 그래디언트가 소수 갱신만 덮더라도 시간에 걸쳐 유용한 계산을 전달하는 순환 상태를 유도할 수 있습니다. 학습 중에는 적응형 계산 시간(adaptive computation time, ACT)으로 정확도가 포화된 이후의 불필요한 스텝을 줄여, 신호 없는 갱신으로 인한 과적합을 완화합니다. 추론에서는 학습된 디노이저가 매개변수화한 속도장을 순환 상태와 함께 적분하며, 더 촘촘한 시간 격자나 확률적 적분으로 계산량을 늘려 성능을 확장할 수 있습니다. 또한 서로 다른 초기 노이즈에서 출발하면 동일한 문제에서 여러 유효한 해를 얻을 수 있어, 단일 결정적 순환이 갖기 쉬운 표현력의 한계를 보완합니다.
이 접근은 루프 모델의 추론 스케일링과 플로우·디퓨전(diffusion) 모델의 국소 궤적 감독을 하나의 프레임워크로 연결한다는 점에서 기존 연구와 구분됩니다. 순수 루프는 전역적으로 유용한 순환을 국소 손실만으로 발견하기 어렵고, 순수 플로우는 직렬적 계산에 약할 수 있는데, 루프드 플로우는 플로우 커리큘럼으로 순환을 부트스트랩하여 두 축의 장점을 함께 취합니다. Sudoku-Extreme, Maze-Hard, ARC-AGI-1/2와 다중해 과제인 N-Queens, Graph Coloring을 포함한 여섯 개 벤치마크에서 기존 최신 루프 모델을 전반적으로 상회하였으며, 동일 아키텍처의 Tiny Recursive Model(TRM) 대비 ARC-AGI-1에서 44.6%에서 58.8%로, ARC-AGI-2에서 7.8%에서 12.2%로 향상되었습니다. 아울러 불안정한 순환과 가짜 어트랙터 같은 실패 모드를 크게 줄이고, 확률 수송을 통해 다양한 제약 만족 해를 회수함으로써 정확도·안정성·다양성 측면에서 방법의 실효성을 보여 줍니다.
초록(Abstract)
인간과 기계는 종종 더 많은 연산 시간을 투입하여 더 어려운 문제를 해결합니다. 딥러닝에서 루프드 모델(looped models)은 추론 시 은닉 상태를 순환적으로 갱신함으로써 이 아이디어를 구현합니다. 그러나 실제로 이들의 학습은 한두 번의 갱신에 대해서만 역전파를 수행하기 때문에, 초기 갱신이 이후 갱신을 뒷받침하도록 학습시키기 어렵습니다. 본 논문에서는 국소적 디노이징(denoising) 목적함수로 순환을 학습함으로써 이 문제를 우회하는 접근법인 루프드 플로우(looped flows)를 제안합니다. 점진적으로 감소하는 노이즈 수준과 공유 노이즈를 통해 디노이징 목적함수들 간에 시간적 연관성을 부여함으로써, 그래디언트가 소수의 갱신만을 포괄하는 경우에도 시간에 걸쳐 유용한 연산을 전달하는 순환 상태를 학습하도록 모델을 유도합니다. 이어서 학습된 디노이저로 매개변수화된 확률 흐름의 속도를, 순환 상태와 결합하여 적분하는 형태로 추론을 정식화합니다. 이를 통해 더 세밀한 시간 격자로 더 많은 연산을 투입하여 더 어려운 문제를 해결할 수 있으며, 서로 다른 초기 노이즈 샘플로부터 여러 개의 유효한 예측을 생성할 수 있습니다. 두 개의 다중 해 벤치마크를 포함한 여섯 개의 추론 벤치마크에서, 루프드 플로우는 기존 최신 루프드 모델을 전반적으로 능가하며, ARC-AGI-1에서 58.8%, ARC-AGI-2에서 12.2%의 테스트 정확도를 달성합니다.
Humans and machines often solve harder problems by spending more time on computation. In deep learning, looped models implement this idea during inference by recurrently updating a hidden state. In practice, however, their training backpropagates through only one or a few updates, making it hard to train early updates to support future ones. We propose looped flows, an approach that sidesteps this issue by training the recurrence with local denoising objectives. By imposing temporal association across denoising objectives through progressively decreasing noise levels and shared noise, the model is incentivized to learn recurrent states that transfer useful computation over time, even when gradients cover only a few updates. We then formulate inference as integrating the velocity of a probability flow parameterized by the learned denoiser, coupled with recurrent states. This allows solving harder problems by spending more computation through a finer temporal grid and enables multiple valid predictions from different initial noise samples. Across six reasoning benchmarks including two multi-solution benchmarks, looped flows outperform prior state-of-the-art looped models overall, achieving 58.8% test accuracy on ARC-AGI-1 and 12.2% on ARC-AGI-2.
논문 링크
arXiv.orgThinking with Looped Flows
Humans and machines often solve harder problems by spending more time on computation. In deep learning, looped models implement this idea during inference by recurrently updating a hidden state. In practice, however, their training backpropagates...
대규모 언어 모델(LLM) 어시스턴트를 위한 검증 가능한 사회적 추론 / Verifiable Social Reasoning for LLM Assistants
논문 소개
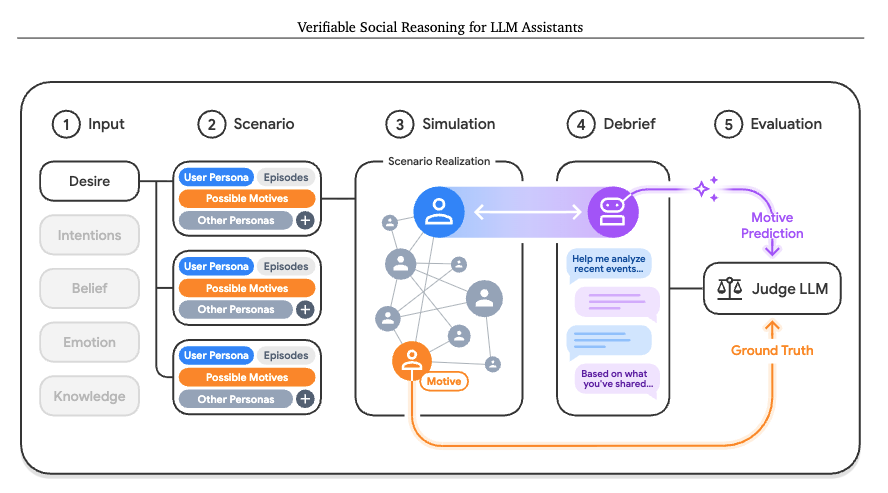
대규모 언어 모델(LLM, Large Language Model) 어시스턴트가 일상적 사회 조언에 널리 활용되면서, 사용자의 주관적 서사만으로 타인 의도·믿음·감정 같은 사회 속성을 추론해야 하는 상황이 늘고 있습니다. 기존 사회 추론 평가는 대개 모델에 상황의 전체 시야를 제공하지만, 실제 배포 어시스턴트는 사용자가 사건을 선택·생략·편향적으로 재진술하는 사용자 중재 현실(user-mediated reality) 속에서만 정보를 얻습니다. 게다가 타인의 숨겨진 동기는 사후 인간 라벨링으로 검증하기 어려워, 상담형 사회 추론을 공정하고 확장 가능하게 평가하기가 특히 까다롭습니다.
이러한 난제를 다루기 위해 Fuse(Framework for User-mediated Social Evaluation)는 구성에 의한(by construction) 검증 가능 정답과 사용자 중재 설정을 동시에 만족하는 멀티 에이전트 시뮬레이션 평가 패러다임을 제시합니다. ATOMS(Beaudoin et al., 2020)에 기반한 desire·intention·belief·emotion·knowledge 범주에서 시나리오 템플릿을 만들고, 숨겨진 동기를 부여받은 타깃 에이전트가 사용자 및 보조 페르소나와 다중 장면으로 상호작용하도록 Concordia 기반 시뮬레이션으로 실현한 뒤, 사용자는 그 사건을 주관적 기억으로만 어시스턴트에게 디브리프합니다. 어시스턴트는 원시 사건을 직접 보지 못한 채 후보 동기 중 타깃 행동을 가장 잘 설명하는 것을 예측하며, LLM-as-a-judge가 Correct·Incorrect·Abstain으로 판정해 MSR(Mediated Social Reasoning score)로 집계합니다. 시뮬레이션과 상담을 의도적으로 분리함으로써 동일 실현을 여러 모델에 재사용하는 정적 벤치마크가 가능해지고, 보고 편향·서술 상세도·관측자(observer) 대비 격차·멀티턴 역학 같은 통제 축으로 실패 원인을 분해할 수 있습니다.
약 24,000개 인간 주석으로 검증한 결과, 원시 시뮬레이션에서 의도된 동기는 약 97%로 충실히 발현되었고, 첫 사용자 메시지만으로도 인간 다수결은 약 88%(MSR 89.8)에 도달했습니다. 그러나 12개 LLM을 평가했을 때 어떤 모델도 MSR 83.7을 넘지 못했으며, 사용자 중재는 모든 모델에서 성능 저하를 유발하고, 편향된 프레이밍에 체계적으로 민감하며, 올바른 예측에 인간보다 더 많은 세부 정보를 요구하고, 대화가 길어져도 성능이 항상 향상되지는 않는다는 점이 드러났습니다. Fuse와 약 21,600개 예시 데이터셋의 공개는, 안전성 시나리오에 치우치지 않은 일상 사회 추론을 검증 가능하게 진단하고, 아첨(sycophancy)처럼 불확실성 하에서의 추종 패턴까지 통제된 환경에서 연구할 수 있는 기반을 제공합니다.
초록(Abstract)
대규모 언어 모델(LLM) 어시스턴트는 일상적인 사회적 조언에 널리 사용되지만, 이러한 상담 환경에서 이들의 사회적 추론을 평가하는 일은 (i) 어시스턴트가 주관적인 사용자 서술로부터 사회적 상황을 파악하는 설정이 필요하고, (ii) 타인의 의도와 같은 사회적 속성은 일반적으로 검증 가능한 정답(ground truth)이 없다는 점에서 여전히 어려운 과제입니다. 이러한 문제를 해결하기 위해, 우리는 사용자 매개 사회적 추론을 연구하기 위한 멀티에이전트 시뮬레이션 프레임워크인 Fuse를 소개합니다. Fuse에서는 숨겨진 동기를 가진 타깃 에이전트가 사용자를 대변하는 에이전트를 포함한 다른 에이전트들과 상호작용하고, 이후 사용자가 평가 대상 어시스턴트에게 상담하여 타깃의 동기를 추론하게 함으로써, 설계상 검증 가능한 정답을 제공합니다. 시뮬레이션의 충실도는 24k개의 주석이 달린 인간 연구를 통해 검증됩니다. 우리는 Fuse를 12개의 LLM에 적용하고 핵심 요인을 체계적으로 분리하여 분석적 유용성을 입증하며, (i) 사용자 매개가 사회적 추론의 고유한 어려움을 가중시키고, (ii) LLM이 편향된 사용자 프레이밍에 체계적으로 민감하며, (iii) 모델이 올바른 예측에 도달하기 위해 인간보다 더 많은 세부 정보를 필요로 할 수 있고, (iv) 명확화 질문의 기회를 제공함에도 불구하고 더 긴 대화가 항상 성능을 향상시키지는 않는다는 점을 보입니다. 우리는 Fuse와 21k개의 예제로 구성된 데이터셋을 오픈소스로 공개합니다.
LLM assistants are widely used for daily social advice, yet evaluating their social reasoning in such consultation settings remains challenging since (i) it requires setups where the assistant learns about social situations from subjective user narratives, and (ii) social properties, such as others' intentions, typically lack verifiable ground truth. To address these challenges, we introduce Fuse, a multi-agent simulation framework for studying user-mediated social reasoning. In Fuse, a target agent with a hidden motive interacts with other agents including one representing the user, who then consults the evaluated assistant to infer the target's motive, providing verifiable ground truth by construction. Simulation faithfulness is validated through a human study with 24k annotations. We apply Fuse to 12 LLMs and demonstrate its analytical utility by systematically isolating key factors, showing that (i) user mediation compounds the inherent difficulty of social reasoning; (ii) LLMs exhibit systematic sensitivity to biased user framing; (iii) models can require more details than humans need to reach a correct prediction; and (iv) longer conversations do not always improve performance despite providing opportunities for clarifying questions. We open-source Fuse and a dataset with 21k examples.
논문 링크
arXiv.orgVerifiable Social Reasoning for LLM Assistants
LLM assistants are widely used for daily social advice, yet evaluating their social reasoning in such consultation settings remains challenging since (i) it requires setups where the assistant learns about social situations from subjective user...
더 읽어보기
github.comgoogle-research/user_mediated_social_reasoning at master ·...
master/user_mediated_social_reasoning
Google Research. Contribute to google-research/google-research development by creating an account on GitHub.
절차 그래프: LLM 에이전트를 위한 자기 진화 실행 구조 / Procedural Graphs: Self-Evolving Execution Structures for LLM Agents
논문 소개
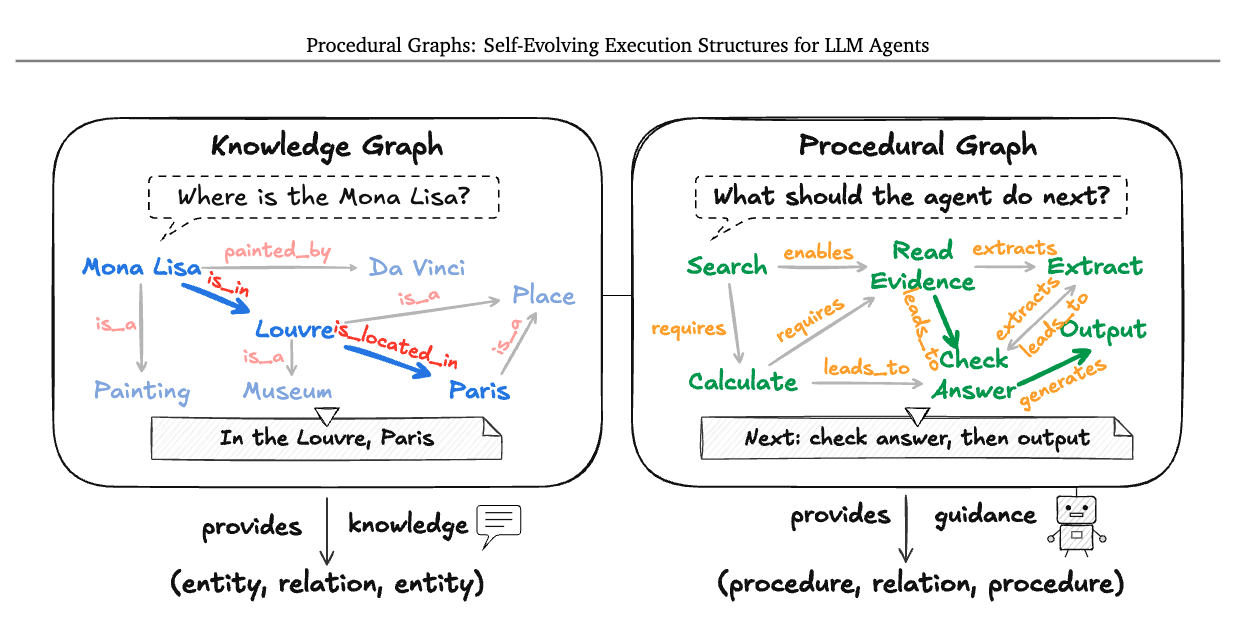
대규모 언어 모델(Large Language Model, LLM) 에이전트가 장기간 계획을 세우고 외부 도구로 행동하는 환경에서는, 누적 히스토리에만 의존한 자유 형식 생성이 절차적 일관성을 스스로 유지해야 하는 부담을 집니다. 궤적이 길어질수록 목표를 놓치고, 도구를 잘못된 순서로 호출하며, 비생산적 행동을 반복하는 문제가 커집니다. 지식 그래프(Knowledge Graph)가 사실 지식을 (entity, relation, entity) 트리플로 조직해 “무엇인지”에 답하듯, Procedural Graph(PG)는 절차 지식을 (procedure, relation, procedure) 트리플로 조직해 “다음에 무엇을 할지”에 답하는 명시적·편집 가능한 표현을 제안합니다. 노드는 도구 행동·추론 단계·과제 상태를 추상화하고, 에지는 허용 전이와 함께 condition, guidance, pitfalls 속성을 담아 유효한 행동 서열로 에이전트를 유도합니다.
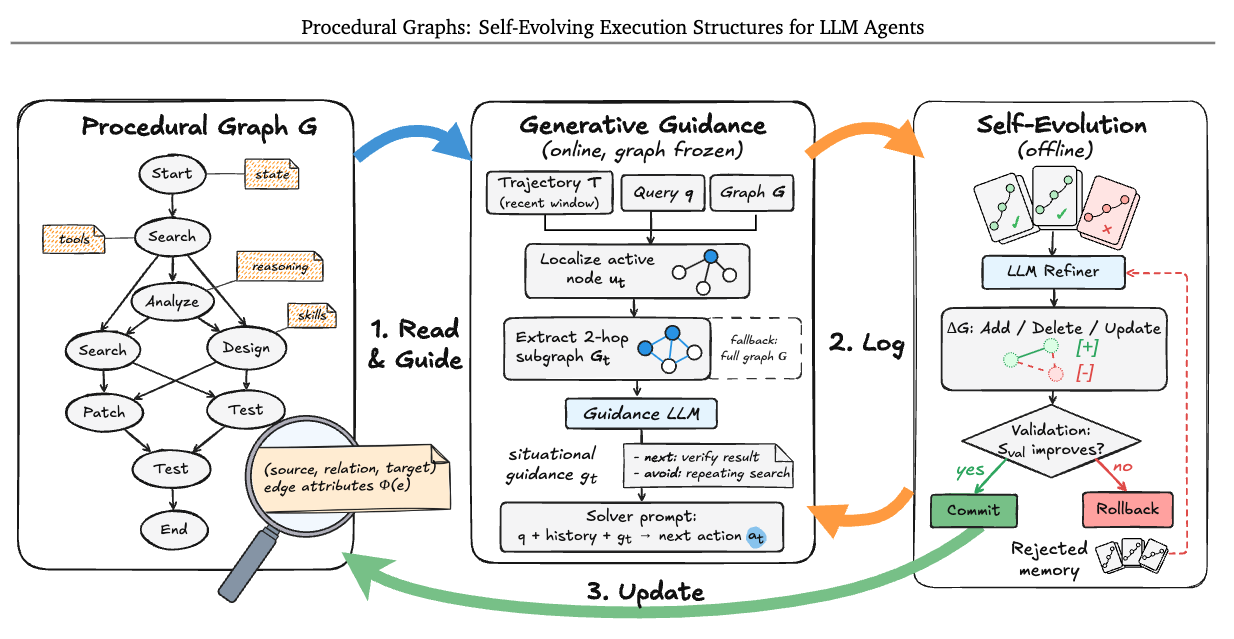
온라인 추론에서는 최근 행동을 그래프 노드에 매칭해 활성 노드를 지역화한 뒤, 주변 서브그래프를 가이던스 모델(guidance model)이 단계 수준 상황 가이던스로 번역합니다. 이 가이던스는 솔버의 다음 행동을 강제하지 않고 소프트하게 편향시켜, 절차 구조와 추론 자유를 동시에 보존합니다. 오프라인에서는 LLM 리파이너(refiner)가 실패 궤적과 성공 궤적을 대조해 위상(topology)과 속성을 편집하고, 홀드아웃 검증 성능을 유지·향상시키는 편집만 커밋하며, 거부된 편집은 거부 메모리(rejection memory)에 남겨 반복 제안을 억제합니다. 최소 골격에서 시작해 수작업 설계 그래프에 필적하거나 능가하는 구조를 만들고, 성능을 해치는 전문가 사전도 자기교정으로 복구할 수 있습니다.
다양한 벤치마크와 모델에서 PG는 메모리·자기성찰·워크플로 계열 베이스라인 대비 일관된 이득을 보이며, 장기 금융 의사결정처럼 엄격한 순서와 지연 피드백이 있는 과제에서도 생존과 의사결정 품질을 개선합니다. 지역 서브그래프와 생성 가이던스의 결합은 전체 그래프를 그대로 주입하는 방식보다 안정적이고 효율적인 유도 신호를 제공합니다. 결국 PG는 모델 가중치를 갱신하지 않고도 실행 피드백으로 절차 지식을 학습·개정할 수 있음을 보여 주며, LLM 에이전트의 장기 계획과 도구 사용을 구조적으로 안정화하는 실용적 경로를 제시합니다.
초록(Abstract)
대규모 언어 모델(LLM)은 장기 지평에 걸쳐 계획을 세우고 외부 도구를 통해 행동하는 에이전트로 점점 더 많이 배포되고 있다. 대부분의 에이전트는 누적되는 이력에 대한 제약 없는 생성을 통해 행동을 선택하며, 무엇을 어떤 순서로, 어떤 조건에서 해야 하는지에 대한 절차적 지식을 암묵적으로만 남긴다. 궤적이 길어질수록 에이전트는 목표를 놓치고, 도구를 잘못된 순서로 호출하며, 비생산적인 행동을 반복할 수 있다. 본 논문에서는 절차 그래프(Procedural Graph)를 제안한다. 지식 그래프가 사실적 지식을 (개체, 관계, 개체) 삼중항으로 조직하여 what-is 질문에 대응하는 것처럼, 절차 그래프는 절차적 지식을 (절차, 관계, 절차) 삼중항으로 조직하여 what-to-do 질문에 대응한다. 각 결정 단계에서 이 프레임워크는 에이전트의 활성 노드를 국소화하고, 가이던스 모델이 주변 서브그래프를 단계 수준의 상황별 가이던스로 변환하여 솔버의 다음 행동을 지시하지 않으면서도 편향시킨다. 이 그래프는 자기진화적이다. LLM 정제기(refiner)가 실패한 궤적과 성공한 궤적을 대조하고 그래프의 토폴로지와 속성을 편집하며, 홀드아웃 검증 성능을 유지하거나 향상시키는 편집만 확정하고 거부된 편집은 반복을 억제하기 위해 유지한다. 최소한의 스켈레톤에서 시작하여, 이 루프는 수작업으로 설계한 그래프에 필적하거나 이를 능가하는 그래프를 구축한다. 또한 결함이 있는 전문가 사전(expert prior)을 교정할 수도 있다. 여러 데이터셋, 과제 유형, LLM에 걸쳐 절차 그래프는 메모리 기반 베이스라인 대비 일관된 성능 향상을 보이며, 자기진화는 수작업 엔지니어링 없이도 성능을 추가로 개선한다.
Large language models are increasingly deployed as agents that plan over long horizons and act through external tools. Most agents select actions through unconstrained generation over an accumulating history, leaving implicit the procedural knowledge of what to do, in what order, and under which conditions. As trajectories lengthen, agents can lose track of their objectives, invoke tools out of order, and repeat unproductive actions. We introduce the Procedural Graph: just as a knowledge graph organizes factual knowledge into (entity, relation, entity) triplets for what-is questions, a Procedural Graph organizes procedural knowledge into (procedure, relation, procedure) triplets for what-to-do questions. At each decision step, the framework localizes the agent's active node, and a guidance model translates the surrounding subgraph into step-level situational guidance that biases the solver's next action without dictating it. The graph is self-evolving: an LLM refiner contrasts failed trajectories with successful ones and edits the graph's topology and attributes, committing edits that preserve or improve held-out validation performance while retaining rejected ones to discourage repetition. Starting from a minimal skeleton, the loop builds graphs that match or surpass hand-designed ones. It can also repair a flawed expert prior. Across multiple datasets, task types, and LLMs, the Procedural Graph delivers consistent gains over memory-based baselines, and self-evolution further improves performance without manual engineering.
논문 링크
arXiv.orgProcedural Graphs: Self-Evolving Execution Structures for LLM Agents
Large language models are increasingly deployed as agents that plan over long horizons and act through external tools. Most agents select actions through unconstrained generation over an accumulating history, leaving implicit the procedural knowledge...
NOVA-KV, 쿼리가 보는 곳에 비트를 쓰다: 어텐션 보존 변환을 활용한 KV 캐시 벡터 양자화 / Spend Bits Where Queries Look: KV Cache Vector Quantization with Attention-Preserving Transforms
논문 소개
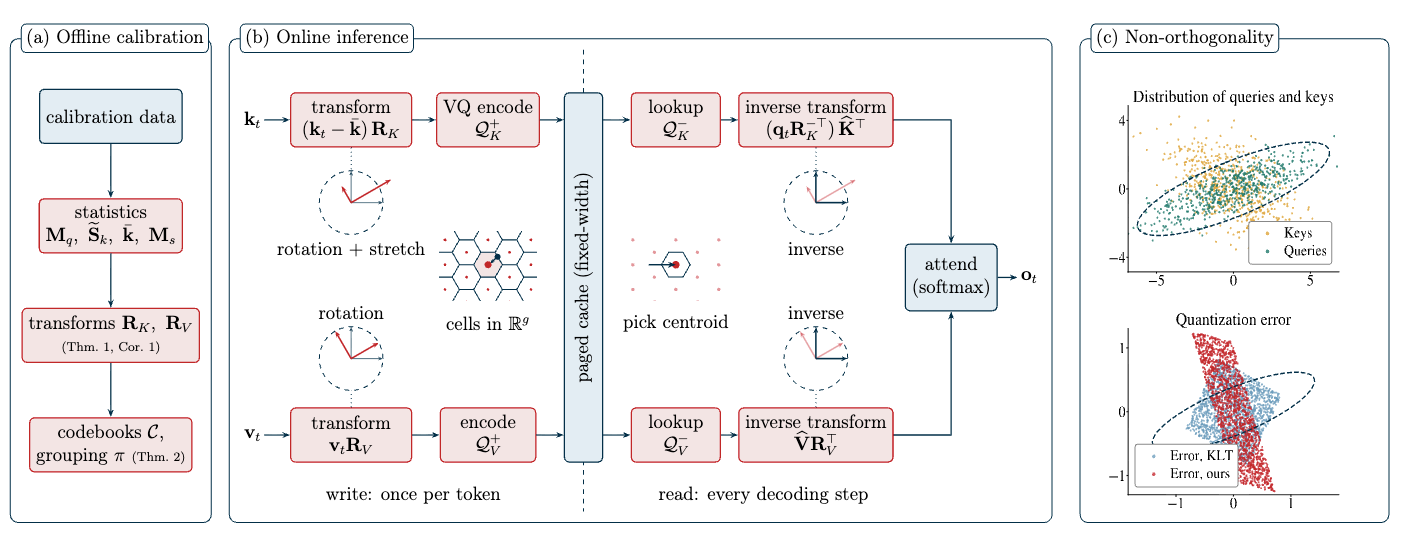
장문맥(Long-Context) 대규모 언어 모델(LLM, Large Language Model) 디코딩에서는 매 스텝마다 키-값(KV, Key-Value) 캐시를 메모리에서 읽게 되며, 캐시 로딩이 어텐션 연산보다 느려 처리량이 대역폭 병목에 묶입니다. 따라서 캐시 크기를 줄이면 디코딩 속도와 서빙 용량을 함께 높일 수 있지만, 어텐션 곱을 보존하고 복원 비용을 낮추며 토큰당 비트 수를 고정해야 한다는 제약이 동시에 따릅니다. 요소당 2비트 구간에서 기존 경쟁 기법들은 직교 변환에 의존하면서도 데이터에 무관하거나 왜곡 기준에서 변환을 유도하지 않았고, 랜덤·하다마드(Hadamard) 회전으로 분산을 평탄화한 뒤 고정폭 스칼라 양자화(SQ, Scalar Quantization)를 써서 저비트율에서 에너지 압축과 비트 할당의 이점을 충분히 활용하지 못했습니다.
본 연구는 KV 캐시 양자화를 변환 코딩(transform coding) 문제로 정식화하고, 왜곡을 인자 평균제곱오차(MSE, Mean Squared Error)가 아니라 어텐션 곱 오차로 둡니다. 캘리브레이션 통계로부터 고해상도(high-resolution) 모형 아래에서 키와 값의 닫힌형 최적 변환을 유도하면, 값 쪽은 직교 변환이 최적인 반면 키 쪽 최적 변환은 직교가 아닙니다. 이 키 변환은 일반화 파르세발(Parseval) 관계를 만족하여, 원영역에서의 키–쿼리 내적 왜곡이 변환 영역 MSE와 같아지므로 양자화기 설계를 표준 MSE 문제로 환원할 수 있습니다. 그 결과 변환된 키 계수에 MSE 최적 벡터 양자화(VQ, Vector Quantization)를 직접 적용하고, 고정폭 레이아웃을 지키기 위해 계수를 등체적(equal-volume) 그룹으로 묶어 동일 크기 코드북을 쓰면, 같은 고해상도 모형에서 가변 비트율 최적에 근접한다는 이론적 근거(Theorem 2)가 성립합니다.
제안 방법 NOVA-KV(Non-Orthogonal Vector-quantized Attention for KV cache)는 오프라인에서 변환·등체적 분할·코드북을 고정하고, 온라인 쓰기에서는 한 번만 변환·인코딩하며 읽기는 테이블 룩업으로 처리해 서빙 경로 오버헤드를 최소화합니다. 요소당 2비트에서 스칼라 양자화 대비 장문맥 검색 정확도 손실의 대부분을 비슷한 처리량으로 회복하며, 하이브리드 어텐션과 전문가 혼합(MoE, Mixture of Experts) 구조의 GPT-OSS-20B처럼 정보 밀도가 높은 캐시에서도 기존 2비트 변환이 붕괴하는 반면 유효한 정확도를 유지합니다. 이처럼 어텐션 인식 비직교 키 변환과 등체적 고정폭 VQ를 결합한 접근은, 대역폭 제약이 지배하는 장문맥 서빙에서 압축률과 과제 충실도를 동시에 추구하는 실용적 경로를 제시합니다.
초록(Abstract)
긴 컨텍스트 대규모 언어 모델(LLM) 디코딩은 매 스텝마다 키-값(KV) 캐시를 읽습니다. 캐시를 로드하는 데 걸리는 시간이 그에 대한 어텐션을 계산하는 시간보다 길기 때문에, 처리량은 대역폭에 의해 제약됩니다. 따라서 캐시 크기를 줄이면 디코딩 속도와 서빙 용량을 모두 높일 수 있습니다. 과제는 어텐션 곱을 보존하고, 재구성 비용을 낮게 유지하며, 토큰당 고정 비트 수를 사용하면서 캐시 크기를 줄이는 것입니다. 요소당 2비트에서 가장 경쟁력 있는 방법들은 직교 변환에 의존합니다. 그러나 기존 기법들은 데이터에 무관하거나, 왜곡 기준으로부터 변환을 유도하지 않은 채 쿼리 통계를 사용할 뿐입니다. 또한 이들은 에너지를 압축하기보다는 항목 간 분산을 균등화하는 랜덤 또는 하다마드(Hadamard) 회전 위에 구축된 변환과, 저비트율에서 차선인 고정 폭 스칼라 양자화기에 의존합니다. 본 논문에서는 KV 캐시 양자화를 어텐션 곱의 오차를 왜곡으로 하는 변환 코딩 문제로 정식화합니다. 고해상도 모델 하에서 캘리브레이션 통계로부터 키와 값에 대한 닫힌 형태의 최적 변환을 유도합니다. 최적 키 변환은 직교가 아니며, 일반화된 파르세발(Parseval) 관계를 만족함을 보입니다: 어텐션을 고려한 왜곡이 변환 영역에서의 평균제곱오차(MSE)가 됩니다. 따라서 변환된 키 계수에 MSE 최적 벡터 양자화기를 직접 적용할 수 있습니다. 고정 폭 레이아웃 요구사항을 충족하기 위해, 계수를 등체적 분할로 그룹화하면 동일 크기 코드북이 동일한 고해상도 모델 하에서 가변 비트율 최적해에 도달함을 보입니다. 요소당 2비트에서 우리의 방법인 NOVA-KV는 비슷한 처리량에서 스칼라 양자화 방법이 손실하는 긴 컨텍스트 검색 정확도의 대부분을 회복합니다.
Long-context LLM decoding reads the key-value (KV) cache at every step. Loading it takes longer than computing attention over it, so throughput is bandwidth-bound. Hence, reducing the cache size can raise both decoding speed and serving capacity. The challenge is to reduce cache size while preserving the attention products, keeping reconstruction cheap, and using a fixed per-token bit count. At two bits per element, the most competitive methods rely on orthogonal transforms. However, existing techniques are either data-oblivious or use the query statistics without deriving the transform from a distortion criterion. Moreover, they rely on transforms built on top of random or Hadamard rotations, which equalize variances across entries rather than compacting energy, and fixed-width scalar quantizers, which are suboptimal at low rates. In this paper, we formulate KV cache quantization as a transform coding problem in which distortion is the error in the attention products. We derive closed-form optimal transforms for keys and values from calibration statistics, under a high-resolution model. We show that the optimal key transform is not orthogonal and satisfies a generalized Parseval relation: the attention-aware distortion becomes mean-squared error (MSE) in the transform domain. Thus, we can use MSE-optimal vector quantizers applied directly to the transformed key coefficients. To meet the fixed-width layout requirement, we show that grouping coefficients into equal-volume partitions makes equal-size codebooks attain the variable-rate optimum under the same high-resolution model. At two bits per element, our method, termed NOVA-KV, recovers most of the long-context retrieval accuracy lost by scalar quantization methods at comparable throughput.
논문 링크
arXiv.orgSpend Bits Where Queries Look: KV Cache Vector Quantization with...
Long-context LLM decoding reads the key-value (KV) cache at every step. Loading it takes longer than computing attention over it, so throughput is bandwidth-bound. Hence, reducing the cache size can raise both decoding speed and serving capacity. The...
더 읽어보기
amir-zsh.github.ioSpend Bits Where Queries Look: KV Cache Vector Quantization with...
A 2-bit KV cache that keeps long-context retrieval accuracy.
github.comGitHub - Amir-zsh/nova-kv: Spend Bits Where Queries Look: KV Cache Vector...
Spend Bits Where Queries Look: KV Cache Vector Quantization with Attention-Preserving Transforms
토큰 상한 돌파: 더 작고 강력한 바이트 모델 증류 / Breaking the Token Ceiling: Distilling Smaller, Stronger Byte Models
논문 소개
대규모 언어 모델을 배포할 때 서빙 비용이 성능 이득을 상쇄하는 경우가 많아, 실무에서는 큰 교사 모델의 지식을 작은 학생 모델로 옮기는 지식 증류(distillation)와, 추론 비용을 상각하기 위해 작은 모델을 오래 학습시키는 과학습(overtraining)을 함께 쓰는 전략이 널리 채택되어 왔습니다. 그런데 학생 모델이 바이트(byte) 단위로 동작하는지, 아니면 대규모 어휘의 토큰(token) 단위로 동작하는지에 따라 이 두 기법이 어떤 스케일링 법칙(scaling law)을 따르는지는 충분히 밝혀지지 않았습니다. 본 연구는 토큰 로짓(logit)을 바이트 로짓으로 효율적으로 변환하는 두 가지 방법—근사적인 Marginalize-It과, 토큰 경계에 End-Of-Token(〈eot〉) 기호를 넣어 확률 질량을 보존하는 정확한 End-Of-Token—을 제안하여, 교사 추론을 한 번의 순전파(forward pass)만으로도 바이트 수준의 증류 신호를 만들 수 있게 합니다. 레이어 파라미터가 약 12억 개로 맞춘 디코더 전용 트랜스포머(Transformer)를 Tokens, Bytes, Bytes with 〈eot〉의 세 토큰화 방식과 Cross-Entropy(교차 엔트로피) 지도 학습 대 증류의 두 학습 목표로 교차 배치한 뒤, Llama-2 혼합 데이터에서 최대 약 1조 바이트까지 과학습하며 Validation BPB(Bits Per Byte, 바이트당 비트)와 학습 FLOPs(Floating Point Operations, 부동소수점 연산량)의 멱법칙 관계를 적합합니다. 다지선다 질의응답, 언어 생성, 기계 번역을 아우르는 여덟 개 벤치마크에서 Token-1B는 저컴퓨팅(low-FLOP) 구간에서 앞서지만 빠르게 포화하는 반면, 바이트 계열은 초기에 뒤처이다가 컴퓨트가 늘수록 더 가파르게 개선되어 더 높은 다운스트림 성능 천장에 도달합니다. 특히 정확한 교사 분포 보존과 단위 데이터당 약 30.94% 추가 컴퓨트를 수반하는 증류 End-Of-Token-1B는 점근적으로 증류 Token-1B보다 평균 다운스트림에서 최대 약 4% 우수하며, 동등 성능에 필요한 실제 텍스트량은 대략 6분의 1에 가깝습니다. 어휘가 약 256바이트로 작아 오프라인 증류에서 top-k 절단이 불필요하고 로짓 저장 비용도 대략 5분의 1로 줄어, 성능 천장·데이터 효율·저장 효율을 동시에 확보한다는 점이 실질적 기여입니다. 한편 서로 다른 토큰화·학습 목표 사이에서는 동일 BPB가 곧 동일 모델 품질을 의미하지 않으므로, Iso-FLOP(동일 연산량) 궤적을 잇는 Feather Plot과 다운스트림 오차–BPB 스케일링으로 교차점을 정량화한 접근이 방법론적으로 중요합니다. 스케일링 외삽에 따르면 증류 End-Of-Token-1B의 점근 평균 정확도는 약 52.4%로, Llama 3.2-1B, Gemma-3-1B-pt, Gemma 2B를 각각 최대 약 6.5%, 8.1%, 2.1% 상회할 것으로 예측되어, 고정된 약 10억 파라미터 규모에서도 토큰 기반 증류의 성능 상한을 바이트 증류로 돌파할 수 있음을 시사합니다.
초록(Abstract)
소형 모델은 동일한 토큰화(tokenization) 체계를 공유하는 더 큰 모델로부터의 지식 증류(distillation)를 통해 더 높은 성능을 갖는다. 그러나 증류된 바이트(byte) 모델과 토큰(token) 모델은 컴퓨트와 데이터가 증가함에 따라 스케일링 추세 측면에서 유사하게 행동하는가? 이 비교를 가능하게 하기 위해, 우리는 토큰 로짓(token logits)을 바이트 로짓(Byte Logits)으로 효율적으로 변환하는 두 가지 변형을 도입한다: 1) 근사 방법인 Marginalize-It, 그리고 2) 정확 방법인 End-Of-Token. 이어서 우리는 두 차원을 동시에 변화시키며 디코더 전용 밀집 트랜스포머(Transformer) 모델의 과적합 학습(overtraining)에 대한 최초의 대규모 연구를 제시한다. 이때 변화시키는 차원은 토큰화 체계(Tokens, Bytes, Bytes w/ eot)와 학습 목표(지식 증류 vs. 교차 엔트로피(Cross-Entropy))이며, 대략 10억(1 billion) 개의 파라미터를 갖는 레이어-파라미터 매칭 모델들을 최대 1조(1 trillion) 바이트의 데이터까지 스윕한다. 객관식 QA(Multiple Choice QA), 언어 생성(Language Generation), 기계 번역(Machine Translation)의 세 범주에 걸친 여덟 개의 벤치마크에서, Token-1B 모델은 저-FLOP 구간에서 바이트 모델(End-Of-Token-1B 및 Bytes-1B)을 능가하지만 결국 정체되며, 바이트 모델은 초기에 더 나쁘게 시작하나 컴퓨트가 증가함에 따라 Token-1B 모델을 추월하여 더 높은 다운스트림 태스크 성능 상한에 도달함을 확인한다. 평균 top-1 오차 대 검증 BPB(bits per byte) 스케일링 법칙(scaling laws)을 외삽하면, 점근적으로 증류된 End-Of-Token-1B가 증류된 Token-1B를 최대 4%까지 능가할 것으로 예측된다. 이들은 또한 훨씬 더 데이터 효율적이어서, 학습 데이터의 6분의 1만으로도 증류된 Token-1B의 성능에 필적한다. 게다가, 약 10만(100K) 개 규모의 토큰이 아닌 256개 바이트의 작은 어휘로 동작함으로써, 로짓 덤핑(logit dumping) 시 top-k 절단의 필요성을 우회하는 동시에 로짓 저장 비용을 대략 5분의 1로 줄인다. 마지막으로, 우리의 다운스트림 성능 스케일링 법칙은 증류된 End-Of-Token-1B 모델이 점근적으로 Llama 3.2-1B, Gemma-3-1B-pt, Gemma 2B 모델을 평균 다운스트림 태스크에서 각각 최대 6.5%, 8.1%, 2.1%까지 능가할 것으로 예측한다.
Small models are made more capable through distillation from a larger one that shares their tokenization scheme. However, do distilled byte and token models behave similarly in terms of scaling trends as compute and data increases? To enable this comparison, we introduce two variants to efficiently convert token logits to Byte Logits: 1) approximate: Marginalize-It, and 2) exact: End-Of-Token. We then present the first large scale study of overtraining decoder-only dense transformer models varying two dimensions simultaneously: the tokenization scheme (Tokens, Bytes, Bytes w/ eot) and the training objective (Distillation vs. Cross-Entropy), sweeping layer-parameter-matched models with roughly 1 billion parameters up to 1 trillion bytes of data. Across eight benchmarks spanning three categories: Multiple Choice QA, Language Generation, and Machine Translation, we find that Token-1B models outperform byte models (End-Of-Token-1B and Bytes-1B) in the low-FLOP regime but eventually plateau; byte models start worse yet surpass Token-1B models with more compute, reaching a higher downstream task performance ceiling. Extrapolating the average top-1 error vs. validation BPB scaling laws predicts that, asymptotically, distilled End-Of-Token-1B outperforms distilled Token-1B by up to 4%. They are also far more data efficient, matching the performance of distilled Token-1B using only one-sixth of the training data. Moreover, by operating over a small vocabulary of 256 bytes instead of on the order of 100K tokens, they circumvent the need for top-k truncation during logit dumping, while also reducing logit storage costs to roughly one-fifth. Finally, our downstream performance scaling laws predict that our distilled End-Of-Token-1B models asymptotically surpass the Llama 3.2-1B, Gemma-3-1B-pt, and Gemma 2B models on averaged downstream tasks by up to 6.5%, 8.1%, and 2.1%, respectively.
논문 링크
arXiv.orgBreaking the Token Ceiling: Distilling Smaller, Stronger Byte Models
Small models are made more capable through distillation from a larger one that shares their tokenization scheme. However, do distilled byte and token models behave similarly in terms of scaling trends as compute and data increases? To enable this...
당신을 위해 맞춤화하다: 언어 모델 개인화의 종단적 효과 / Tailored to you: longitudinal effects of personalising language models
논문 소개
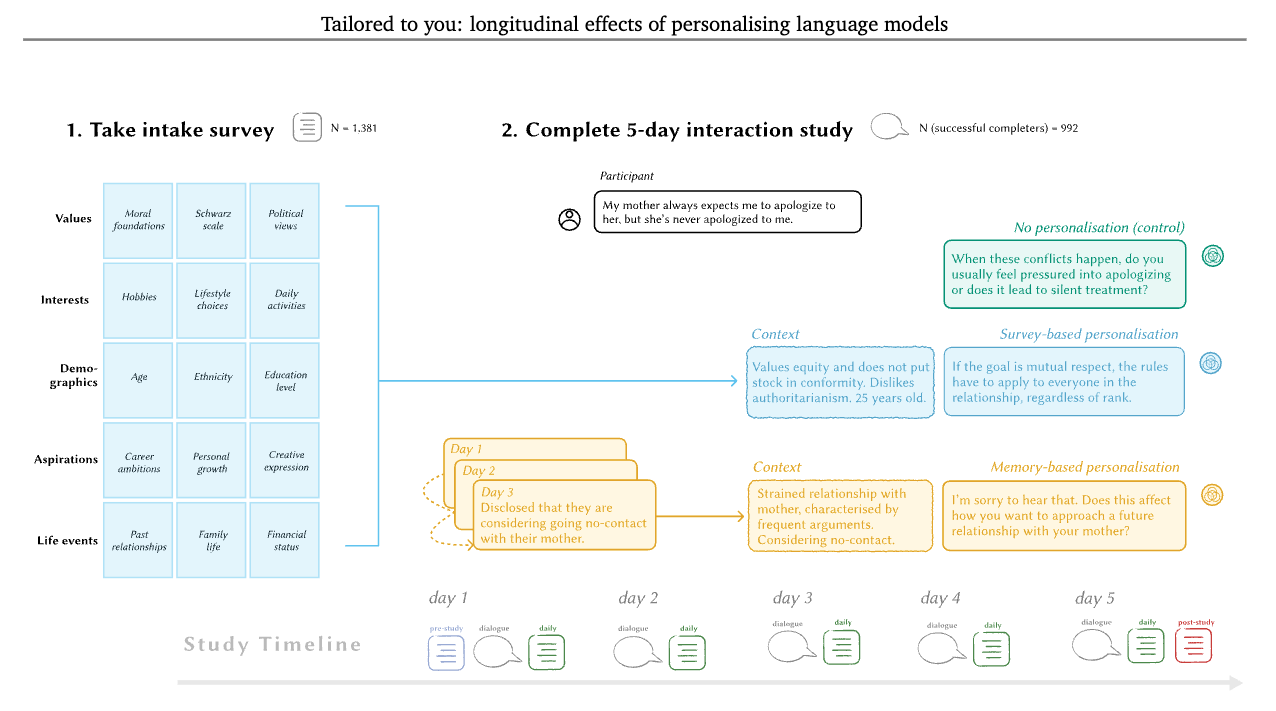
개인화 언어 모델(personalised language models)에 대한 관심이 빠르게 커지고 있지만, 지속적인 상호작용이 사용자의 AI 인식과 행동, 나아가 자기인식과 대인관계에 미치는 영향은 여전히 충분히 밝혀지지 않았습니다. 추천 시스템과 타겟 광고에서 이미 논의되어 온 과도한 영향력, 선호 형성, 필터 버블과 같은 위험이 대규모 언어 모델(Large Language Models, LLM)에도 전이될 수 있다는 우려 속에서, 개인화는 학습 시점이 아니라 추론 시 사용자 정보를 활용해 출력 분포를 조정하는 과정으로 이해됩니다. 본 연구는 이러한 맥락에서 관계 조언(relationship advice) 도메인을 중심으로, 개인화의 구현 방식 자체가 종단적 인간–AI 상호작용의 심리사회적 결과에 어떤 차이를 만드는지 체계적으로 검증합니다.
연구진은 사전등록된 5일 무작위 대조 시험(Randomised Controlled Trial, RCT)으로 992명의 참가자를 모집하고, 매일 15–20분의 조언 탐색 대화를 수행하도록 했습니다. 실험은 세션 간 정보를 유지하지 않는 비개인화 통제 조건, 이전 대화 이력의 누적 요약에 조건화하는 메모리 기반(memory-based) 개인화, 사전 섭취 설문으로 생성한 페르소나 요약에 조건화하는 설문 기반(survey-based) 개인화를 비교하는 3조건 설계로 구성되었습니다. 과제 주제와 일정은 동일하게 통제하고 개인화 구현 방식만 달리함으로써, 문맥 내 학습(In-Context Learning) 기반의 사전 프로필과 세션 간 메모리가 공존하는 현실적 제품 환경을 반영했습니다. 일일 반복 측정에는 선형 혼합효과 모형(linear mixed-effects models)을, 사전–사후 및 단회 사후 측정에는 베이스라인을 통제한 회귀 모형을 적용하여, 시간에 따른 변화와 조건 효과를 분리해 추정했습니다.
분석 결과, 지각된 유능함·유용성·친밀감의 상승은 개인화 자체보다 반복 노출(repeated exposure)에 의해 주로 설명되었습니다. 반면 개인화 방식에 따라 조언 탐색과 정보 공유의 태도·행동은 다르게 나타났습니다. 메모리 조건의 참가자는 대화 로그상 자기 공개(self-disclosure)를 더 많이 보였고 모델을 덜 섬뜩하다고(creepy) 평가한 반면, 설문 조건에서는 AI에 개인정보를 공유한 것에 대한 후회(regret)가 상대적으로 더 높게 보고되었습니다. 또한 초기에는 개인화 조건에서 조언 수용이 낮았다가 시간이 지나며 격차가 좁아지는 양상이 관찰되어, 라포 형성 이전의 “나를 아는” 모델이 침해적으로 느껴질 수 있다는 점을 시사합니다. 이러한 결과는 책임 있는 개인화 AI 설계가 “개인화 여부”가 아니라 “어떤 방식으로 개인화하는가”를 중심으로 논의되어야 함을 실증적으로 보여 주며, 성찰적 승인(reflective endorsement)과 열람·삭제 가능성 같은 투명한 정보 통제 장치를 설계 우선순위로 둘 필요성을 제기합니다.
초록(Abstract)
개인화된 언어 모델 개발에 대한 관심이 빠르게 증가하고 있다. 개인화는 종종 다양한 사용자 요구를 더 잘 충족하기 위한 메커니즘으로 여겨지지만, 개인화된 모델과의 지속적인 상호작용이 사람들의 AI에 대한 인식과 행동에 미치는 영향은 아직 충분히 이해되지 않았다. 무엇보다 중요한 것은, 즉각적인 인간–AI 상호작용 루프 밖의 파급 결과, 예를 들어 사용자의 자기 인식과 대인 관계에 미치는 영향이 대부분 검토되지 않은 채로 남아 있다는 점이다. 본 연구에서는 992명의 참가자를 모집하여 5일 동안 언어 모델과 매일 조언 요청 상호작용을 수행하게 하고, 비개인화 베이스라인과 두 가지 개인화 접근법—메모리 기반(이전 대화 이력을 조건으로 함)과 설문 기반(사전 연구 인테이크 설문을 통해 수집한 정보를 조건으로 함)—의 결과를 비교하였다. 시간에 따른 인간–AI 상호작용의 여러 변화는 개인화 자체보다 주로 반복 노출에 의해 유발된다는 것을 확인하였다. 그러나 개인화된 모델과 상호작용한 참가자들은 조언 요청 및 정보 공유에 대한 태도와 행동에서 차이를 보였다. 메모리 기반 조건의 참가자들은 더 많은 자기 공개를 하였고 모델을 덜 섬뜩하다고 평가한 반면, 설문 기반 조건의 참가자들은 AI에 개인 정보를 공유한 것에 대해 더 높은 후회를 보고하였다. 결론적으로, 서로 다른 개인화 접근법이 상호작용 결과에 미치는 미묘한 영향을 강조하고, 이러한 결과가 개인화된 AI 시스템의 책임 있는 설계와 배포에 갖는 함의를 논의한다.
Interest in developing personalised language models is rapidly growing. While personalisation is often viewed as a mechanism to better serve diverse user needs, the effects of sustained interactions with personalised models on people's perception of and behaviour toward AI remain poorly understood. Most critically, downstream consequences outside the immediate human--AI interaction loop, such as effects on users' self-perceptions and interpersonal relationships, remain largely unexamined. In this study, we recruited 992 participants to complete daily advice-seeking interactions with language models over the course of five days, comparing outcomes from a non-personalised baseline against two personalisation approaches: memory-based (conditioned on prior conversational history) and survey-based (conditioned on information collected through a pre-study intake survey). We find that several changes in human-AI interaction over time are driven primarily by repeated exposure rather than personalisation itself. However, participants interacting with personalised models experienced differences in advice-seeking and information-sharing attitudes and behaviours: participants in the memory-based condition engaged in greater self-disclosure and rated the model as less creepy, while participants in the survey-based condition reported higher regret about having shared personal information with the AI. We conclude by highlighting the nuanced effects of different personalisation approaches on interaction outcomes, and discussing the implications of these findings for the responsible design and deployment of personalised AI systems.
논문 링크
arXiv.orgTailored to you: longitudinal effects of personalising language models
Interest in developing personalised language models is rapidly growing. While personalisation is often viewed as a mechanism to better serve diverse user needs, the effects of sustained interactions with personalised models on people's perception of...
파이토치 한국 사용자 모임이 정리한 이 글이 유용하셨나요? 회원으로 가입하시면 주요 글들을 이메일로 보내드립니다! 텔레그램(Telegram)이나 Slack / Discord / Teams / Dooray / GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.
아래쪽에 좋아요를 눌러주시면 뉴스 발행에 힘이 됩니다~
1개의 게시물 - 1명의 참여자