

R4T(Retrieve-for-Train): RL로 찾은 질의 팬아웃(fan-out) 행동을 경량 확산 검색기(Diffusion Model)로 컴파일하는 연구
R4T(Retrieve-for-Train) 논문 소개
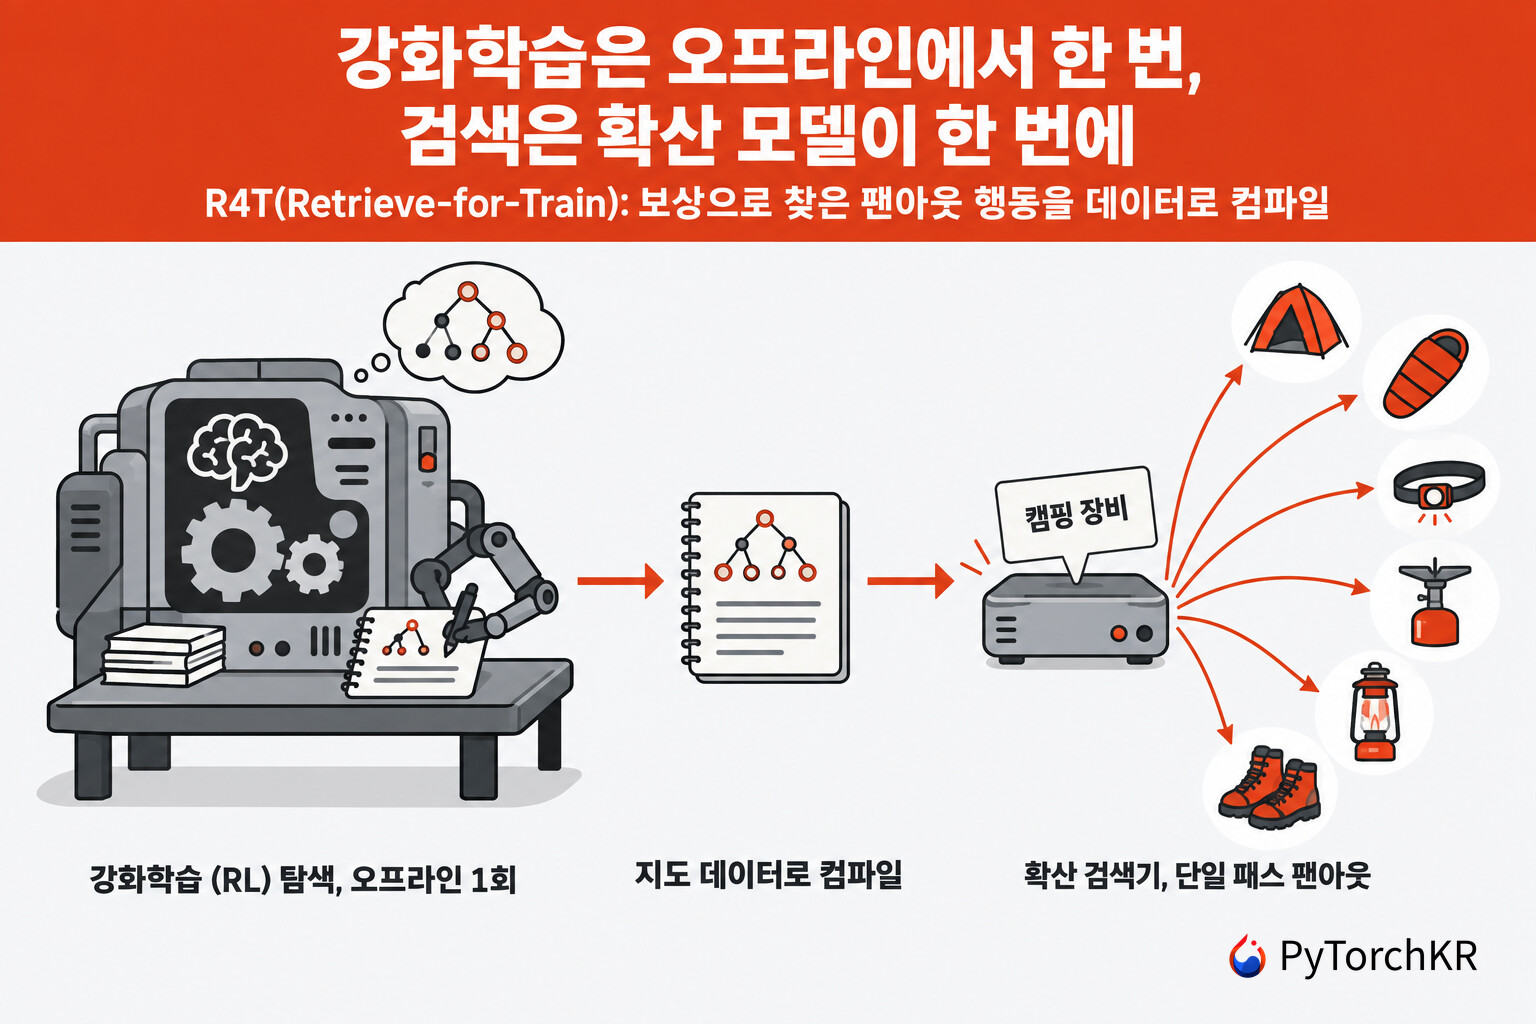
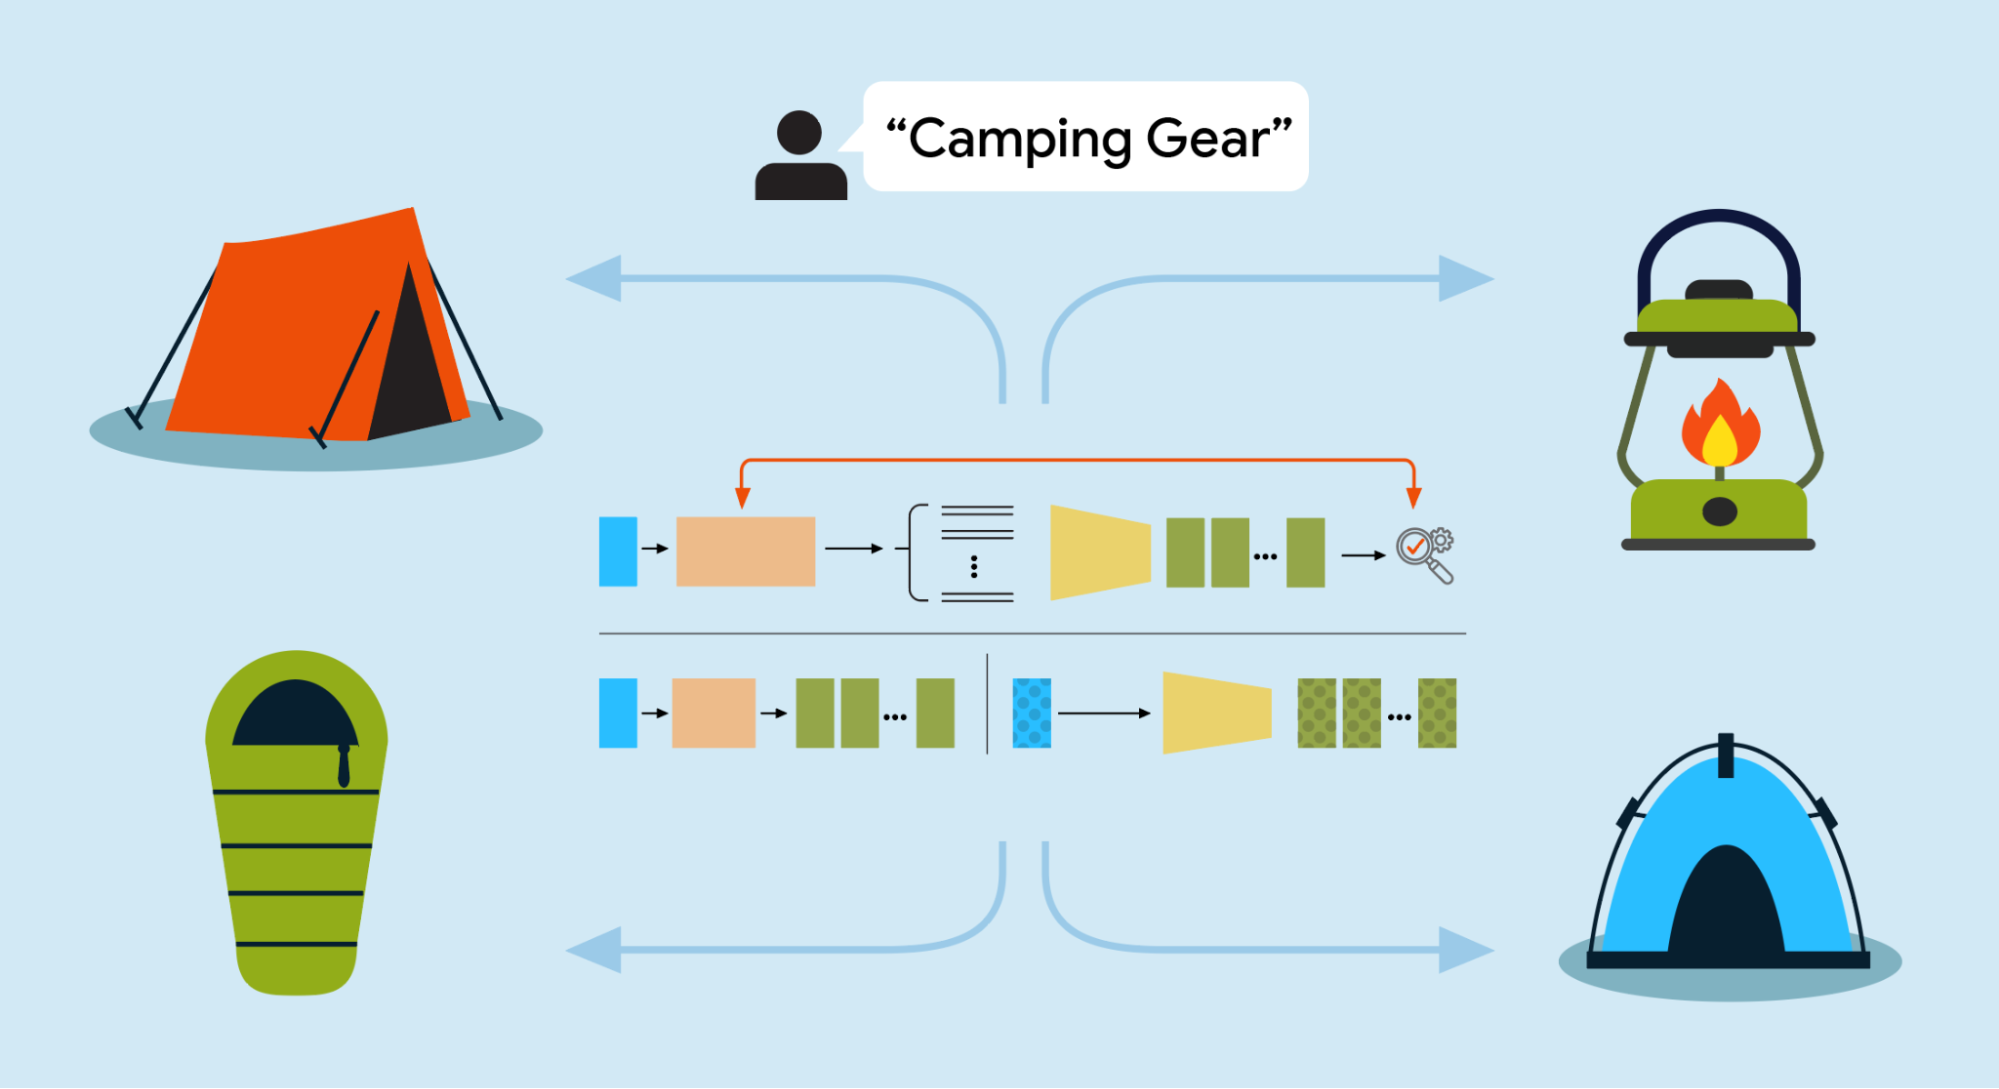
검색창에 "캠핑 장비"라고 입력한 사용자가 기대하는 결과는 4인용 텐트 열 개가 아닙니다. 텐트, 침낭, 버너, 헤드램프처럼 서로 보완하는 물건들이 한 묶음으로 나와야 합니다. Google Research와 일리노이 대학교(UIUC) 연구팀이 ICML(International Conference on Machine Learning) 2026에서 발표한 R4T(Retrieve-for-Train) 논문은 이렇게 결과 하나가 아니라 결과 집합(Set) 의 품질이 중요한 검색 문제를 다룹니다. 이 논문은 강화학습(Reinforcement Learning, RL)을 추론(Inference) 시점의 엔진으로 배포하는 대신, 학습 데이터를 만드는 1회성 도구로 쓰는 방법을 제안합니다. RL로 찾아낸 좋은 질의 분해 행동을 합성 데이터로 컴파일하고, 그 데이터로 53.9M 파라미터의 작은 확산 모델(Diffusion Model)을 학습해 추론 시에는 단일 패스(Single Pass)로 결과 집합을 생성합니다. 이번 글에서는 논문과 Google Research 블로그 글을 함께 읽고 배경, 방법론, 실험 결과를 정리하려고 합니다.
결과 하나가 아니라 결과 집합을 돌려줘야 하는 검색
검색 시스템과 추천 시스템은 점점 더 가장 잘 맞는 결과 하나가 아니라, 함께 놓았을 때 좋은 결과 여러 개를 요구받고 있습니다. 검색 인터페이스는 넓은 질의를 여러 의도로 확장해 커버리지(Coverage)를 높여야 하고, 추천 시스템은 다양하면서도 일관된 슬레이트(Slate, 한 화면에 함께 노출되는 결과 묶음)를 만들어야 하며, 번들 구성 시스템은 서로 보완하는 품목을 모아야 합니다. 이런 요구는 후보를 단순히 골라내는(select) 대신 모델이 후보를 생성하는 생성형 검색(Generative Retrieval) 접근으로 이어졌습니다. DSI(Differentiable Search Index)처럼 문서 식별자를 직접 생성하는 방식이 대표적입니다.
문제는 이런 과제의 품질 기준이 집합 수준(Set-level) 에 있고, 분해되지 않는(Non-decomposable) 다는 점입니다. 다양성, 의도 커버리지, 보완성, 스타일 일관성은 결과 하나를 보고 매길 수 있는 점수가 아니라 집합 전체를 놓고 봐야 정의되는 성질입니다. 게다가 정답이 하나로 정해지지 않습니다. "보헤미안 페스티벌 스타일"이라는 질의에 대해 서로 다른 여러 결과 집합이 모두 정답일 수 있습니다. 그래서 기존의 지도학습(Supervised Learning) 데이터셋처럼 (질의, 콘텐츠) 쌍을 모아 top-1 검색을 학습시키는 방식으로는 이 성질을 담을 수 없고, 집합 수준 성질을 반영한 (질의, 콘텐츠) 쌍을 사람이 라벨링하는 것은 비용이 크고 주관적이며 도메인 특화 코퍼스에서는 거의 불가능합니다.
실무에서는 이 문제를 질의 팬아웃(Query Fan-out) 으로 풉니다. 넓은 질의 하나를 여러 하위 질의(Sub-query)로 나눠 각각 검색하고 결과를 합치는 방식으로, Google이 AI Mode 검색에 적용했다고 소개한 기법이기도 합니다. R4T 논문이 다루는 것은 바로 이 팬아웃을 누가, 어떤 비용으로, 어떤 목표에 맞춰 수행하는가의 문제입니다.
기존 접근법 1: 제로샷 LLM 팬아웃
가장 손쉬운 방법은 기성 LLM에 "이 질의를 10개의 하위 질의로 나눠라"라고 시키는 것입니다. 그러나 연구팀은 블로그에서 여기에 두 가지 구조적 문제가 있다고 지적합니다. 첫째는 의역 붕괴(Paraphrastic Collapse) 입니다. 데이터베이스를 모르는 제로샷(Zero-shot) LLM은 주제의 서로 다른 측면을 탐색하는 대신 거의 같은 뜻의 질의를 반복해서 만듭니다. "Bohemian festival style"을 넣으면 "bohemian festival fashion", "bohemian festival clothes"가 나오는 식이어서, 패션 전문가라면 떠올릴 프린지 재킷, 크로셰 드레스, 스웨이드 부츠 같은 갈래를 찾아내지 못합니다. 연구팀도 실험에서 제로샷 팬아웃의 하위 질의가 데이터베이스 매니폴드(Manifold) 바깥으로 벗어나거나 거의 같은 표현으로 붕괴해 근거성(Groundedness)이 낮고 결과가 중복된다고 보고합니다.
둘째는 자기회귀(Autoregressive) 지연 병목입니다. 복잡한 질의를 보완적인 갈래로 분해하려면 최신 모델은 사고 연쇄(Chain-of-Thought, CoT) 토큰을 수백 개 생성하며 계획을 세워야 하는데, 이는 토큰 단위 순차 생성이라 결과 집합의 크기가 커질수록 비용이 나쁘게 늘어납니다. 대화형 AI에서는 감내할 수 있는 지연이지만, 1초 미만 응답이 요구되는 검색창에서는 구조적으로 맞지 않는 하한선이 됩니다.
기존 접근법 2: RL로 미세조정한 LLM을 그대로 배포
집합 수준 목표를 보상(Reward)으로 정의할 수 있다면, 데이터베이스와 상호작용하며 그 보상을 최대화하는 RL이 자연스러운 선택입니다. 실제로 첫 저자 Pengcheng Jiang이 참여한 DeepRetrieval과 s3는 RL로 실제 검색 엔진과 상호작용하는 검색 에이전트를 학습시켜, 보상 기반 최적화가 점 단위 관련성(Pointwise Relevance)을 넘어선 검색 목표를 담을 수 있음을 보였습니다.
그러나 RL로 학습한 언어 모델을 추론 시점에 그대로 배포하는 것은 다른 문제입니다. 자기회귀 팬아웃 생성과 반복적인 검색 호출은 상당한 지연을 만들고, 집합 수준 보상은 분산이 크며 지름길 악용(Shortcut Exploitation)에 취약합니다. 저자들은 이 두 가지가 안정적인 배포를 어렵게 만들며, 보상 기반 최적화와 추론 시점 검색을 분리해야 할 이유가 된다고 설명합니다.
기존 접근법 3: 확산 기반 생성 검색
한편 임베딩 공간에서 비자기회귀(Non-autoregressive) 샘플링을 수행하는 확산 기반 생성 검색도 등장했습니다. 음악 검색에 확산 사전분포(Diffusion Prior)를 적용한 Diff4Steer와 텍스트-음악 검색용 GD-Retriever가 대표적입니다. 이 계열은 검색을 잡음 제거(Denoising) 과정으로 모델링해 슬레이트나 번들 전체를 단일 패스로 생성할 수 있습니다. 저자들은 이를 무겁고 순차적인 "System 2" 생성에서 병렬적인 "System 1" 샘플링으로의 전환이라고 표현합니다.
다만 확산 검색기는 성질에 맞춰 정렬된 학습 타깃(Property-aligned Training Targets) 을 대량으로 필요로 합니다. 그리고 그 타깃이야말로 분해되지 않는 집합값 검색 과제에서 가장 부족하고 애매한 자원입니다. 빠르게 생성할 수는 있는데, 무엇을 생성하도록 가르칠 데이터가 없는 상황입니다.
발상의 전환: RL을 목적 변환기로
R4T의 핵심 아이디어는 위 두 접근법의 약점이 서로의 강점으로 채워진다는 관찰에서 나옵니다. RL은 복잡한 집합 수준 목표를 최적화할 수 있지만 배포가 비싸고, 확산 검색기는 배포가 싸지만 학습 데이터가 없습니다. 그렇다면 RL을 배포용 추론 메커니즘이 아니라, 복잡한 보상 명세를 확장 가능한 지도 데이터로 바꿔 주는 1회성 목적 변환기(Objective Transducer)로 쓰면 됩니다. 블로그는 이를 "보상을 데이터로 컴파일하는(reward-to-data compilation)" 프레임워크라고 부릅니다.
연구팀이 든 비유를 옮기면, 사용자가 기다리는 동안 매번 시험을 치르게 하는 대신 오프라인 연습 시간을 한 번 갖게 하는 것입니다. 추상적인 목표("결과가 다양하고 실제로 재고에 있어야 한다")를 엄격한 보상 체계로 명시해 RL을 한 번 실행하고, 그 결과를 단계별 지침서처럼 데이터로 만들어 둔 뒤, 실제 검색에서는 그 지침서를 즉시 실행하는 구조입니다.
실험 결과를 미리 말씀드리면, R4T는 패션 데이터셋 Polyvore와 비공개 음악 플레이리스트 데이터셋에서 같은 기본 모델 계열의 제로샷 팬아웃과 Best-of-N 기준선(Baseline)을 모두 앞섰고, 확산 검색기 변형은 자기회귀 LLM 팬아웃 대비 12\times 에서 20\times 의 지연 단축을 달성했습니다.
R4T의 방법론: 보상을 데이터로 컴파일하는 세 단계
문제 정의: 집합값 팬아웃 검색
R4T가 다루는 문제를 먼저 형식화하겠습니다. 넓은 질의 q 가 주어지면 시스템은 고정된 데이터베이스 \mathcal{D} 에서 결과 집합을 돌려줘야 합니다. 팬아웃 형식에서는 정책(Policy)이 먼저 k 개의 하위 질의 Q = \{q_1, \ldots, q_k\} 를 생성하고, 고정된 검색기 R(\cdot) 가 각 하위 질의를 실행해 후보 \mathcal{C}_i = R(q_i, \mathcal{D}) 를 가져옵니다. 최종 결과는 이들의 합집합 \mathcal{R}(Q) = \bigcup_{i=1}^{k} \mathcal{C}_i 입니다.
핵심 가정은 결과의 품질이 다양성, 커버리지, 보완성 같은 집합 수준 성질로 정의되고, 이 성질이 일반적으로 분해되지 않으며, 정답이 하나가 아니라 여럿이라는 것입니다. 마지막 성질 때문에 정답 라벨(Ground Truth) 기반 지도학습이 어려워집니다.
전체 구조와 두 가지 배포 변형
R4T는 세 단계로 구성됩니다. 첫째는 RL 정책 최적화로, 하위 질의를 생성하는 팬아웃 언어 모델(Fan-Out Language Model, FOLM) \pi_\theta 를 학습해 데이터베이스와의 상호작용 결과가 과제별 집합 수준 보상을 최대화하도록 만듭니다. 둘째는 합성 지도 데이터(Synthetic Supervision) 생성으로, 최적화된 FOLM을 실행해 고보상 궤적을 모으고 이를 집합값 타깃 데이터셋으로 바꿉니다. 셋째는 컴파일된 배포로, 질의가 주어졌을 때 집합값 타깃의 조건부 분포를 모델링하는 경량 생성형 검색기를 그 데이터로 학습해 추론 시 단일 패스 팬아웃을 가능하게 합니다.
이 구조에서 눈여겨볼 점은 RL 단계를 공유하면서 추론 시점의 실행 방식만 다른 두 배포 변형을 함께 평가한다는 것입니다.
- R4T-FOLM: RL로 최적화한 FOLM \pi_{\theta^\ast} 를 추론 시점에 그대로 배포합니다. k 개의 하위 질의를 자기회귀로 생성하고 각각 검색해 합칩니다. 보상 최적화된 팬아웃의 품질을 그대로 반영하지만, 자기회귀 생성과 반복 검색 호출 비용을 그대로 부담합니다.
- R4T-Diffusion: FOLM의 보상 정렬 행동을 합성 데이터로 학습한 경량 확산 모델 D_\phi 에 증류(Distillation)합니다. 추론 시 D_\phi 는 질의 임베딩 z_q 에서 L 개의 검색 방향 \mathbf{Z}_0 \sim p_\phi(\mathbf{Z} \mid z_q) 를 비자기회귀 단일 패스로 생성하고, 이를 최근접 이웃(Nearest Neighbor) 검색으로 데이터베이스 콘텐츠에 대응시킵니다.
두 변형을 나란히 두면 보상 최적화된 팬아웃이 주는 이득과 그것을 배포하는 비용을 분리해서 볼 수 있고, RL이 발견한 행동이 효율적인 추론 형태로 증류될 수 있는지를 직접 검증할 수 있습니다.
집합 수준 보상 설계
R4T의 성패는 좋은 검색 행동을 보상으로 어떻게 정의하느냐에 달려 있습니다. 연구팀은 집합값 검색의 대표적인 두 상황을 설정하고 각각에 맞는 보상을 설계했습니다.
개방형 추상 검색(OAR)의 복합 보상
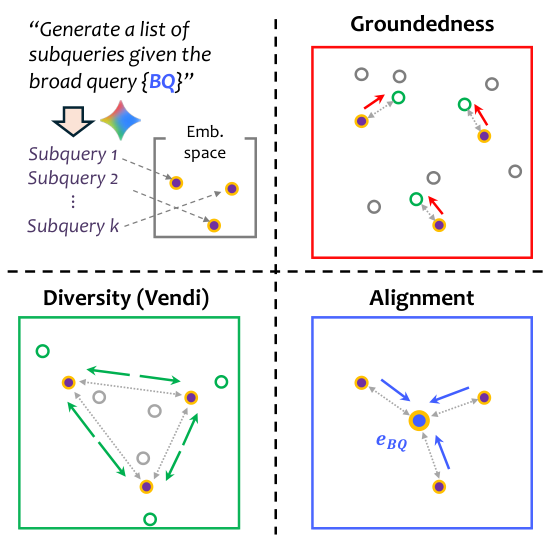
개방형 추상 검색(Open-Ended Abstract Retrieval, OAR) 은 정답 집합이 아예 존재하지 않는 탐색적 상황입니다. "bohemian festival style"처럼 테마나 시나리오를 나타내는 넓은 질의가 주어지면, 여러 해석을 아우르는 다양한(Diverse) 컬렉션 수준 결과를, 질의와 잘 정렬(Aligned)되고, 데이터베이스에 근거한(Grounded) 형태로 가져와야 합니다. 이 세 성질을 각각 부분 보상으로 두고 가중합한 복합 보상이 다음과 같습니다:
\mathcal{R}_{\text{abs}}(q, Q) = \lambda_g\, r_{\text{ground}}(Q) + \lambda_d\, r_{\text{div}}(Q) + \lambda_a\, r_{\text{align}}(q, Q)다양성(Diversity) 은 각 하위 질의의 대표 검색 결과(예: top-1 항목) c_i^\star 의 콘텐츠 임베딩에 대해 Vendi Score를 계산해 측정합니다. Vendi Score는 유사도 행렬의 고유값 엔트로피로 정의되는 다양성 지표로, 참조 데이터 없이도 집합 내부의 의미적 폭을 잴 수 있습니다:
r_{\text{div}}(Q) = \text{Vendi}\left(\{ e_{\text{content}}(c_i^\star) \}_{i=1}^{k}\right)근거성(Groundedness) 은 하위 질의가 임베딩 공간이 만드는 데이터베이스 매니폴드 위에 머물도록, 각 하위 질의 임베딩과 데이터베이스 안 최근접 이웃 사이의 거리에 벌점을 줍니다:
r_{\text{ground}}(Q) = 1 - \frac{1}{k} \sum_{i=1}^{k} \min_{c \in \mathcal{D}} \left\| e_{\text{text}}(q_i) - e_{\text{content}}(c) \right\|_2정렬(Alignment) 은 하위 질의가 원 질의 q 의 의도에서 멀어지는 의미 표류(Semantic Drift)를 막기 위해, 각 하위 질의 임베딩과 원 질의 임베딩의 코사인 유사도(Cosine Similarity) 평균으로 정의합니다:
r_{\text{align}}(q, Q) = \frac{1}{k} \sum_{i=1}^{k} \cos\left(e_{\text{text}}(q_i),\, e_{\text{text}}(q)\right)기본 가중치는 \lambda_g = 0.6, \lambda_d = \lambda_a = 0.2 입니다. 세 항이 서로를 견제하는 구조라는 점이 중요한데, 이 부분은 뒤의 보상 해킹(Reward Hacking) 절제 실험에서 다시 다루겠습니다.
약지도 조합 검색(WSCR)의 커버리지 보상
약지도 조합 검색(Weakly Supervised Compositional Retrieval, WSCR) 은 질의마다 여러 유효한 항목 집합이 있을 수 있지만, 그중 하나의 그럴듯한 실현을 담은 약한 참조 집합(Weak Reference Set) \mathcal{Y} = \{y_1, \ldots, y_m\} 이 주어지는 상황입니다. Polyvore의 코디(outfit) 하나가 그런 참조 집합입니다. 중요한 점은 \mathcal{Y} 를 유일한 정답으로 보지 않는다는 것입니다.
이 경우의 보상은 참조 집합을 팬아웃 결과가 얼마나 덮었는지로 정의합니다:
\mathcal{R}_{\text{set}}(q, Q; \mathcal{Y}) = \frac{|\mathcal{Y} \cap \mathcal{R}(Q)|}{|\mathcal{Y}|}이 보상은 정책이 고정된 타깃을 암기하는 대신, 합집합이 참조 집합에 반영된 서로 다른 의미 구성요소를 아우르도록 보완적인(Complementary) 하위 질의를 만들게 유도합니다. 상의, 하의, 신발, 액세서리를 각각 겨냥한 하위 질의를 만들어야 코디 전체를 덮을 수 있기 때문입니다.
1단계: 소프트 PPO 정규화를 더한 GRPO로 팬아웃 LM 학습
R4T의 첫 단계는 FOLM의 RL 학습입니다. 입력 질의 q 에 대해 FOLM \pi_\theta 가 하위 질의 집합 Q 를 생성하고, 고정된 밀집 검색기(Dense Retriever) R(\cdot) 가 이를 실행해 후보 문서를 가져오며, 위에서 정의한 과제별 보상이 샘플된 팬아웃 출력 하나하나에 매겨집니다. 이번 논문에서 FOLM은 Gemma3-4B와 Qwen3-4B 두 가지 4B 규모 오픈 모델의 명령 조정(Instruction-tuned) 체크포인트에서 시작하며, 질의마다 k = 10 개의 하위 질의를 생성합니다. 부록에 공개된 프롬프트는 <think> 태그 안에 사고 과정을 쓰고 <queries> 태그 안에 최대 10개의 질의를 JSON 배열로 내도록 요구합니다.
정책 최적화에는 GRPO(Group Relative Policy Optimization) ( GRPO:Zero, GRPO를 간단하고 효율적으로 구성한 LLM용 강화학습 프레임워크)를 씁니다. 질의 하나에 대해 G 개의 출력 \{o_1, \ldots, o_G\} 를 샘플링하고, 그룹 통계로 어드밴티지(Advantage)를 계산합니다:
A_i = \frac{r_i - \mu_G}{\sigma_G + \epsilon}, \qquad \mu_G = \frac{1}{G} \sum_{j=1}^{G} r_j별도의 가치 모델 없이 같은 질의에서 뽑은 그룹 안의 상대적 순위만으로 학습 신호를 만드는 것이 GRPO의 특징이고, 정답이 하나가 아닌 집합값 보상에서도 그대로 적용됩니다.
여기에 개방형 생성을 안정화하기 위해 소프트 PPO(Soft PPO) 정규화를 더합니다. KL 정규화 정책 경사 설계와 TROLL(Trust Regions improve reinforcement Learning for Large language models) 연구를 따라, 현재 정책 \pi_\theta 와 샘플링 정책 \pi_{\text{old}} 사이의 순방향(Forward) KL(Kullback-Leibler) 발산과 역방향(Reverse) KL 발산 벌점을 모두 GRPO 목적에 추가하는 방식입니다:
\mathcal{J}(\theta) = \mathbb{E}_{\pi_{\text{old}}}\Big[ \mathcal{L}_{\text{GRPO}} - \beta_1\, \mathbb{D}_{\text{KL}}(\pi_\theta \,\|\, \pi_{\text{old}}) - \beta_2\, \mathbb{D}_{\text{KL}}(\pi_{\text{old}} \,\|\, \pi_\theta) \Big]실제 구현에서는 토큰별 손실에 두 KL 항을 직접 얹는 형태로 계산하며, \rho_t = \pi_\theta / \pi_{\text{old}} 를 중요도 비율(Importance Ratio)로 씁니다:
\mathcal{L}(\theta) = \mathbb{E}_t\Big[ -\min\big(\rho_t A_t,\ \text{clip}(\rho_t, 1-\epsilon, 1+\epsilon) A_t\big) + \beta_1 \rho_t \big(\log \pi_\theta(o_t) - \log \pi_{\text{old}}(o_t)\big) + \beta_2 \big(-\log \pi_\theta(o_t)\big) \Big]논문에 공개된 학습 설정을 보면 그룹 크기 G = 8, 클리핑 \epsilon = 0.2, 두 KL 계수 \beta_1 = \beta_2 = 0.05, 학습률 1 \times 10^{-7}, 전역 배치 크기 512, 최대 시퀀스 길이 1,024 토큰이며, 학습은 TPUv6e-16 포드에서 수행했습니다. (학습 하이퍼파라미터 전체는 논문의 Appendix F, Table 3을 참고해주세요)
2단계: 합성 지도 데이터 생성
두 번째 단계에서 최적화된 FOLM \pi_{\theta^\ast} 는 행동 생성기(Behavior Generator) 역할을 합니다. 보상이 빚어낸 팬아웃 검색 패턴의 분포를 그대로 유도하는 장치인 셈입니다. 질의마다 \pi_{\theta^\ast} 에서 팬아웃 출력을 샘플링하고 고정 데이터베이스에 대해 검색을 실행한 뒤, 그 결과를 지도 데이터로 삼습니다. 사람 라벨은 전혀 필요하지 않습니다.
이때 하류 모델이 여러 검색 임베딩을 한 번의 순전파로 생성할 수 있도록, 팬아웃 결과 하나를 일관 타깃 텐서(Coherent Target Tensor) \mathbf{Z}_{\text{target}} \in \mathbb{R}^{L \times d} 로 표현합니다. 각 행이 FOLM이 발견한 검색 방향 하나에 대응합니다. 무엇을 행에 담는지는 과제에 따라 다릅니다:
- OAR: 목표가 다양하고 근거 있는 검색 결과 자체이므로, 팬아웃 출력에 대응하는 검색된 콘텐츠의 임베딩 \{z_{c_1}, \ldots, z_{c_L}\} 로 타깃을 구성합니다. RL 정책이 유도한 데이터베이스에 근거한 컬렉션의 분포를 직접 증류하는 것입니다.
- WSCR: 목표가 참조 집합을 함께 덮는 검색 방향의 발견이므로, FOLM이 생성한 최적화된 하위 질의의 텍스트 임베딩 \{e_{\text{text}}(q_1), \ldots, e_{\text{text}}(q_L)\} 로 타깃을 구성합니다. RL이 학습한 질의 분해 전략 자체를 하류 모델이 내재화하게 하는 선택입니다.
집합값 검색은 순서와 무관하므로 학습 중 \mathbf{Z}_{\text{target}} 의 행을 무작위로 섞어 순열 강건성(Permutation Robustness)을 유도합니다. 이렇게 만든 합성 데이터셋 \mathcal{T}_{\text{syn}} = \{(z_q, \mathbf{Z}_{\text{target}})\} 이 보상 최적화 정책이 유도하는 팬아웃 검색 분포 전체를 담습니다. 규모를 보면, OAR에서는 43,874개의 고유한 넓은 질의를, WSCR에서는 84,704개의 질의를 8:1:1로 학습, 검증, 테스트에 나눈 뒤, 학습용 질의마다 온도(Temperature) 0.9 로 128개 샘플을 생성해 확산 모델 학습 타깃을 만들었습니다. 이 데이터 생성 단계는 TPUv6e-4 포드에서 수행했습니다.
3단계: 단일 패스 팬아웃을 위한 확산 검색기
마지막 단계는 p(\mathbf{Z}_{\text{target}} \mid z_q) 를 모델링하는 생성형 검색기 D_\phi 의 학습입니다. 연구팀은 Song et al.의 점수 기반 확률 미분 방정식(Stochastic Differential Equation, SDE) 연구에서 제안된 분산 폭발(Variance Exploding, VE) 확산 형식을 Karras et al.의 EDM(Elucidating the Design space of diffusion-based generative Models) 프레임워크 안에서 채택했습니다. 잡음 제거기(Denoiser) D_\phi(\mathbf{Z}_t; \sigma, z_q) 는 잡음이 섞인 입력에서 깨끗한 타깃을 복원하도록 다음 손실로 학습됩니다:
\mathcal{L}_{\text{diff}} = \mathbb{E}_{\sigma, \epsilon}\Big[ \lambda(\sigma) \cdot \left\| D_\phi(\mathbf{Z}_{\text{target}} + \sigma \epsilon;\, \sigma,\, z_q) - \mathbf{Z}_{\text{target}} \right\|^2 \Big]여기서 \lambda(\sigma) = (\sigma^2 + \sigma_{\text{data}}^2) / (\sigma \cdot \sigma_{\text{data}})^2 는 잡음 수준별 기여를 균형 잡는 EDM 가중치입니다.
아키텍처는 구조적 일관성을 위해 설계된 트랜스포머(Transformer) 잡음 제거기로, DiT(Diffusion Transformer) 계열을 연속 입력에 맞게 손본 형태이며 EDM의 전처리(Preconditioning) 기법을 그대로 따릅니다. 입력은 L 개의 타깃 임베딩을 이어 붙인 시퀀스이고, 질의 임베딩 z_q 는 교차 어텐션(Cross-attention)으로 주입됩니다. 학습 중 z_q 를 확률 0.1 로 무작위 제거해 분류기 없는 가이던스(Classifier-Free Guidance, CFG)를 적용하고, 추론 시에는 확률 흐름 SDE를 256 스텝으로 풀어 \mathbf{Z}_0 를 생성한 뒤 L 개의 임베딩으로 잘라 최근접 이웃 검색으로 데이터베이스 콘텐츠에 대응시킵니다.
확산 모델의 주요 설정은 다음과 같습니다.
항목 값 모델 유형 Coherent Transformer (6 레이어, 16 헤드, 은닉 차원 1,024) 임베딩 차원 d 128 최적화 Adam, 웜업 후 코사인 감쇠, 최대 학습률 3 \times 10^{-4} 학습 스텝 10 \times 10^6 스텝, 배치 크기 512, EMA(Exponential Moving Average) 감쇠 0.9999 확산 스킴 Variance Exploding, EDM 가중치, 탄젠트 잡음 스케줄 잡음 범위 [\sigma_{\min}, \sigma_{\max}] [10^{-4}, 80.0] 데이터 표준편차 \sigma_{\text{data}} 0.088 CFG 조건 제거 확률 0.1, 가이던스 강도 0.1 샘플링 스텝 256전체 파라미터 수는 53.9M에 그칩니다. 4B 규모의 FOLM이 발견한 행동을 그 \frac{1}{70} 규모도 안 되는 모델이 이어받는 셈이고, 이 크기 차이가 뒤에서 볼 지연 단축의 근원입니다.
실험 설계
데이터셋과 검색 백본
연구팀은 서로 다른 검색 모달리티(텍스트-이미지, 텍스트-음악)와 도메인을 대표하는 두 데이터셋에서 R4T를 평가했습니다.
Polyvore는 사용자가 직접 큐레이션한 코디로 구성된 대규모 패션 벤치마크로, Han et al.(2017)이 공개했습니다(GitHub). 각 코디는 상의, 하의, 신발, 액세서리처럼 서로 다른 카테고리의 호환되는 패션 상품을 담은 정답 항목 집합으로 기능하며, 상품 이미지와 텍스트 메타데이터가 함께 제공되어 멀티모달 근거성과 집합 일관성을 함께 평가할 수 있습니다. 후보 검색 풀은 Task 1(OAR)에서 21,888개의 컬렉션, Task 2(WSCR)에서 142,472개의 개별 항목입니다.
Music은 전문가가 만든 음악 플레이리스트로 구성된 비공개 산업 데이터셋(Proprietary Industrial Dataset)입니다. 각 플레이리스트가 일관된 트랙 시퀀스이자 검색의 정답 집합 역할을 하며, 음악 도메인에서 주제 일관성과 의도 커버리지를 모델링하는 능력을 봅니다. 후보 검색 풀은 8,522개의 플레이리스트 임베딩이고 Task 1에만 사용됩니다.
검색 백본은 데이터셋별로 고정된 임베딩 모델을 씁니다. Polyvore에는 마트료시카 표현 학습(Matryoshka Representation Learning)으로 학습한 CLIP(Contrastive Language-Image Pre-training) 기반 이미지-텍스트 인코더를 써서 임베딩을 유연하게 잘라 쓸 수 있게 했고, 주 실험에서는 정확도와 효율의 균형을 위해 임베딩 차원 128을 사용했습니다. Music에는 대규모 오디오-언어 쌍으로 학습된 음악-텍스트 결합 임베딩 모델 MuLan을 써서 그 임베딩 공간 안에서 직접 검색합니다. R4T는 이 고정된 인코더 위에서 동작하므로 임베딩 공간 자체는 건드리지 않습니다.
넓은 질의는 LLM으로 합성했습니다. OAR용 질의는 미학적 테마("bohemian festival style"), 활동 시나리오("weekend brunch outfit"), 계절("summer vacation vibes"), 라이프스타일("sustainable living"), 기분("confident and bold") 등 여러 템플릿으로 2~6단어짜리 개방형 질의를 생성하고 중복을 제거한 것이고, WSCR용 질의는 반대로 기존 코디의 항목 이름을 LLM(Gemini-2.5-Pro)에 주고 개별 항목을 나열하지 않는 코디 수준의 넓은 질의를 만들게 한 것입니다. WSCR에서는 원래 코디에 무작위 항목을 섞은 후보 풀에서 LLM이 스타일이 다른 10개 항목 집합 8개를 한 번에 고르게 하는 식으로 학습 데이터를 증강하고, 테스트 집합도 원래 항목의 33\% 에서 60\% 만 남긴 시드에서 새 코디를 완성하게 해 한 질의에 여러 그럴듯한 조합이 존재하도록 만들었습니다. (질의 생성 프롬프트 전문은 논문의 Appendix C를 참고해주세요)
비교 대상과 평가 지표
비교 대상은 세 가지입니다. No Fan-out은 하위 질의 확장 없이 원 질의로 n \times k 개의 콘텐츠를 직접 검색하는 전통적 밀집 검색으로, 팬아웃 방법들의 하한 역할을 합니다. Zero-shot Fan-out은 RL 학습 전의 기본 언어 모델로 k 개의 하위 질의를 생성하고 각각 n 개를 검색하는 방식이며, 하위 질의 생성 모델로 대규모 상용 모델인 Gemini-2.5-Flash, 그리고 Gemma3-4B와 Qwen3-4B를 각각 실험했습니다. Best-of-N은 제로샷 모델로 팬아웃을 N = 5 번 수행한 뒤 학습에 쓴 보상 기준으로 가장 좋은 결과를 고르는 강력한 기준선입니다. 모든 팬아웃 방법과 R4T는 k = 10 개의 하위 질의를 사용합니다.
평가 지표는 과제별로 다릅니다. OAR은 정답 집합이 없으므로 Gemini 2.5(논문 본문은 Pro, 부록은 Flash로 표기)를 심판으로 쓰는 LLM-as-a-Judge 평가를 채택해, 컬렉션 다양성, 질의-컬렉션 정렬, 근거성 세 차원을 각각 5점 리커트(Likert) 척도로 매기게 했습니다. 항목 순서를 무작위로 섞고, 점수마다 근거 설명을 요구하고, 프롬프트에 검색 방법을 언급하지 않는 등 편향을 줄이는 장치를 두었습니다. 근거성은 각 하위 질의의 검색 결과가 그 하위 질의와 맞는지만 보는 지표라, 중간 하위 질의가 없는 R4T-Diffusion에는 적용되지 않습니다.
WSCR은 참조 기반 커버리지 지표인 Recall@5K와 Hit@5K, 그리고 다양성과 생성 안정성을 보는 Vendi Score(VS) 를 보고합니다. 하위 질의(또는 생성된 임베딩) 10개마다 후보 500개씩 가져와 한 번의 추론에 5,000개 풀을 만들고, Recall@5K는 참조 항목 중 이 풀에 들어온 비율, Hit@5K는 참조 항목이 하나라도 들어온 질의의 비율입니다. Vendi Score는 질의마다 독립적인 추론을 N = 5 회 수행하고 각 실행의 하위 질의 임베딩 평균을 대표 임베딩으로 삼아, 그 대표 임베딩들 사이의 의미적 분산을 계산한 값입니다. 참조 집합이 유일한 정답이 아니므로 연구팀은 재현율(Recall)을 정확성이 아니라 의미 커버리지의 대리 지표로 해석합니다.
실험 결과 및 성능 분석
개방형 추상 검색(OAR) 결과
OAR 과제의 결과는 다음과 같습니다(논문 Table 1). 논문이 함께 보고한 표준편차(대체로 1.5 에서 3.6 사이)는 생략했습니다. 근거성은 중간 하위 질의가 없는 R4T-Diffusion에는 해당하지 않습니다.
Polyvore (패션)
방법 근거성 다양성 정렬 평균 No Fan-out 22.4 34.4 21.4 26.1 Gemini-2.5-Flash Zero-shot 24.0 47.0 23.6 31.5 Gemini-2.5-Flash Best-of-N 26.1 52.2 25.2 34.5 Gemma3-4B Zero-shot 28.4 56.0 31.2 38.5 Gemma3-4B Best-of-N 28.9 61.0 32.7 40.9 R4T-FOLM (Gemma) 30.8 76.8 39.8 49.1 R4T-Diffusion (Gemma) - 74.3 37.6 - Qwen3-4B Zero-shot 23.8 37.0 23.4 28.1 Qwen3-4B Best-of-N 27.0 40.3 24.0 30.4 R4T-FOLM (Qwen) 37.0 62.8 28.0 42.6 R4T-Diffusion (Qwen) - 65.0 27.4 -Music (음악 플레이리스트)
방법 근거성 다양성 정렬 평균 No Fan-out 48.8 20.0 41.8 36.9 Gemini-2.5-Flash Zero-shot 45.8 45.2 44.4 45.1 Gemini-2.5-Flash Best-of-N 48.2 48.4 49.0 48.5 Gemma3-4B Zero-shot 49.8 42.6 51.8 48.1 Gemma3-4B Best-of-N 51.4 43.2 53.0 49.2 R4T-FOLM (Gemma) 63.1 49.2 62.0 58.1 R4T-Diffusion (Gemma) - 46.7 59.6 - Qwen3-4B Zero-shot 42.0 38.8 41.2 40.7 Qwen3-4B Best-of-N 44.0 40.3 43.7 42.7 R4T-FOLM (Qwen) 48.2 44.8 49.4 47.5 R4T-Diffusion (Qwen) - 44.5 52.0 -위 표를 통해 세 가지를 알아볼 수 있습니다.
첫째, 팬아웃은 필요하지만 충분하지 않습니다. 모든 데이터셋과 기본 모델에서 제로샷 팬아웃은 원 질의로 직접 검색하는 No Fan-out을 앞섰습니다. 질의 확장이 의미적 측면의 커버리지를 넓힌다는 오래된 가설이 다시 확인된 것입니다. 그러나 제로샷 팬아웃의 하위 질의는 데이터베이스 매니폴드에서 벗어나거나 거의 같은 표현으로 붕괴하는 일이 잦아 근거성이 낮고 결과가 중복되었고, 정답의 제약이 없는 OAR에서 이 약점이 특히 두드러졌습니다. 흥미로운 점은 상용 대형 모델인 Gemini-2.5-Flash의 제로샷 팬아웃이 Polyvore에서 평균 31.5 로, 4B 규모 Gemma3-4B의 38.5 보다 낮았다는 것입니다.
둘째, 보상 기반 선택은 품질을 높이지만 확장되지 않습니다. Best-of-N은 고보상 팬아웃 사례를 골라내 제로샷보다 나은 결과를 냈고, 이는 연구팀이 설계한 보상 함수가 검색 행동을 빚는 의미 있는 신호라는 증거이기도 합니다. 그러나 질의마다 독립적인 팬아웃을 여러 번 실행해야 하므로 추론 비용이 한 차수(약 10배) 늘어나고, 지연과 확장성을 대가로 얻은 이득이라 실용 시스템에는 적용이 제한적입니다.
셋째, R4T는 정확도-효율 경계에서 일관되게 우위에 있습니다. R4T-FOLM은 Gemma 계열의 Polyvore 평균을 40.9 (Best-of-N)에서 49.1 로, Music 평균을 49.2 에서 58.1 로 끌어올렸고, 다양성 점수는 Polyvore에서 56.0 (제로샷)이 76.8 까지 올랐습니다. Qwen 계열에서는 근거성이 23.8 에서 37.0 으로 크게 개선되었습니다. 그리고 R4T-Diffusion은 단일 추론 패스만 쓰면서도 다양성과 정렬에서 R4T-FOLM에 근접했고, Polyvore의 Qwen 계열에서는 다양성 65.0 으로 FOLM(62.8)을 오히려 넘었습니다. 다만 이 우위는 같은 기본 모델 계열 안에서의 비교이고, 계열을 가로지르면 Music에서 Qwen 기반 R4T-FOLM의 평균 47.5 는 Gemini-2.5-Flash Best-of-N의 48.5 와 Gemma3-4B 제로샷의 48.1 에 미치지 못했습니다. 연구팀은 이 결과가 R4T의 핵심 이점, 즉 "RL로 고품질 팬아웃 행동을 한 번 발견하고, 그 행동을 경량 확산 검색기로 증류한다"는 설계가 실제로 작동함을 보여준다고 설명합니다.
약지도 조합 검색(WSCR) 결과: 커버리지와 다양성의 교환
WSCR 과제(Polyvore)의 결과는 다음과 같습니다. LLM 기반 검색은 온도 0.9 로 샘플링하고, 모든 방법에서 질의당 5회 실행(총 50개 하위 질의)으로 Vendi Score를 계산했습니다.
방법 Recall@5K Hit@5K Vendi Score Gemini-2.5-Flash 15.7 52.1 33.4 Gemma3-4B 6.0 25.9 44.2 Qwen3-4B 10.1 33.9 46.4 R4T-FOLM (Gemma) 16.9 54.4 40.5 R4T-FOLM (Qwen) 20.9 64.6 27.5 R4T-Diffusion (Gemma) 15.0 54.1 46.2 R4T-Diffusion (Qwen) 16.5 57.5 34.7커버리지 측면에서 R4T-FOLM(Qwen)은 Recall@5K 20.9, Hit@5K 64.6 으로 가장 높았고, 제로샷 Qwen3-4B(10.1, 33.9)의 약 두 배에 이르는 수치입니다. 4B 모델로 RL 학습을 거친 FOLM 두 변형은 상용 모델 Gemini-2.5-Flash(15.7, 52.1)도 넘어섰습니다. 확산 변형은 Hit@5K에서는 둘 다 Gemini-2.5-Flash를 앞섰지만, Recall@5K에서는 Gemma 기반이 15.0 으로 조금 못 미치고 Qwen 기반이 16.5 로 근소하게 앞서는 수준이었습니다.
이 표에서 연구팀이 주목한 것은 참조 기반 커버리지와 다양성 사이의 뚜렷한 교환 관계(Trade-off) 입니다. LLM 기반 방법들 사이에서는 Recall@5K와 Hit@5K가 높을수록 Vendi Score가 낮아지는 경향이 나타났습니다. 참조 집합과의 겹침을 목표로 최적화된 자기회귀 팬아웃은 소수의 지배적인 의미 모드(Mode) 주변으로 검색을 집중시킨다는 뜻이고, 이는 RL이 언어 모델의 출력 엔트로피를 낮추고 모드 붕괴를 유도한다는 최근 연구 결과와도 일치합니다. 반대로 제로샷 LLM과 확산 기반 검색은 실행마다 더 넓은 의미 공간을 탐색해 다양성이 높았습니다.
연구팀은 여기서 재현율이 낮다고 검색 품질이 낮은 것은 아니라고 강조합니다. 참조 집합은 완전한 정답이 아니라 질의 의도의 그럴듯한 실현 하나일 뿐이므로, 다양성이 높다는 것은 참조 항목에 담기지 않은 다른 유효한 해석을 찾아내고 있다는 뜻일 수 있습니다. R4T-FOLM은 다양성을 희생하며 커버리지를 높인 반면, R4T-Diffusion은 확산 생성 고유의 다양성을 상당 부분 유지하면서 커버리지를 크게 끌어올렸습니다. Gemma 계열을 보면 R4T-Diffusion은 Vendi Score 46.2 로 제로샷 Gemma3-4B(44.2)보다도 높은 다양성을 유지하면서 Hit@5K를 25.9 에서 54.1 로 두 배 넘게 올렸습니다. 연구팀은 보상 정렬 행동을 확산 사전분포에 증류하는 것이 약한 지도 아래에서 커버리지와 의미적 풍부함의 균형을 잡는 실용적인 방법이라고 정리합니다.
한 가지 알려드릴 점은, Google Research 블로그의 결과 차트는 Vendi Score를 "낮을수록 좋다"고 표기하고 R4T-FOLM(Qwen)의 27.5 를 최고 성적으로 굵게 표시했다는 것입니다. 이는 이 지표를 실행 간 생성 안정성으로 읽은 것으로, 논문 본문이 같은 값을 다양성으로 읽어 R4T-Diffusion의 높은 값을 장점으로 서술하는 것과는 방향이 반대입니다. 이 글은 논문 본문의 해석을 따랐습니다.
보상 해킹 절제 실험: 다양성 항이 닫아 주는 지름길
하지만 "왜 보상을 세 개나 합쳐야 하는가?"라는 의문이 남습니다. 연구팀은 OAR 과제에서 보상 구성 요소를 하나씩 빼 보는 절제 실험(Ablation Study)으로 이 질문에 답합니다.
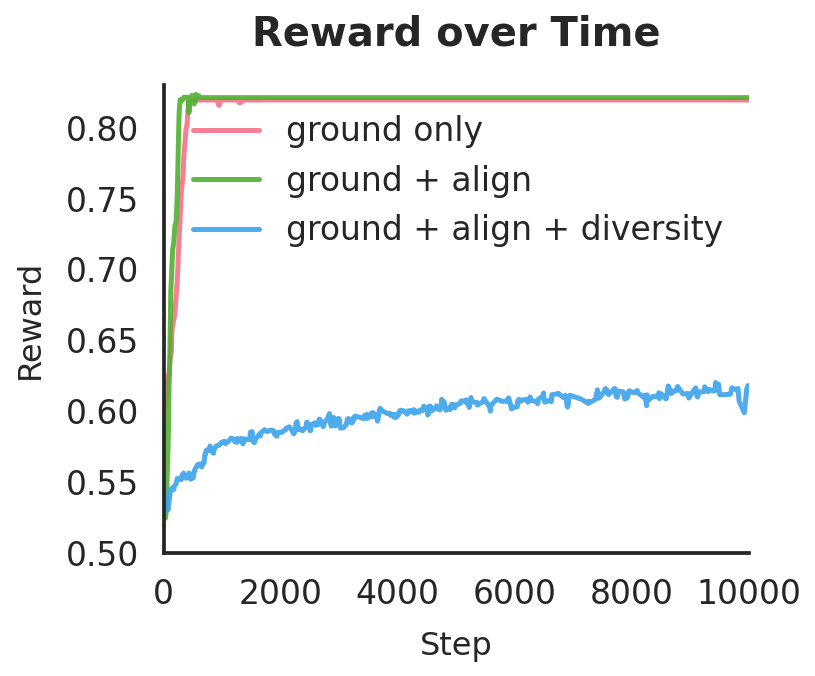
결과는 명확합니다. 근거성 보상만으로 학습하면 정책은 "line ending line ending line ending" 같은 퇴화된 무의미 문자열로 수렴합니다. 이런 문자열이 우연히 특정 데이터베이스 항목과의 임베딩 거리를 최소화하기 때문입니다. 위 그림의 보상 곡선을 보면, 근거성만 쓴 정책과 근거성+정렬을 쓴 정책은 수백 스텝 만에 보상 0.82 부근까지 치솟아 그대로 고정됩니다. 학습이 잘 된 것이 아니라 보상의 허점을 찾아낸 것입니다.
근거성과 정렬을 함께 쓰면 붕괴가 오히려 더 빨라집니다. 정책이 원 질의의 의역을 반복하기만 해도 정렬 점수가 손쉽게 최대화되고, 의미적 분산은 아무 벌점을 받지 않기 때문입니다. 반면 근거성, 정렬, 다양성을 함께 최적화한 정책은 붕괴하지 않고 보상이 0.53 에서 0.62 까지 1만 스텝에 걸쳐 완만하게 오르며 안정적인 GRPO 학습을 보였습니다.
연구팀은 이 세 항이 상호 견제 앵커(Mutual Counter-anchors) 로 작동한다고 설명합니다. 근거성만 최적화하면 데이터베이스 좌표를 수학적으로 맞추는 퇴화 문자열로 보상을 해킹하고, 정렬을 더하면 원 질의의 의역으로 붕괴합니다. 여기에 Vendi Score라는 기하학적 다양성 지표를 견제 앵커로 넣으면 이런 지름길이 모두 막혀, 정책은 유효하고 엄격하게 근거를 갖추면서도 의미적으로 서로 다른 변형을 찾아내는 균형 잡힌 임베딩 공간 영역으로 밀려납니다. 높은 보상을 받을 수 있는 방법이 검색 전문가처럼 행동하는 것 하나만 남는 셈입니다.
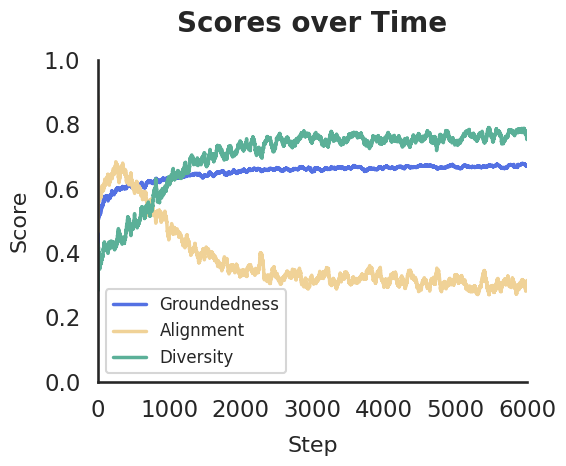
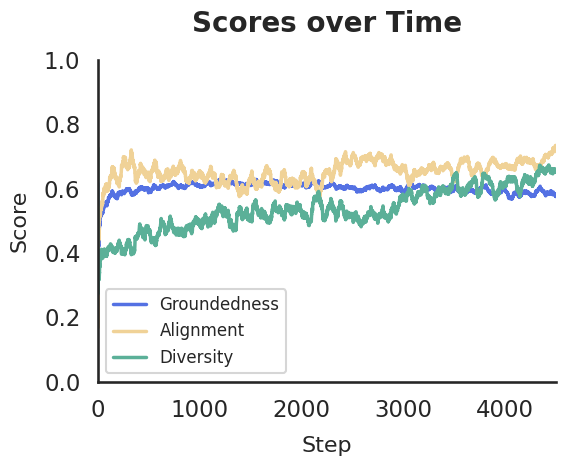
가중치 비율도 학습 동역학을 바꿉니다. Qwen3-4B에서 \lambda_g : \lambda_d : \lambda_a 를 6:2:2, 4:3:3, 2:4:4로 바꿔 본 결과, 근거성이 지배하면 다양성은 오르지만 정렬이 무너지고(위 첫 번째 그림, 정렬 점수가 0.65 부근에서 0.3 아래로 하락), 반대로 정렬과 다양성을 강조하면 탐색이 억제되어 대안적 해석에 대한 커버리지가 줄었습니다. 균형 잡힌 4:3:3 설정에서 세 점수가 모두 안정적으로 수렴했습니다(위 두 번째 그림). 논문의 기본 가중치가 6:2:2(\lambda_g = 0.6, \lambda_d = \lambda_a = 0.2)로 명시된 점을 함께 고려하면, 이 가중치는 도메인과 기본 모델에 따라 조정이 필요한 하이퍼파라미터로 보는 것이 안전합니다. 탐색과 의미 충실도 사이의 교환 관계가 이 실험 전반에 깔려 있습니다.
정성 비교: "Bohemian festival style"
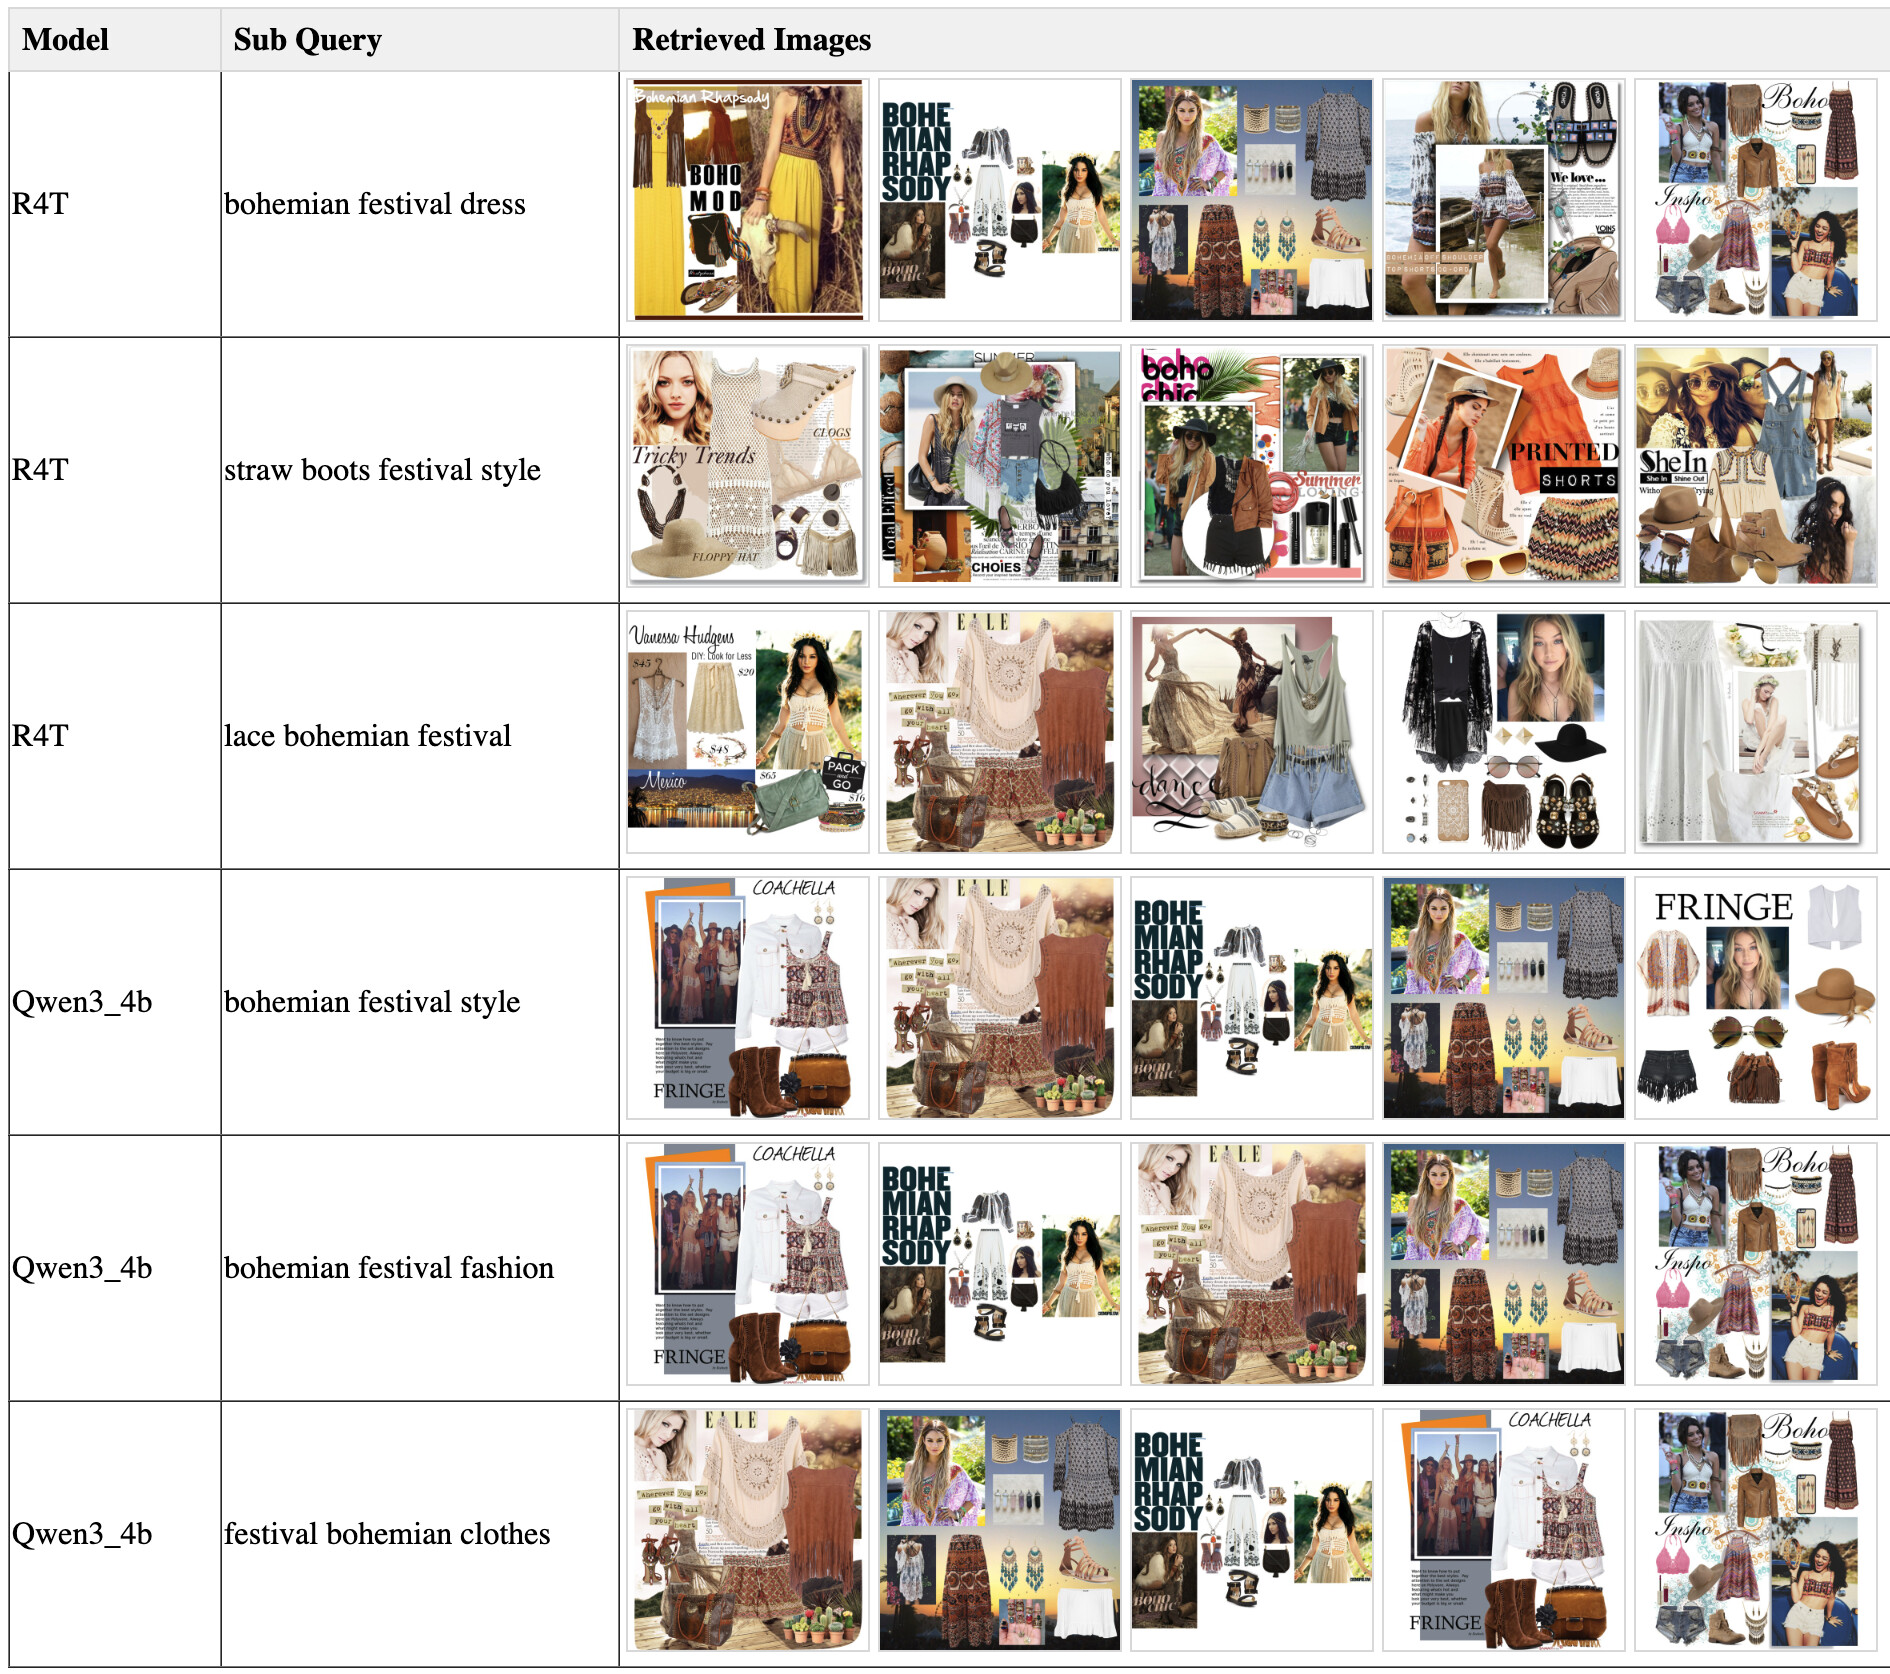
숫자 뒤에 실제로 어떤 결과가 있는지 살펴보겠습니다. "Bohemian festival style" 질의에 대해 R4T는 "bohemian festival dress", "straw boots festival style", "lace bohemian festival"처럼 서로 다른 주제 방향의 하위 질의를 생성했습니다. 각 하위 질의는 시각적으로 일관되면서도 서로 다른 코디 묶음을 가져와, 전체 스타일과의 일관성을 유지하면서 다양성을 확보했습니다. 반면 Qwen3-4B 제로샷은 "bohemian festival style", "bohemian festival fashion", "festival bohemian clothes"처럼 같은 표현의 변형만 만들어, 위 그림의 아래 세 행이 보여주듯 거의 같은 이미지가 반복되는 균질한 결과를 냈습니다.
"Labor day picnic outfit" 질의에서도 같은 경향이 나타났습니다. R4T는 보헤미안, 미니멀리스트, 점프수트 스타일처럼 보완적인 측면으로 질의를 분해해 실루엣, 색상, 액세서리가 서로 다르면서도 계절과 피크닉 맥락에 맞는 코디를 가져왔습니다. Gemini-2.5-Flash는 문장 형태는 다양한 하위 질의를 만들었지만, 검색된 집합은 더 균질하고 의미 커버리지가 제한적이었습니다. 연구팀은 이 정성 결과가 세 보상 항의 역할을 그대로 보여준다고 정리합니다. 근거성은 각 하위 질의가 실제 데이터베이스 항목에 대응하게 하고, 정렬은 원 질의 의도와의 일관성을 지키고, 다양성은 여러 유효한 해석의 탐색을 이끕니다.
효율 분석: 12~20배 빠른 팬아웃
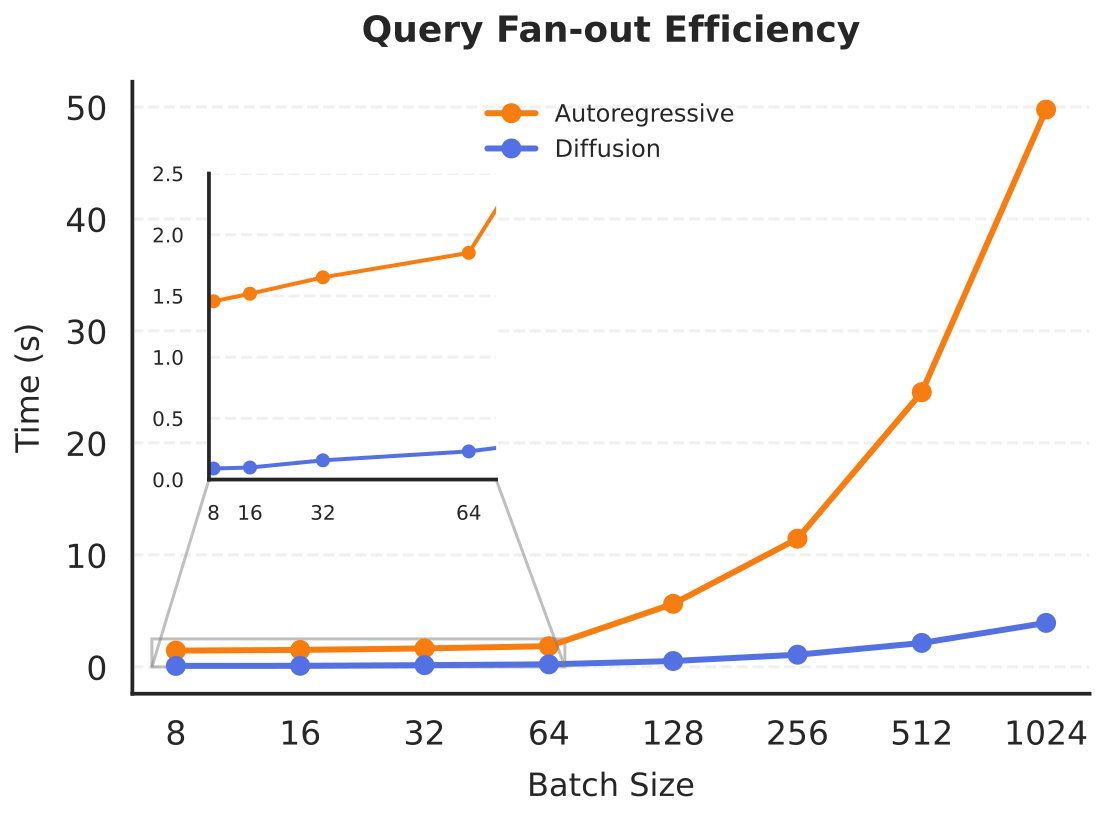
마지막으로 이 논문의 제목에 "Efficient"가 붙은 이유를 보겠습니다. 연구팀은 k = 10 개의 검색 방향을 한 번의 순전파로 생성하는 확산 검색기와, 하위 질의를 순차 생성하고 검색을 호출하는 자기회귀 LLM 팬아웃의 벽시계 지연(Wall-clock Latency)을 배치 크기별로 측정했습니다.
자기회귀 LLM은 작은 배치에서도 큰 고정 비용에 지배되어 배치 8에서 이미 약 1.46 초가 걸리고, 이후 선형으로 늘어나 배치 1,024에서는 50초 가까이 소요됩니다. 반면 53.9M 파라미터의 확산 모델은 임베딩 공간의 비자기회귀 생성 덕분에 작은 배치를 0.07 초, 가장 큰 배치를 4.21 초에 처리합니다. 배치 크기 전 구간에서 12\times 에서 20\times 의 일관된 속도 향상이고, 모델이 작아 배포 메모리 부담도 크게 줄어듭니다. 연구팀은 이 결과가 팬아웃의 부담을 무거운 자기회귀 System 2에서 가벼운 System 1 확산 사전분포로 옮기는 것이 실용적인 실시간 검색에 필수적임을 확인해 준다고 설명합니다.
정리하면, R4T-FOLM을 그대로 배포해도 검색 품질은 우수하지만 자기회귀 지연과 사고 예산(Thinking Budget)이라는 비용이 그대로 따라오고, 그 행동을 확산 모델에 증류하면 품질의 대부분을 유지한 채 지연 병목이 사라집니다. 이것이 논문이 두 배포 변형을 함께 보고한 이유입니다.
한계점 및 향후 연구 방향
연구팀은 논문의 부록에서 네 가지 한계를 밝히고 있습니다.
첫째, RL 단계의 선행 비용입니다. 고정된 검색기와 반복적으로 상호작용하며 보상을 명시적으로 계산해야 하므로, 배포 시점에는 비용이 상각되더라도 데이터베이스가 매우 크거나 자주 바뀌는 환경에서는 학습 오버헤드가 상당할 수 있습니다. 검색 인덱스가 매일 갱신되는 상용 서비스라면 FOLM과 확산 검색기를 얼마나 자주 다시 학습해야 하는지가 실무적인 질문이 됩니다. 연구팀은 더 표본 효율적인 RL, 부분적인 검색기 갱신, 오프라인 근사 등을 후속 방향으로 제시합니다.
둘째, 보상으로 표현할 수 있는 성질만 다룰 수 있다는 가정입니다. 근거성, 정렬, 다양성의 조합이 안정적으로 작동함은 보였지만, 창의성이나 신선함, 문화적 민감성처럼 주관적인 선호는 스칼라 보상으로 옮기기 어렵습니다. 사용자 피드백이나 선호 데이터에서 보상 함수 자체를 학습하는 것이 유망한 방향으로 제시됩니다.
셋째, LLM-as-a-Judge 평가에 대한 의존입니다. OAR의 개방형 품질을 사람이 아닌 Gemini 심판이 매겼으므로, 선행 연구가 사람 판단과의 높은 상관을 보고했다 해도 심판 모델의 편향이 평가에 유입될 수 있고 검색 유용성의 모든 정성적 측면을 담지 못할 수 있습니다. 연구팀은 사람 평가 또는 혼합 평가 프로토콜의 보강을 제안하며, 비교 대상 중 하나가 심판 모델과 같은 계열의 Gemini-2.5-Flash라는 점도 독자가 함께 염두에 둘 부분입니다.
넷째, 특정 아키텍처에 묶인 실증입니다. 프레임워크 자체는 일반적이지만, 실험 결과는 기본 언어 모델, 임베딩 공간, 확산 아키텍처 선택에 의존할 수 있습니다. 다른 검색 백본, 모달리티, 과제 설정으로의 확장은 열려 있는 과제입니다. 연구팀은 R4T를 복잡한 목표 아래 집합값 검색 시스템을 확장 가능하게 학습하는 첫걸음으로 보며, 제어 가능한 검색의 모든 형태를 해결한 완성된 답으로 보지는 않는다고 적었습니다.
여기에 더해 논문의 영향 진술은 보상 명세가 곧 검색 행동을 결정하는 구조의 위험을 지적합니다. 보상을 부주의하게 설계하면 학습 데이터의 편향이 검색 결과에 반영되고, RL 기반 합성은 그 편향을 합성 데이터를 통해 대규모로 전파할 수 있습니다. 이번 실험은 패션과 음악이라는 비교적 무해한 도메인에 한정되었지만, 같은 기법이 민감한 맥락에 적용될 때는 도메인별 편향 감사와 감독 장치가 함께 가야 한다는 것입니다.
한 걸음 물러서 보면, R4T가 제시하는 "RL을 추론 엔진이 아니라 데이터 생성 엔진으로 쓴다"는 구도는 검색 바깥에서도 쓸 수 있는 일반적인 패턴입니다. 정답이 애매하거나 주관적이어서 지도 데이터를 모으기 어렵지만 보상은 정의할 수 있는 문제, 즉 계획, 디자인, 창작 생성 같은 구조화된 생성 과제에 같은 방식을 적용할 수 있다고 연구팀은 전망합니다. 비싼 System 2의 탐색 결과를 싼 System 1 모델에 컴파일해 두는 이 구조가, 추론 시점 연산 비용이 급증하는 최근 흐름에 대한 하나의 대안적 해법이라는 점에서 눈여겨볼 가치가 있습니다.
Efficient, Property-Aligned Fan-Out Retrieval via RL-Compiled Diffusion 논문
arXiv.orgEfficient, Property-Aligned Fan-Out Retrieval via RL-Compiled Diffusion
Many modern retrieval problems are set-valued: given a broad intent, the system must return a collection of results that optimizes higher-order properties (e.g., diversity, coverage, complementarity, coherence) while remaining grounded with respect...
Bypassing inference bottlenecks: Accelerating complex AI search with Retrieve-for-Train 소개 블로그
research.googleBypassing inference bottlenecks: Accelerating complex AI search with...
R4T ICML 2026 포스터 페이지
icml.ccICML Poster Efficient, Property-Aligned Fan-Out Retrieval via RL-Compiled...
더 읽어보기
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
파이토치 한국 사용자 모임은 이런 글들을 한국어로 정리해 나누고 있습니다. 회원으로 가입하시면 주요 글들을 이메일로 보내드리고, 텔레그램(Telegram)과 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.
아래쪽에 좋아요를 눌러주시면 다음 글을 정리하는 데 힘이 됩니다~
1개의 게시물 - 1명의 참여자
https://discuss.pytorch.kr/t/r4t-retrieve-for-train-rl-fan-out-diffusion-model/11933