
Xiaomi, RL 코드와 학습 환경까지 공개한 1.02T 옴니모달 MiMo-V2.6 출시, 오픈소스 지능 지수 1위
MiMo-V2.6 소개
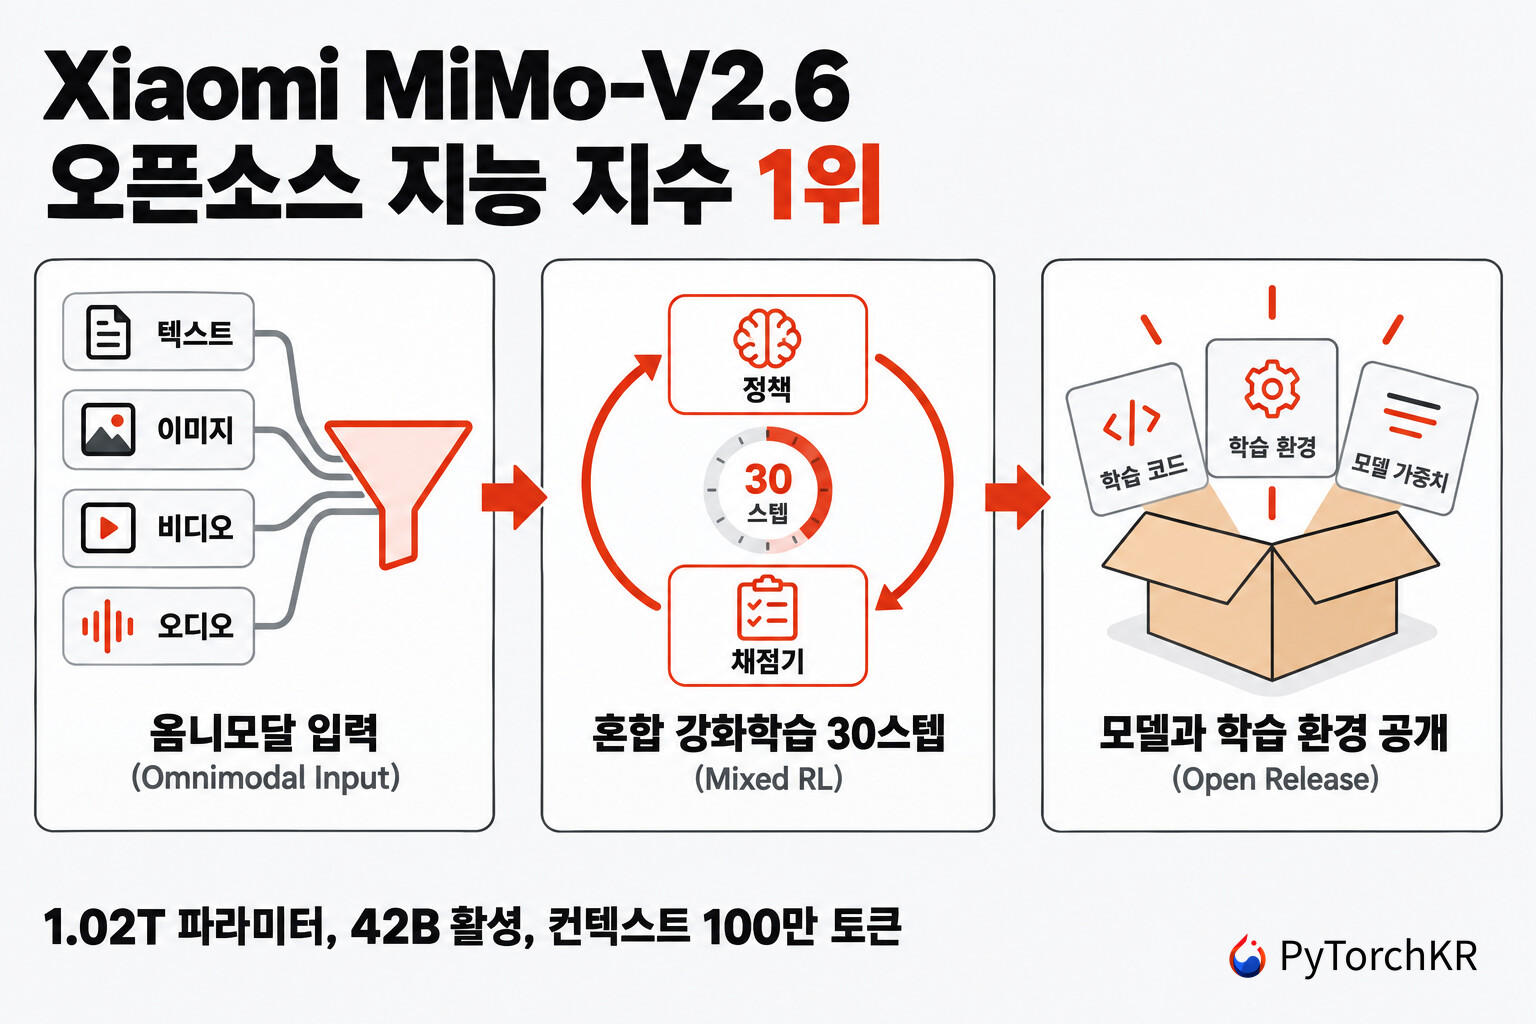
Xiaomi의 MiMo 팀이 2026년 9월 22일 MiMo-V2.6 시리즈 를 공개하고 가중치를 오픈소스로 배포했습니다. 텍스트와 이미지, 영상, 음성을 한 모델에서 처리하는 옴니모달(Omnimodal) 구조에 희소 전문가 혼합(Sparse Mixture of Experts, MoE) 백본을 얹었고, 컨텍스트 길이는 두 모델 모두 100만(1M) 토큰입니다. 크기는 서로 다릅니다. MiMo-V2.6-Pro는 총 1.02조(1.02T) 파라미터 중 42B를 활성화하고, 지능 대비 비용 균형을 노린 MiMo-V2.6-Flash는 총 310B 중 15B를 활성화합니다. 여기에 같은 품질에서 출력 속도를 최대 20배까지 끌어올린 MiMo-V2.6-Pro-UltraSpeed가 더해집니다.
이 시리즈가 앞선 MiMo-V2.5와 다른 점은 모델 크기가 아니라 사후 학습(post-training)에 투입한 계산량입니다. MiMo 팀은 이번 릴리즈를 재귀적 자기 개선(Recursive Self-Improvement, RSI) 경로를 탐색하는 단계로 설명하면서, 검증 가능한 복잡한 과제 위에서 강화학습(Reinforcement Learning, RL) 계산량 자체를 키우면 모델이 탐색과 피드백만으로 능력의 경계를 계속 넓힐 수 있는지를 확인하려 했다고 밝혔습니다. RL에 들어가기 전에는 광범위한 멀티모달 말뭉치로 중간 학습(mid-training)을 돌려 에이전트가 탐색할 공간부터 넓혀 두었습니다. 실제 RL은 6일이 채 안 되는 기간에 30번의 스텝으로 진행했고, 그 과정을 별도 페이지에서 실시간으로 중계했습니다.
그리고 이번에는 결과물만 내놓지 않았습니다. 기술 보고서와 학습 환경, RL 프레임워크, 그리고 RL 실험의 출발점으로 쓰라고 만든 9B 증류 모델까지 함께 공개해 다른 연구자가 같은 실험을 재현하고 검증할 수 있게 하겠다는 것이 이번 발표의 두 번째 축입니다. 오픈 웨이트 모델이 늘어나는 동안에도 사후 학습 레시피와 환경은 대체로 닫혀 있었다는 점을 생각하면, 공개 범위 자체가 이번 릴리즈에서 눈여겨볼 대목입니다.
같은 가격표로 파레토 프론티어를 한 번 더 민 결과
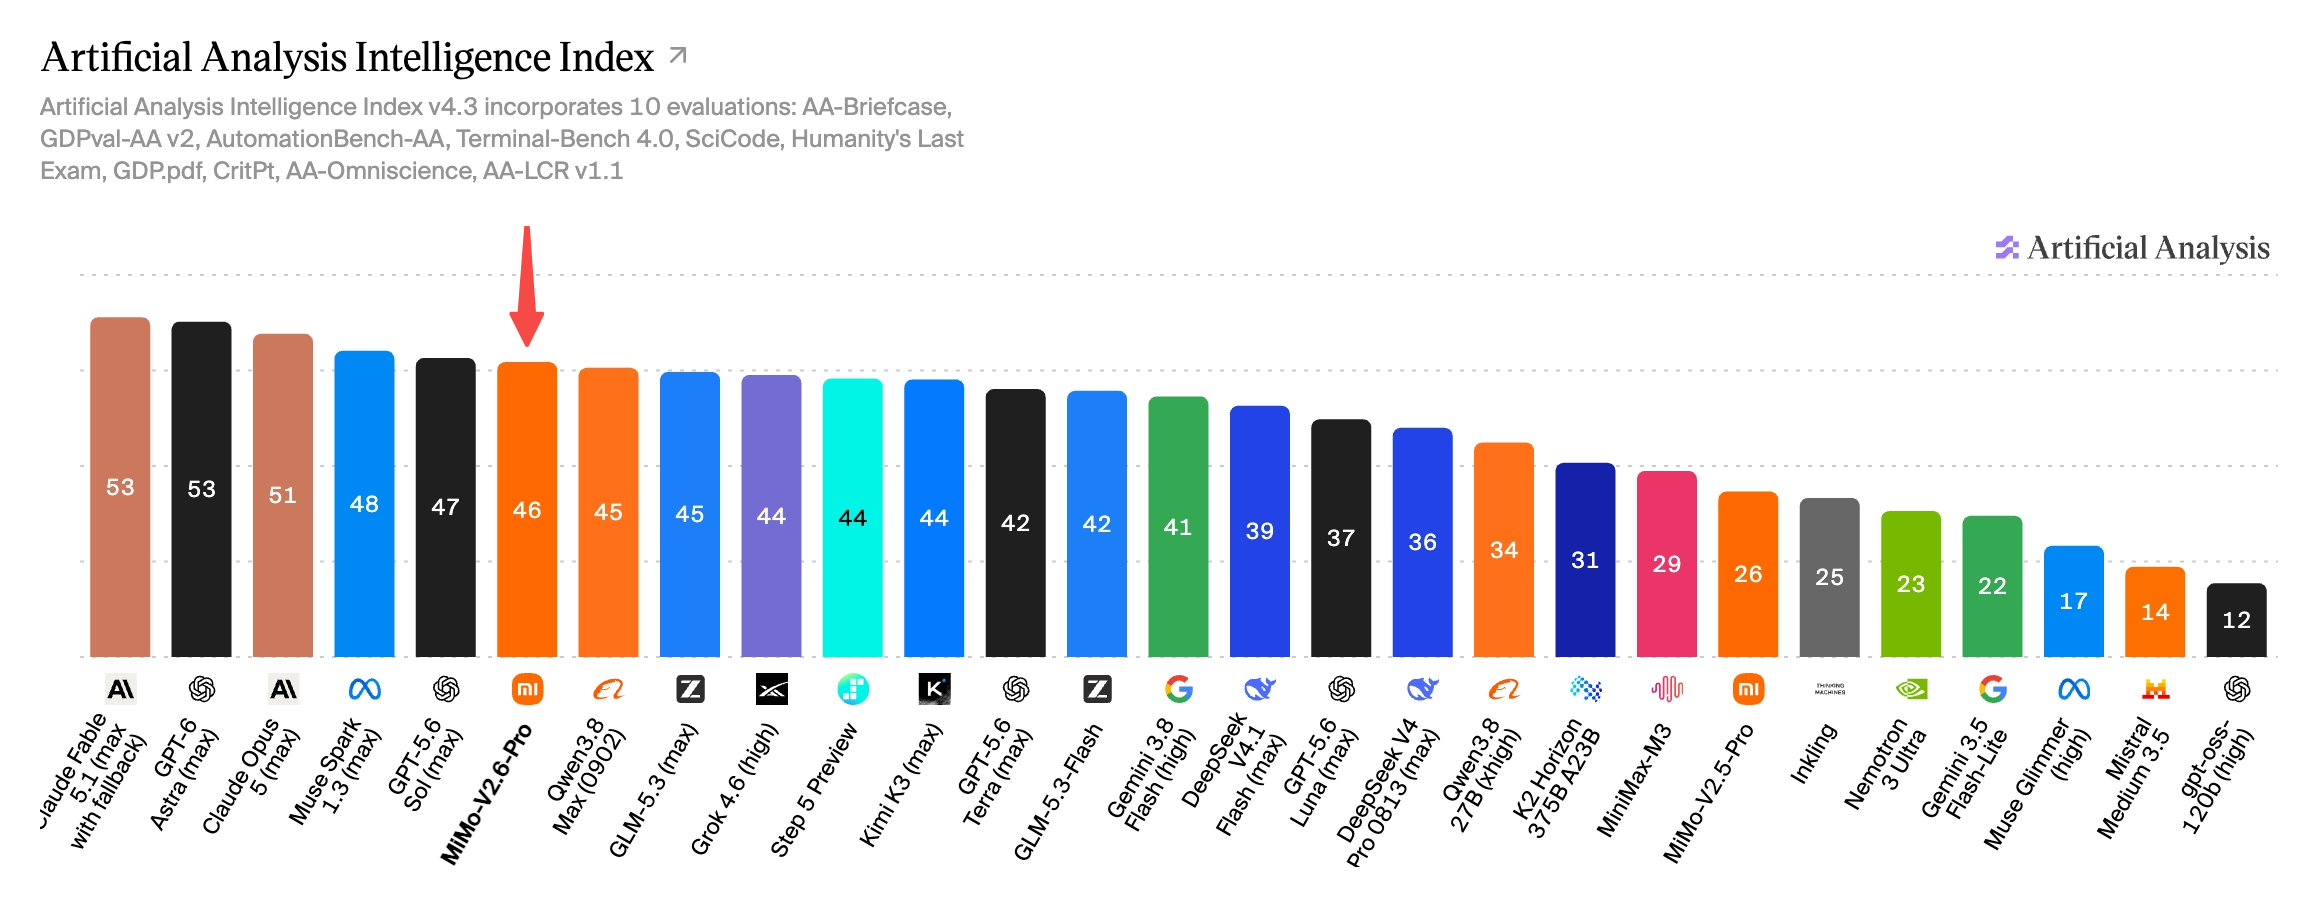
MiMo-V2.6-Pro는 Artificial Analysis 지능 지수(Intelligence Index) v4.3에서 46.32점을 기록했습니다. 이 지수는 AA-Briefcase, GDPval-AA v2, AutomationBench-AA, Terminal-Bench 4.0, SciCode, Humanity's Last Exam, GDP.pdf, CritPt, AA-Omniscience, AA-LCR v1.1의 10개 평가를 묶은 값입니다. 같은 지수에서 Kimi K3는 44점, Qwen3.8 Max는 45점이고, MiMo 팀은 이 두 모델을 넘어선 현재까지 가장 강력한 오픈소스 모델이라고 밝혔습니다. MiMo-V2.5-Pro가 26점이었으니 한 세대 만에 20점가량 올라온 셈입니다.
다만 지수 상위권은 여전히 상용 모델이 차지하고 있습니다. Claude Fable 5.1과 GPT-6 Astra가 53점, Claude Opus 5가 51점, Muse Spark 1.3이 48점, GPT-5.6 Sol이 47점입니다. MiMo-V2.6-Pro의 위치는 "프론티어를 추월했다" 가 아니라 "오픈소스 진영에서 프론티어와의 거리를 가장 좁혔다" 에 가깝습니다.
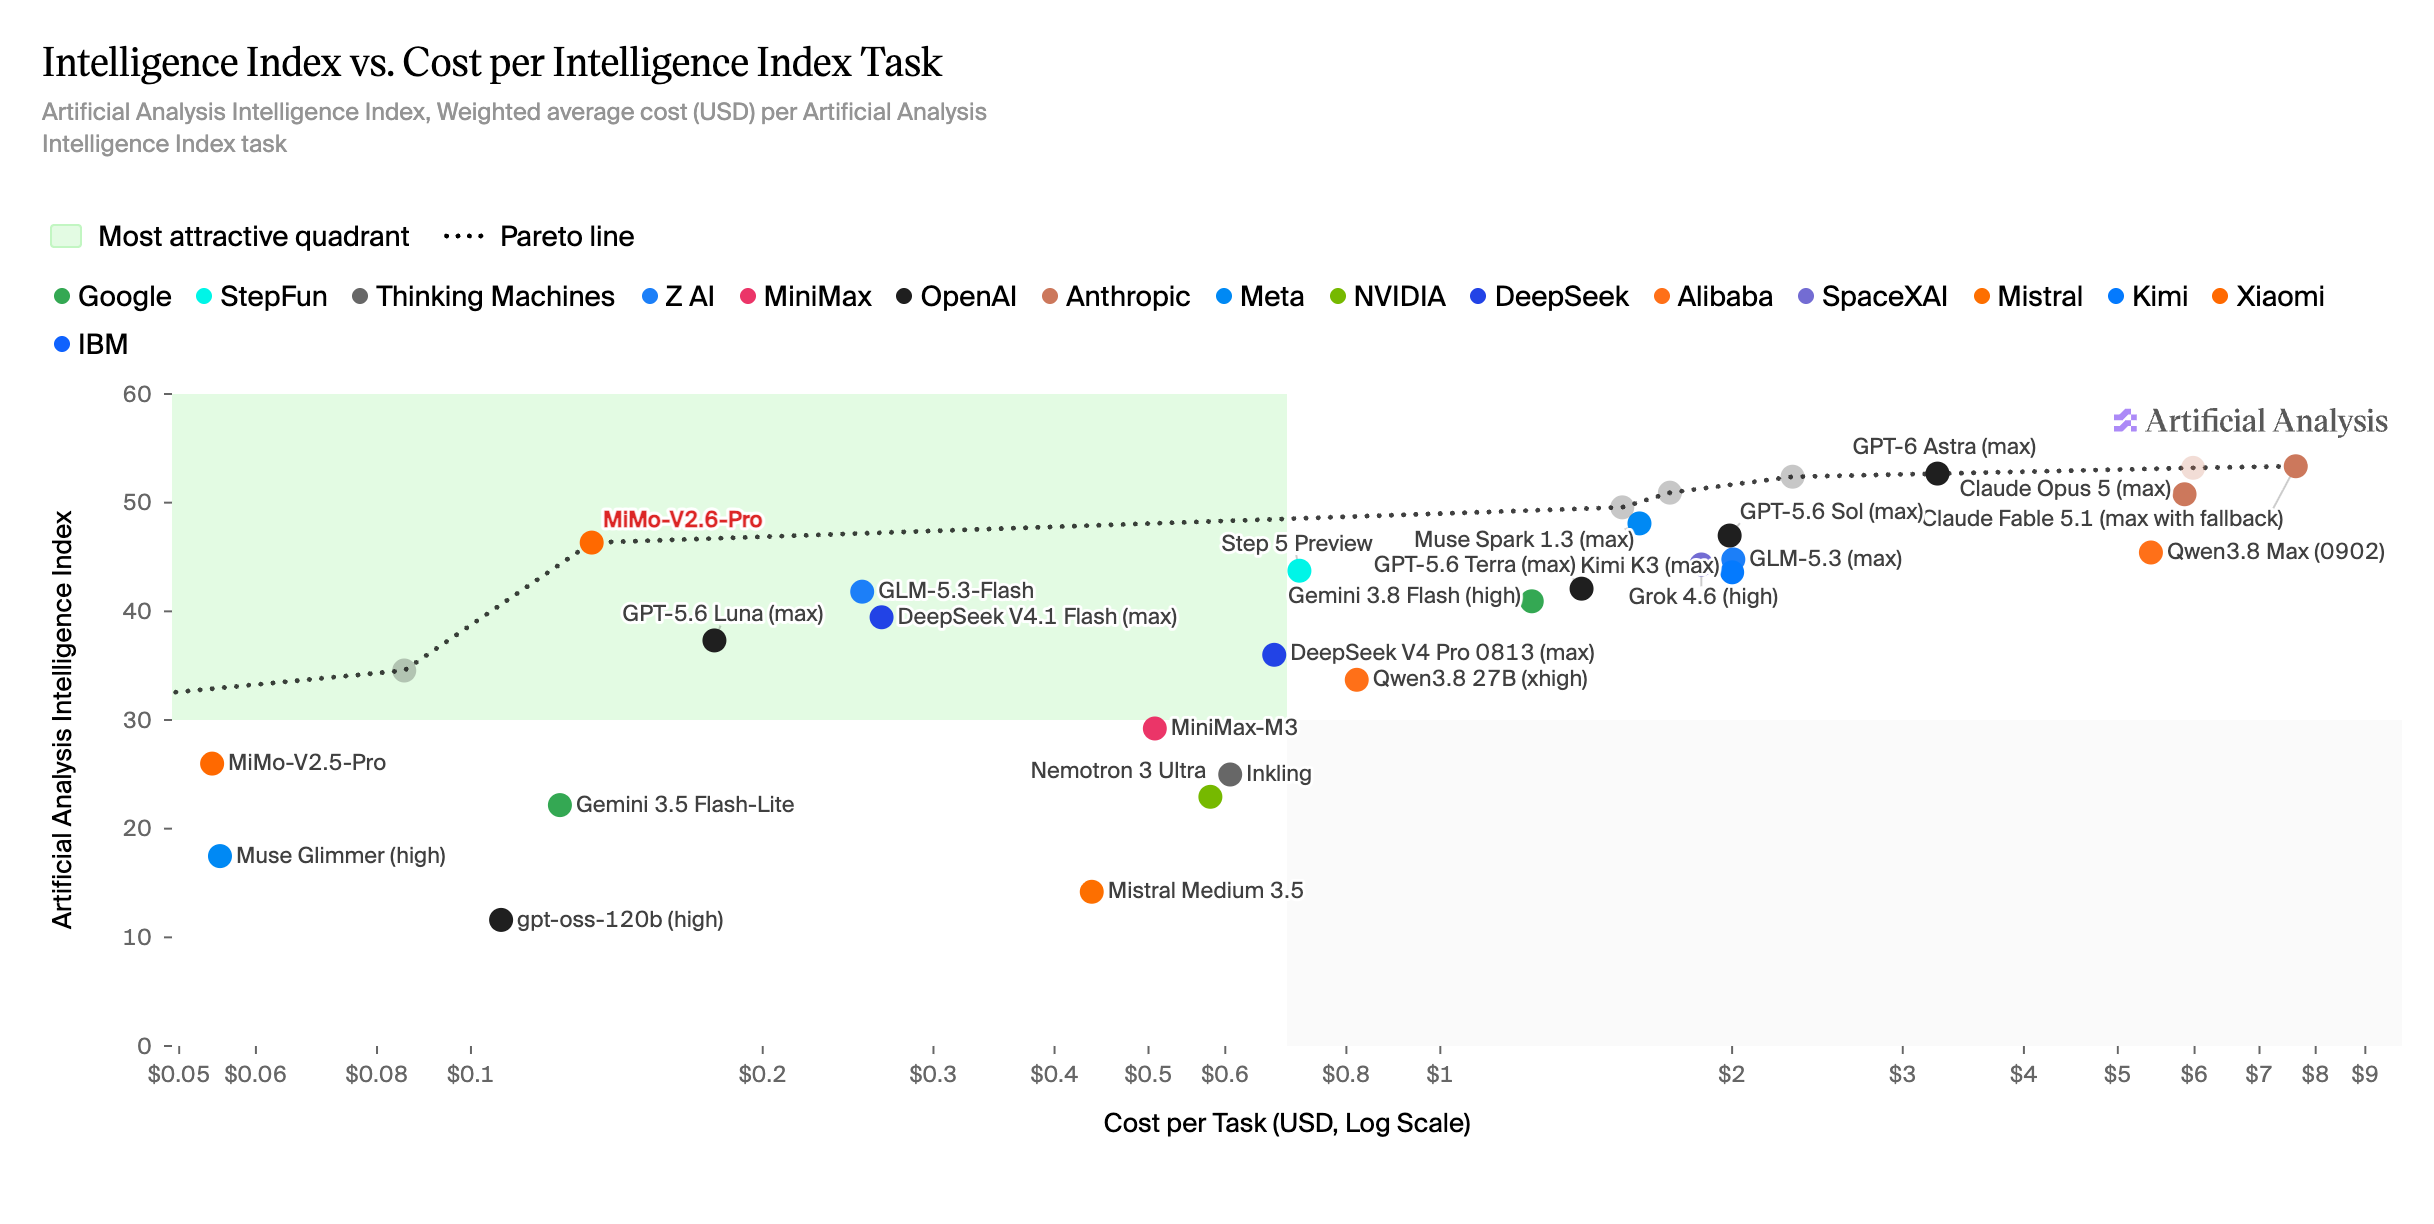
그러나 가격 쪽에서는 이야기가 달라집니다. MiMo 팀은 V2.5 시리즈의 API 가격표를 그대로 유지했습니다. 지능은 올라가고 비용은 그대로이므로, 작업 한 건당 비용 대비 지능을 그린 평면에서 파레토 경계가 한 번 더 바깥으로 밀려납니다. 아래 산점도에서 MiMo-V2.6-Pro는 작업당 0.15달러 안팎 지점에 놓여 있는데, 비슷한 점수대의 GLM-5.3(max)이나 Kimi K3(max)가 2달러 부근에 있는 것과 비교하면 자릿수가 다릅니다.
1.02T MoE 위에 올린 옴니모달 백본
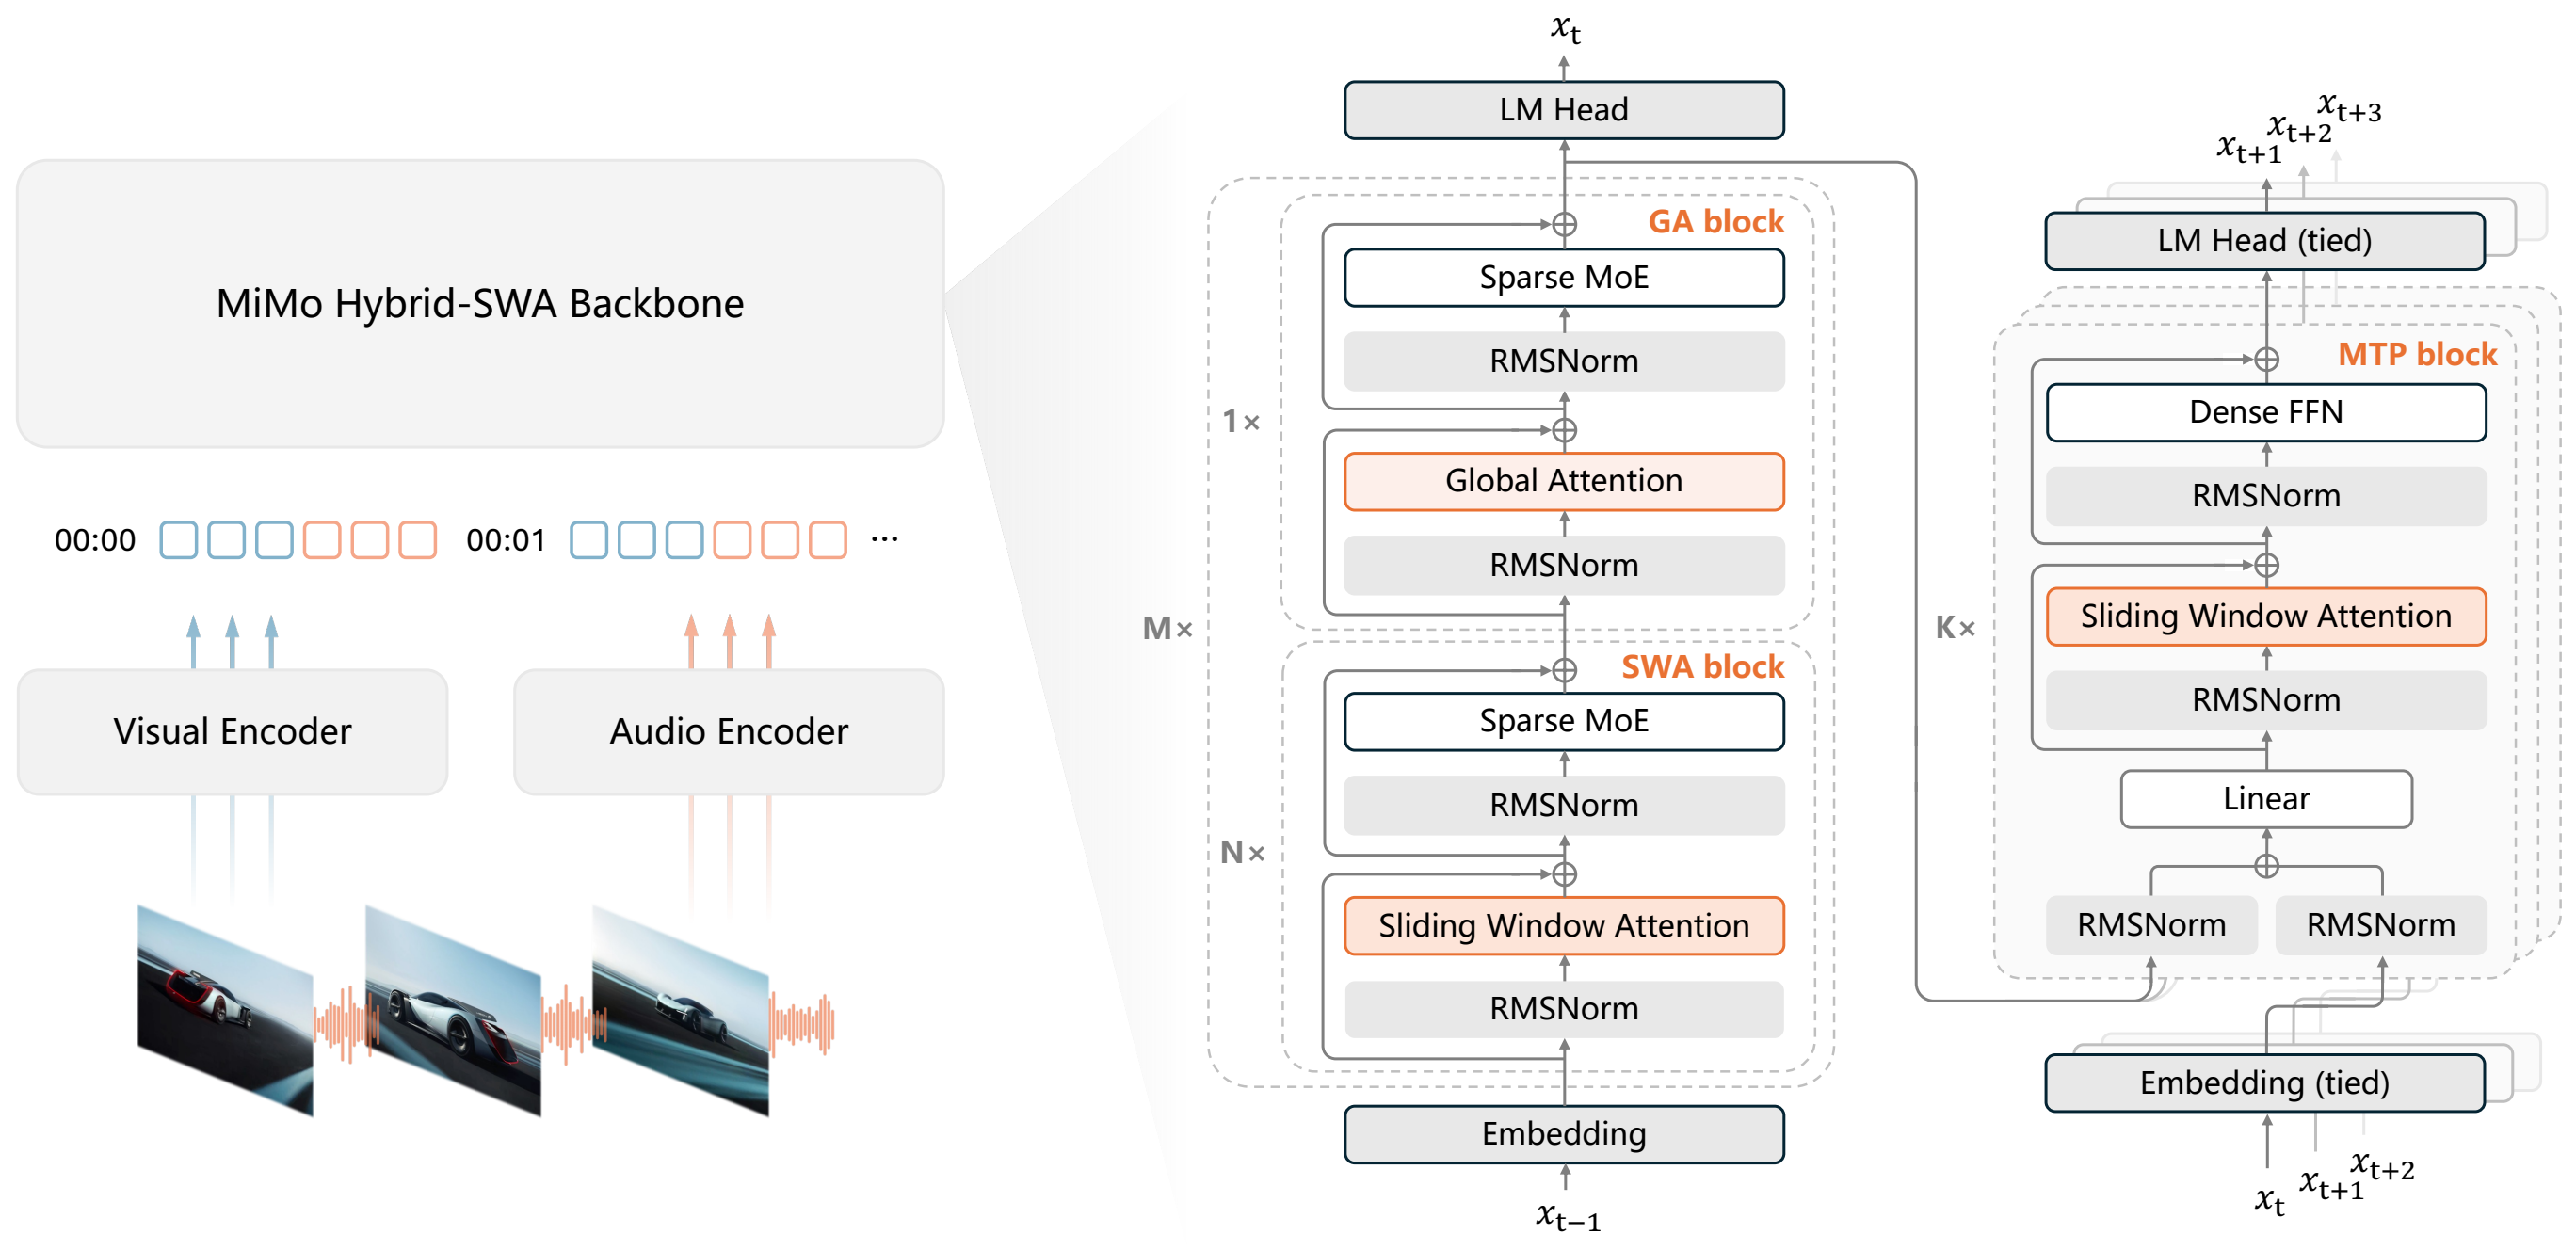
모델 구조는 시각과 음성 두 갈래의 입력 인코더, 하나의 하이브리드 백본, 그리고 투기적 디코딩(speculative decoding)용 헤드로 나뉩니다.
백본은 70개 레이어로, 이 중 60개가 슬라이딩 윈도우 어텐션(Sliding Window Attention, SWA), 10개가 전역 어텐션(Global Attention, GA)입니다. 첫 블록만 전역 어텐션에 밀집(dense) FFN을 쓰고 나머지 블록은 SWA와 GA를 번갈아 배치하면서 공유 전문가 없이 희소 MoE FFN을 사용합니다. 라우팅되는 전문가는 384개이고 토큰당 8개가 활성화됩니다. 히든 크기는 6144, 어텐션 헤드는 Q 128개에 KV 8개이며 슬라이딩 윈도우 크기는 128입니다.
시각 인코더인 MiMo ViT는 681M 파라미터에 28개 레이어(SWA 24개, GA 4개)로 구성되고, 패치 크기는 시간 2 곱하기 높이 16 곱하기 너비 16입니다. 음성 쪽은 20개의 잔차 벡터 양자화(Residual Vector Quantization, RVQ) 코드북을 가진 308M AudioTokenizer 인코더와 127M 오디오 패치 인코더로 나뉘며, 패치 하나가 네 프레임을 묶어 25Hz 입력을 6.25Hz로 줄입니다.
마지막으로 다중 토큰 예측(Multi-Token Prediction, MTP) 드래프터가 5개 SWA 레이어로 붙어 한 번의 순전파에서 뒤따르는 7개 토큰을 예측하고, 본 모델이 이를 병렬로 검증합니다. DFlash 계열 구조이며, 토큰을 하나씩 순차로 뽑는 대신 여러 개를 미리 뽑아 두고 한꺼번에 확인하므로 디코딩 처리량이 올라갑니다.
항목 MiMo-V2.6-Pro MiMo-V2.6-Flash 전체 파라미터 / 활성 파라미터 1.02T / 42B 310B / 15B 레이어 (전체 / SWA / GA) 70 / 60 / 10 48 / 39 / 9 라우팅 전문가 (전체 / 활성) 384 / 8 256 / 8 히든 크기 6144 4096 SWA 어텐션 헤드 (Q / KV) 128 / 8 64 / 8 GA 어텐션 헤드 (Q / KV) 128 / 8 64 / 4 헤드 차원 (QK / V) 192 / 128 192 / 128 슬라이딩 윈도우 크기 128 128 최대 컨텍스트 1M 토큰 1M 토큰 시각 인코더 MiMo ViT 681M, 28 레이어 동일 음성 인코더 AudioTokenizer 308M + 패치 인코더 127M 동일 투기적 디코더 5 레이어 SWA MTP, 윈도우 1024 5 레이어 SWA MTP, 윈도우 10246일, 30스텝, 75만 궤적: 강화학습 계산량을 키운 방식
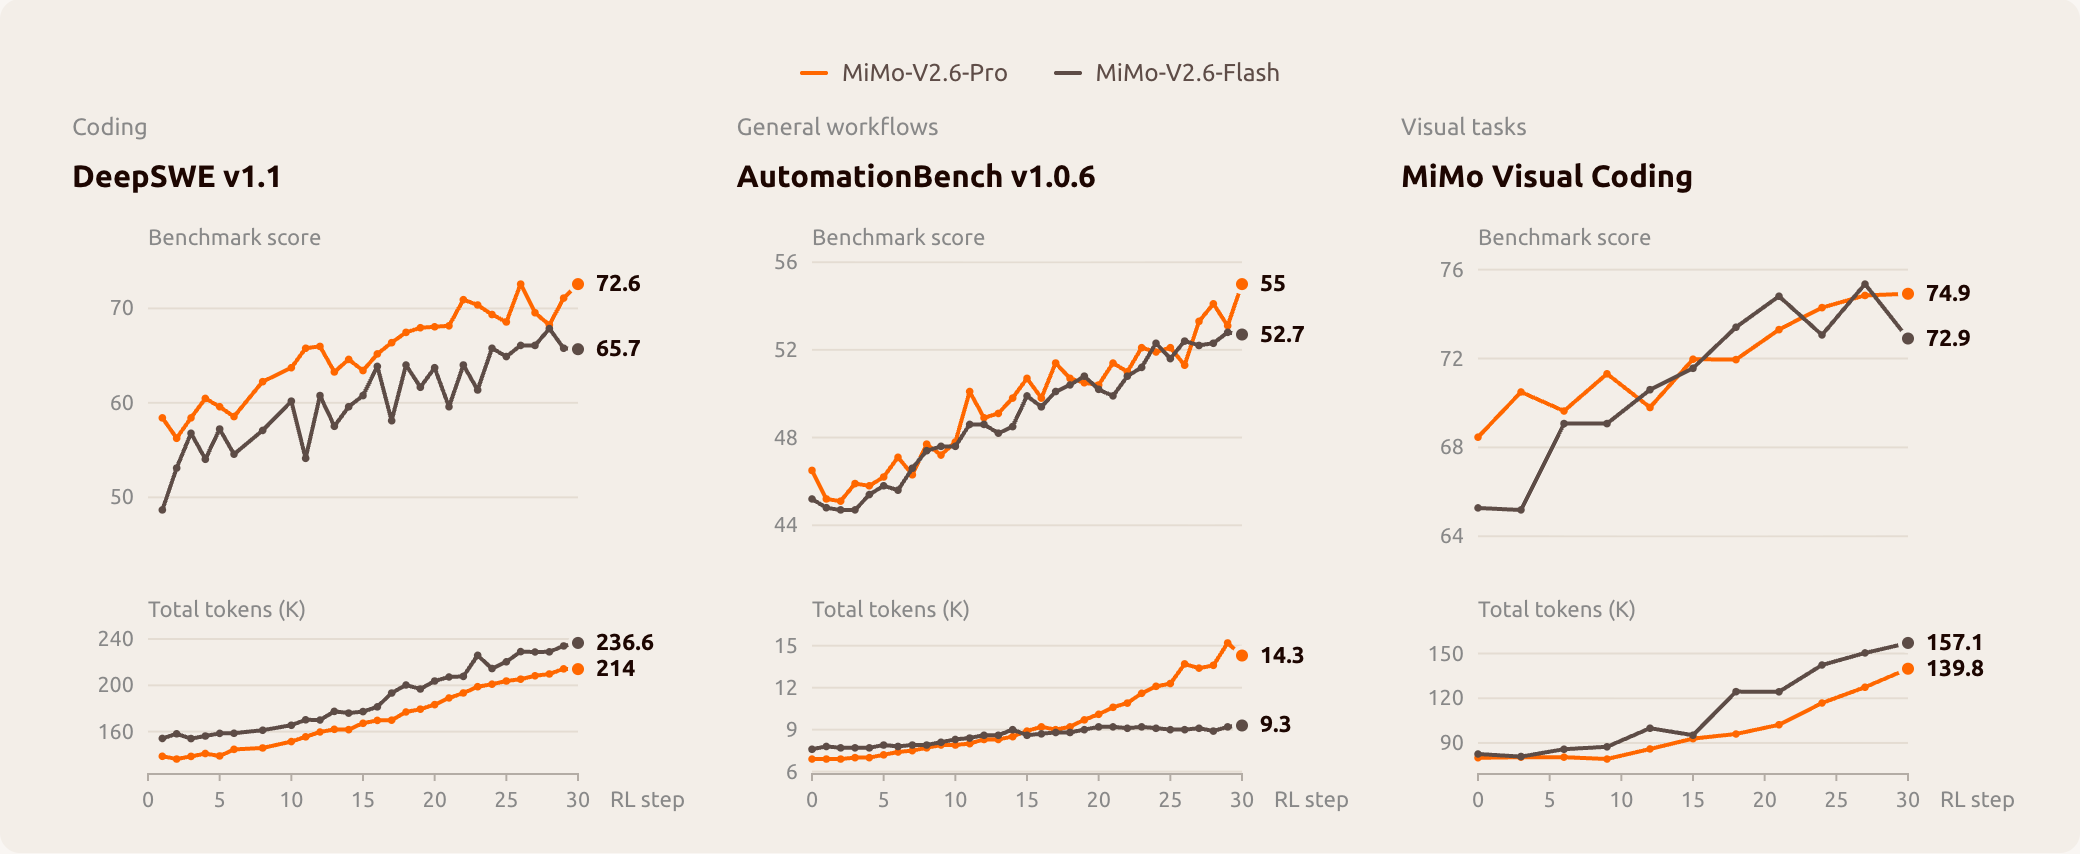
이번 릴리즈의 핵심은 여기입니다. MiMo-V2.6-Flash와 MiMo-V2.6-Pro는 각각 약 75만 개의 궤적(trajectory) 위에서 30번의 RL 스텝을 6일 이내에 마쳤고, 비용은 각각 약 85만 달러와 262만 달러가 들었습니다. 학습 과제의 평균 통과율은 상대 기준으로 각각 25%와 12% 올랐습니다.
한편 더 중요한 것은 학습에 쓰지 않은 벤치마크에서도 같은 방향으로 움직였다는 점입니다. 장기 과제형 소프트웨어 엔지니어링 벤치마크인 DeepSWE v1.1에서 Flash는 48.8점에서 65.68점으로 약 17점, Pro는 58.4점에서 72.57점으로 약 14점 올랐습니다. 아래 곡선을 보면 30스텝 내내 점수가 계속 오르고 있어서, 학습이 수렴해 멈춘 것이 아니라 계산량을 더 넣을 여지가 남아 있는 상태에서 끊긴 것에 가깝습니다.
MiMo 팀은 RL 계산량을 세 축으로 나누어 키웠다고 설명합니다.
-
더 큰 배치와 더 높은 처리량: 완전 비동기(fully asynchronous) 아키텍처 위에서 한 스텝에 1,568개 프롬프트를 쓰고, 각 프롬프트마다 그룹 크기 16으로 롤아웃(rollout)을 생성합니다. 그룹 상대 정책 최적화(Group Relative Policy Optimization, GRPO) 구성이며, 스텝 하나가 2만 5천 개 시퀀스, 시퀀스당 11만에서 15만 토큰, 합쳐서 2.7B에서 3.7B 학습 토큰이 됩니다. 최대 컨텍스트는 100만 토큰입니다. (블로그는 같은 값을 3.5B에서 3.7B로 적고 있습니다.)
-
더 많은 과제와 더 풍부한 환경: 코딩, 범용 에이전트, 시각, 사이버 보안을 아우르는 멀티태스크 학습 세트를 여러 하네스(harness)에 섞어 한 배치 안에 함께 넣습니다. 한 능력에서 얻은 개선이 다른 능력을 밀어 올리도록 만드는 구성이고, 모델 카드는 이를 "You Only RL Once" 라고 부릅니다. 도메인별로 RL을 따로 돌리지 않습니다.
-
더 많은 채점 계산량: 통과와 실패를 나누는 이진 보상만으로는 통과한 해답들 사이의 우열을 가릴 수 없습니다. 그래서 보상 신호 자체에 계산량을 투입해, 같은 그룹 안의 롤아웃끼리 상대 비교를 시킵니다. 장기 과제형 RL에 더 정밀하고 더 다양한 보상 신호가 들어가고, 모델은 더 짧은 경로와 더 적은 토큰으로 유도됩니다. 기술 보고서가 밝힌 Pro의 RL 비용 배분은 롤아웃 43.8%, 학습 43.5%, 채점 12.7%로, 채점에만 전체의 8분의 1가량이 들어갔습니다.
그룹 단위 채점으로 닫은 자기 개선 루프
세 번째 축을 구현한 장치가 두 가지입니다. 그룹 단위 보상 합성(Groupwise Reward Synthesis, GRS) 은 서로 대비되는 롤아웃들로부터 과제별 루브릭(rubric)을 오프라인에서 만들어 두고, 루브릭 품질 점수와 테스트 통과 결과를 합쳐 보상으로 씁니다. 그룹 단위 어드밴티지 재분배(Groupwise Advantage Redistribution, GAR) 는 통과한 궤적들을 온라인으로 순위 매겨 어드밴티지를 더 나은 해답 쪽으로 옮깁니다. 두 장치 모두 판단 기준이 외부 정답이 아니라 정책 자신이 뽑아낸 샘플이므로, 모델이 좋아질수록 채점 기준도 함께 올라가는 자기 개선 루프가 닫힙니다.
한편 학습 규모가 커지면서 따라오는 문제도 함께 다뤘습니다. 학습 중 드리프트를 억제하려고 MoE 라우터를 동결했고, 보상 해킹(reward hacking)에 대해서는 보상 설계와 적대적 평가, 이상 탐지, 검증기 간 교차 확인을 묶은 방어를 구성했습니다. 확인된 해킹 궤적은 그룹 통계를 다시 계산하기 전에 보상을 0으로 만들며, 기술 보고서는 이 보정 이후 확인된 해킹 비율이 두 모델 모두 학습 전 구간에서 2% 아래로 유지되었다고 밝혔습니다. 정렬(alignment) 쪽은 자기 교정에서 출발하는 콜드 스타트를 씁니다. 모델이 자신의 어긋난 응답을 돌아보고 근거 있는 다음 단계로 다시 쓰게 하는 방식입니다.
혼합 RL이 끝난 뒤에는 다중 프리픽스 다중 교사 온폴리시 증류(Multi-Prefix Multi-Teacher On-Policy Distillation, MOPD2) 를 적용합니다. 학생 모델이 스스로 만든 롤아웃과, 교사 궤적 및 지도 미세조정(SFT) 시연에서 가져온 앞부분을 조건으로 건 단일 턴 롤아웃을 함께 씁니다. 앞선 턴들을 다시 생성하지 않고도 의사 결정 지점만 골라 학습시킬 수 있어서, 검증하기 어려운 과제까지 능력을 넓히는 데 쓰입니다.
이질적인 과제를 대규모로 함께 돌리기 위한 시스템 작업도 적지 않습니다. 통합 궤적 표현과 페널티 메커니즘으로 더 세밀한 학습 신호를 만들었고, 여러 에이전트 프레임워크와의 고동시성 상호작용을 지원하도록 제어 평면(control plane)과 데이터 평면(data plane)을 분리해 대규모 궤적 이관을 가능하게 했으며, 혼합 배치 안에서 과제별 샘플링 비율이 흔들리지 않도록 안정화했으며, 학습 엔진과 추론 엔진 각각은 물론 둘 사이의 일관성까지 함께 최적화했습니다.
무엇을 함께 공개했는가
가중치만 던지고 끝내지 않은 부분이 이번 릴리즈에서 가장 실용적인 대목입니다. 기술 보고서는 세 가지를 함께 공개한다고 밝히고 있습니다. 첫째는 MiMo-V2.6-Distill-Qwen-9B입니다. Qwen3.5-9B를 MiMo가 생성한 데이터로 지도 미세조정한 9B 모델로, 학습 데이터는 코드와 사이버, 범용, 시각 네 도메인에 걸쳐 총 774억 토큰이고 이 중 손실 계산에 실제로 기여하는 토큰이 272억 개입니다. 원본 Qwen3.5-9B 대비 SWE-bench Pro가 32.0에서 44.6으로, AutomationBench가 5.0%에서 30.3%로 올랐습니다. 큰 모델을 돌릴 수 없는 연구자가 RL 실험을 시작할 공통 출발점으로 쓰라는 의도입니다.
둘째는 검증기가 붙은 RL 환경입니다. 네 도메인에 약 7천 개 과제가 들어 있고, 여기에 음악 생성 과제 약 1천 개가 더해집니다.
도메인 과제 유형 학습 과제 수 검증기 코드 소프트웨어 엔지니어링 약 3천 실행 가능한 테스트 사이버 취약점 재현 약 1천 규칙 검사 범용 지식 노동 약 1천 루브릭 기반 판정 시각 웹 개발 약 2천 시각 채점셋째는 이 환경을 실행하는 엔드투엔드 RL 프레임워크입니다. 기술 보고서는 위 9B 체크포인트에서 출발해 도메인별 GRPO를 돌린 베이스라인까지 함께 싣고 있는데, 표에 오른 11개 평가가 모두 개선되었습니다. SWE-bench Verified는 61.1에서 66.2로, Terminal Bench 2.1은 37.1에서 52.8로, MiMo Visual Coding(mini)은 64.0에서 72.4로 올랐습니다. 공개한 자원만으로 재현 가능한 출발선을 그려 둔 셈입니다.
에이전트 강화학습 환경의 공통 인터페이스에 관심이 있으시다면 다음 글도 함께 참고해주세요:
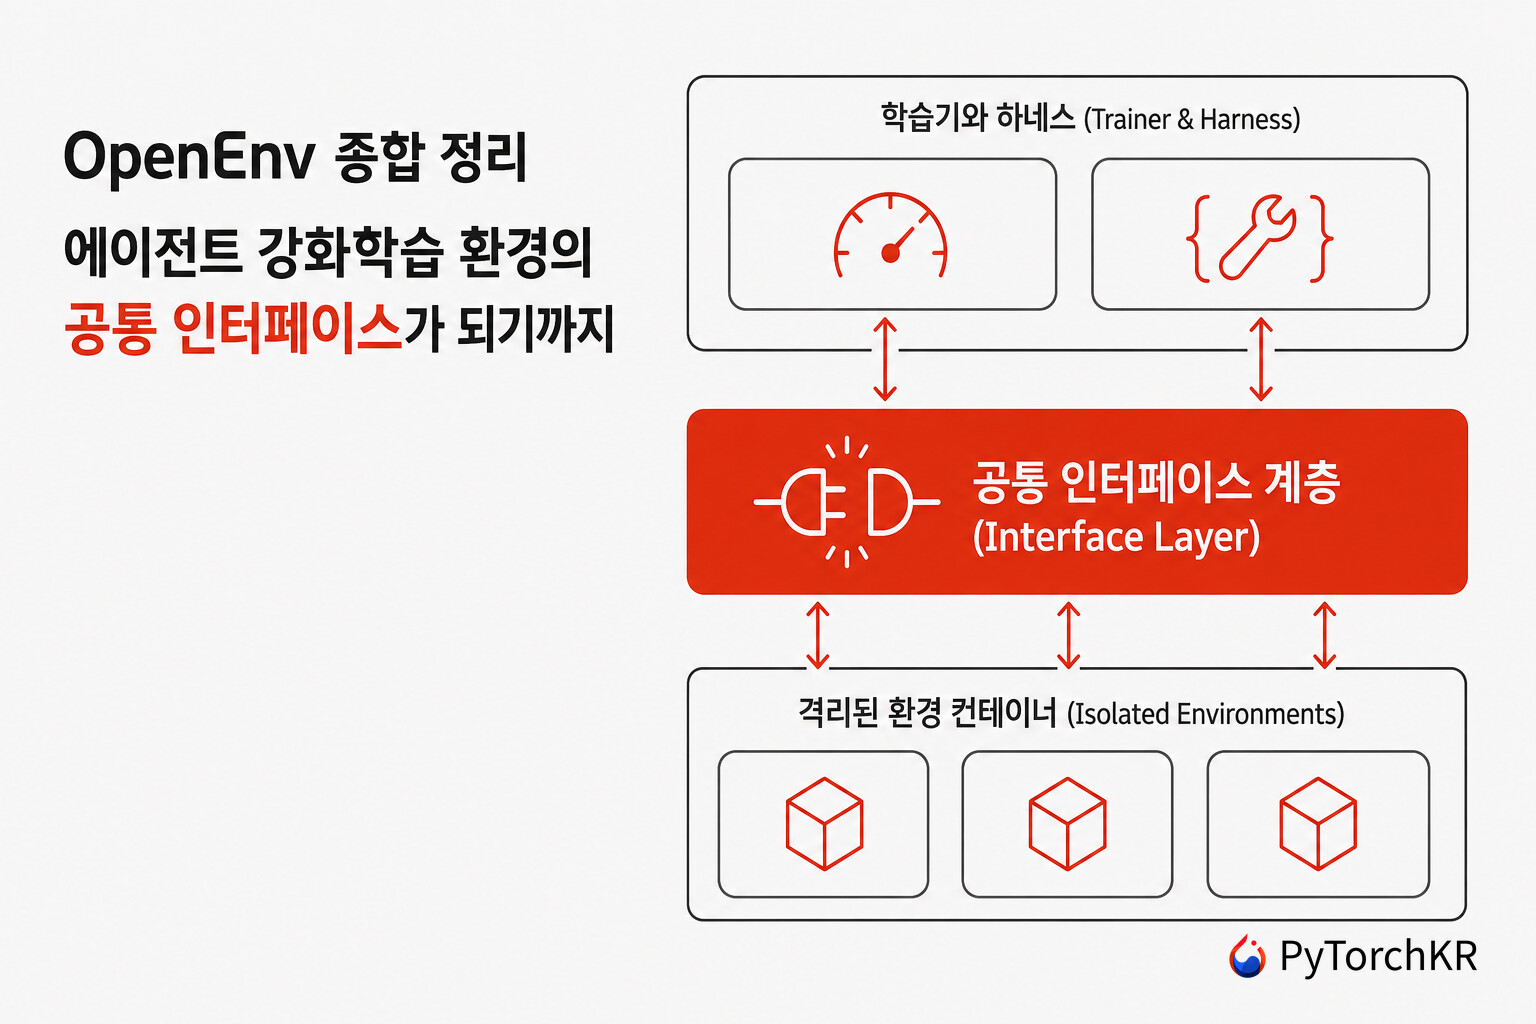
OpenEnv 프로젝트 소개: 에이전트 강화학습 환경의 공통 인터페이스가 되기까지 (feat. Meta, Hugging Face) 읽을거리&정보공유[OpenEnv 종합 정리, 에이전트 강화학습 환경의 공통 인터페이스 계층 구조도] OpenEnv 소개: 에이전트에게 부족한 것은 모델이 아니라 환경입니다 OpenEnv는 AI 에이전트가 상호작용할 환경(Environment) 을 만들고, 배포하고, 학습 루프에 연결하는 절차를 하나의 규격으로 묶는 오픈소스 인터페이스 라이브러리입니다. 터미널, 브라우저, 코드 저장소, 캘린더처럼 에이전트가 실제로 조작하는 대상을 격리된 컨테이너로 감싸고, 그 안에서 무엇을 볼 수 있고 무엇을 할 수 있는지를 명시적으로 선언합니다. 2025년 10월 Meta와 Hugging Face가 공동으로 시작했고, 2026년 6월에는 11개 조직으로 구성된 기술위원회가 운영을 맡는 중립 프로젝트로 전환했습니다. 강화학습(Reinforcement Learning, RL) 으로 에이전트를 학습시키려면 세 가지가 필요합니다. 정책을 갱신하는 학습기, 모델이 도구를 부르고 결과를 읽는 하네스(harness), 그…
벤치마크 결과
아래 두 표는 원문 블로그의 부록 표(2026년 9월 22일 스냅샷)를 정리한 것으로, 일부 수치는 모델 카드에 실린 값과 소수점 단위에서 다릅니다. 먼저 이전 세대 및 오픈 웨이트 경쟁 모델과의 비교입니다. Artificial Analysis가 보고한 Elo 등급인 GDPval-AA 2.1을 제외하면 모두 높을수록 좋은 점수이고, 대시는 결과가 없는 항목입니다.
벤치마크 MiMo-V2.6-Pro MiMo-V2.6-Flash MiMo-V2.5-Pro Kimi K3 DeepSeek V4.1 Flash 코딩 DeepSWE v1.1 71.9 67.9 19.0 69.0 74.2 ProgramBench 26.5 26.0 12.5 24.5 20.3 MiMo Code Bench 63.2 61.2 40.4 60.1 60.2 범용 GDPval-AA 2.1 1673 - 1107 1524 1600 Toolathlon-Verified 76.9 73.6 49.1 76.5 - AutomationBench v1.0.6 53.1 52.3 16.0 46.7 54.8 Agents' Last Exam 31.6 27.6 13.2 28.3 31.8 Terminal Bench 4.0 34.9 28.8 1.5 12.6 26.8 Terminal Bench 2.1 89.9 87.6 65.2 88.3 90.6 OSWorld-Verified 82.0 80.8 - 84.8 - JobBench 62.0 61.2 25.0 54.3 45.8 시각 MiMo Visual Coding 72.3 71.5 - 70.3 70.6 보안 CyberGym 94.0 95.1 40.0 80.0 88.1 ExploitGym 17.8 6.0 0.1 8.1 15.3 ExploitBench 47.9 25.3 16.6 32.2 - SEC Bench Pro 66.3 47.5 17.7 - 62.8 MiMo Cyber Bench 81.7 77.2 0.0 56.3 62.7위 표를 통해 세 가지를 확인할 수 있습니다. 첫째, MiMo-V2.5-Pro와의 격차가 벤치마크 종류를 가리지 않고 큽니다. Terminal Bench 4.0에서 1.5점이 34.9점으로, MiMo Cyber Bench에서 0.0점이 81.7점으로 올랐습니다. 둘째, Flash는 Pro와 대부분의 항목에서 몇 점 차이 안에 들어 있고 CyberGym에서는 오히려 앞섭니다. 셋째, 오픈 웨이트 경쟁 모델과 비교하면 승패가 항목마다 갈립니다. DeepSWE v1.1과 Terminal Bench 2.1은 DeepSeek V4.1 Flash가, OSWorld-Verified는 Kimi K3가 앞섭니다.
다음은 상용 프론티어 모델과의 비교로, 비교 대상 프론티어 모델에 결과가 하나도 없는 자체 제작 벤치마크는 제외했습니다.
벤치마크 MiMo-V2.6-Pro Claude Opus 5 GPT-5.6 Sol Claude Fable 5.1 GPT-6 Astra 코딩 DeepSWE v1.1 71.9 74.0 - - 74.0 ProgramBench 26.5 37.0 25.0 - - MiMo Code Bench 63.2 68.6 59.3 - 61.4 범용 GDPval-AA 2.1 1673 1708 1588 1735 1542 Toolathlon-Verified 76.9 80.6 74.9 77.8 - AutomationBench v1.0.6 53.1 50.3 45.8 - 52.0 Agents' Last Exam 31.6 31.6 30.8 - 34.2 Terminal Bench 4.0 34.9 49.0 39.9 55.1 59.6 Terminal Bench 2.1 89.9 89.1 88.8 91.4 89.9 OSWorld-Verified 82.0 83.4 83.0 - - JobBench 62.0 65.7 45.4 - - 시각 MiMo Visual Coding 72.3 70.0 73.4 74.4 82.2 보안 ExploitGym 17.8 22.1 30.3 30.4 42.4 ExploitBench 47.9 70.0 78.5 83.0 100.0 SEC Bench Pro 66.3 - 79.1 - 85.4프론티어 대비로는 항목별 편차가 뚜렷합니다. AutomationBench v1.0.6과 Terminal Bench 2.1에서는 MiMo-V2.6-Pro가 앞서거나 동률이지만, Terminal Bench 4.0과 ExploitBench처럼 난이도가 높은 최신 벤치마크에서는 격차가 20점에서 50점까지 벌어집니다. Cognition이 Kimi K3 기반으로 만든 SWE-2가 특정 영역에서 프론티어에 1점 차로 붙은 사례와 비교해 보면, 오픈 웨이트 모델이 어떤 축에서 따라잡고 어떤 축에서 아직 벌어져 있는지가 드러납니다.
바이브 코딩에서 바이브 월드로
MiMo 팀은 코딩 능력이 소프트웨어 엔지니어링을 넘어 일반화했다고 주장하면서, 자연어로 소프트웨어를 만드는 단계에서 상호작용 가능한 세계를 만드는 단계로 넘어간다는 의미에서 이를 "바이브 월드(Vibe World)" 라고 부릅니다. 3D 공간 추론(3D spatial reasoning)과 멀티모달 인식, 그리고 컴퓨터 사용 에이전트(Computer-Use Agent, CUA) 능력이 한 모델에 모인 결과입니다.
게임 개발에서는 이미지나 영상, 텍스트 프롬프트를 받아 요청을 여러 과제로 분해하고, 여러 에이전트를 조율해 3D 장면을 구성하며 상호작용 로직을 구현한 뒤 시각적으로 검증합니다. 렌더링 결과를 보고 다시 고치는 과정을 반복해 실행 가능한 상호작용 세계를 만들어 냅니다.
https://mimocode-cdn.xiaomimimo.com/mimocode/blog/mimo-v2-6/02.mp43D 모델링에서는 텍스트 설명이나 참조 이미지를 받아 Blender 안에서 3D 오브젝트와 장면을 생성합니다. 애니메이션, 3D 프린팅, 게임 개발용 에셋을 만드는 용도입니다.
임바디드 시뮬레이션(Embodied Simulation) 에서는 여러 대의 카메라 피드를 직접 입력으로 받아 계속 추론하고 판단하면서, 시각 피드백을 통한 폐루프 제어로 Franka Panda 로봇 팔을 움직입니다. 물체를 집고, 색을 맞추고, 정확한 위치에 놓는 작업을 수행합니다. 로봇 데이터 쪽 접근은 같은 회사의 Xiaomi-Robotics-1 연구와 함께 놓고 보면 흐름이 더 잘 읽힙니다.
https://mimocode-cdn.xiaomimimo.com/mimocode/blog/mimo-v2-6/07.mp4프론트엔드, 슬라이드, 영상까지 이어지는 시각 작업
MiMo-V2.6은 짧은 지시 하나에서 완결된 프론트엔드 인터페이스나 슬라이드 덱을 만들어 냅니다. 구조화된 레이아웃과 컴포넌트, 상호작용 요소와 애니메이션까지 포함되고, Figma와 이미지 및 영상 생성 도구를 다룰 수 있어서 전체 스타일에 맞는 시각 에셋을 함께 만듭니다.
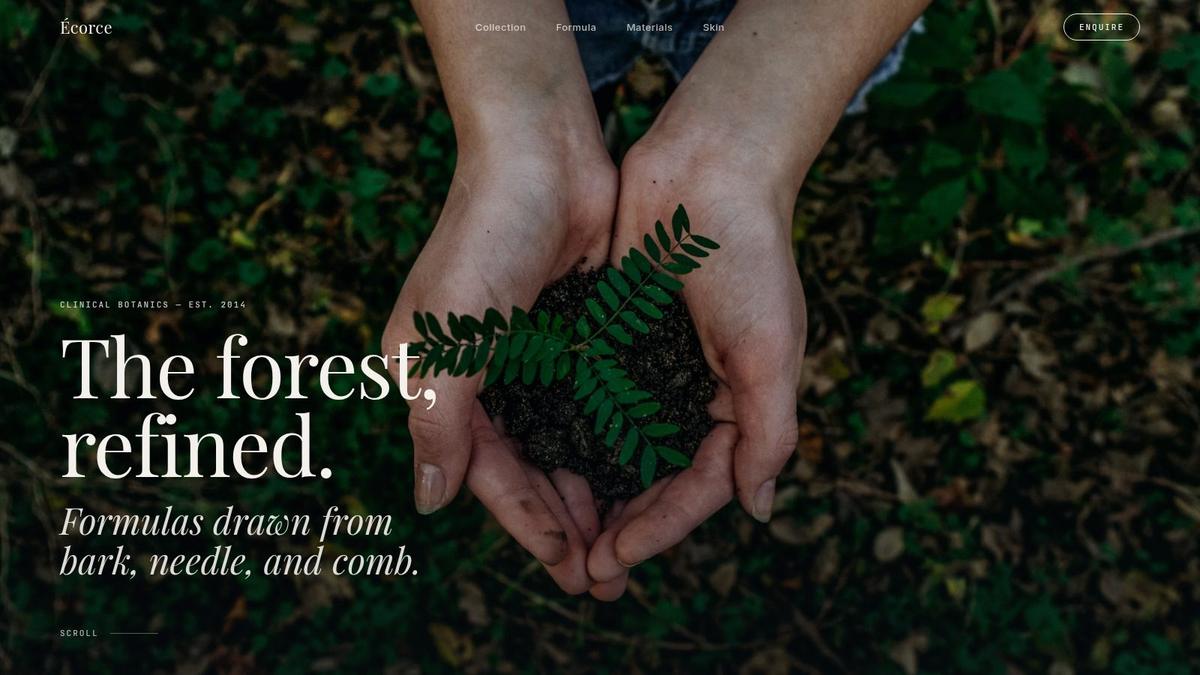
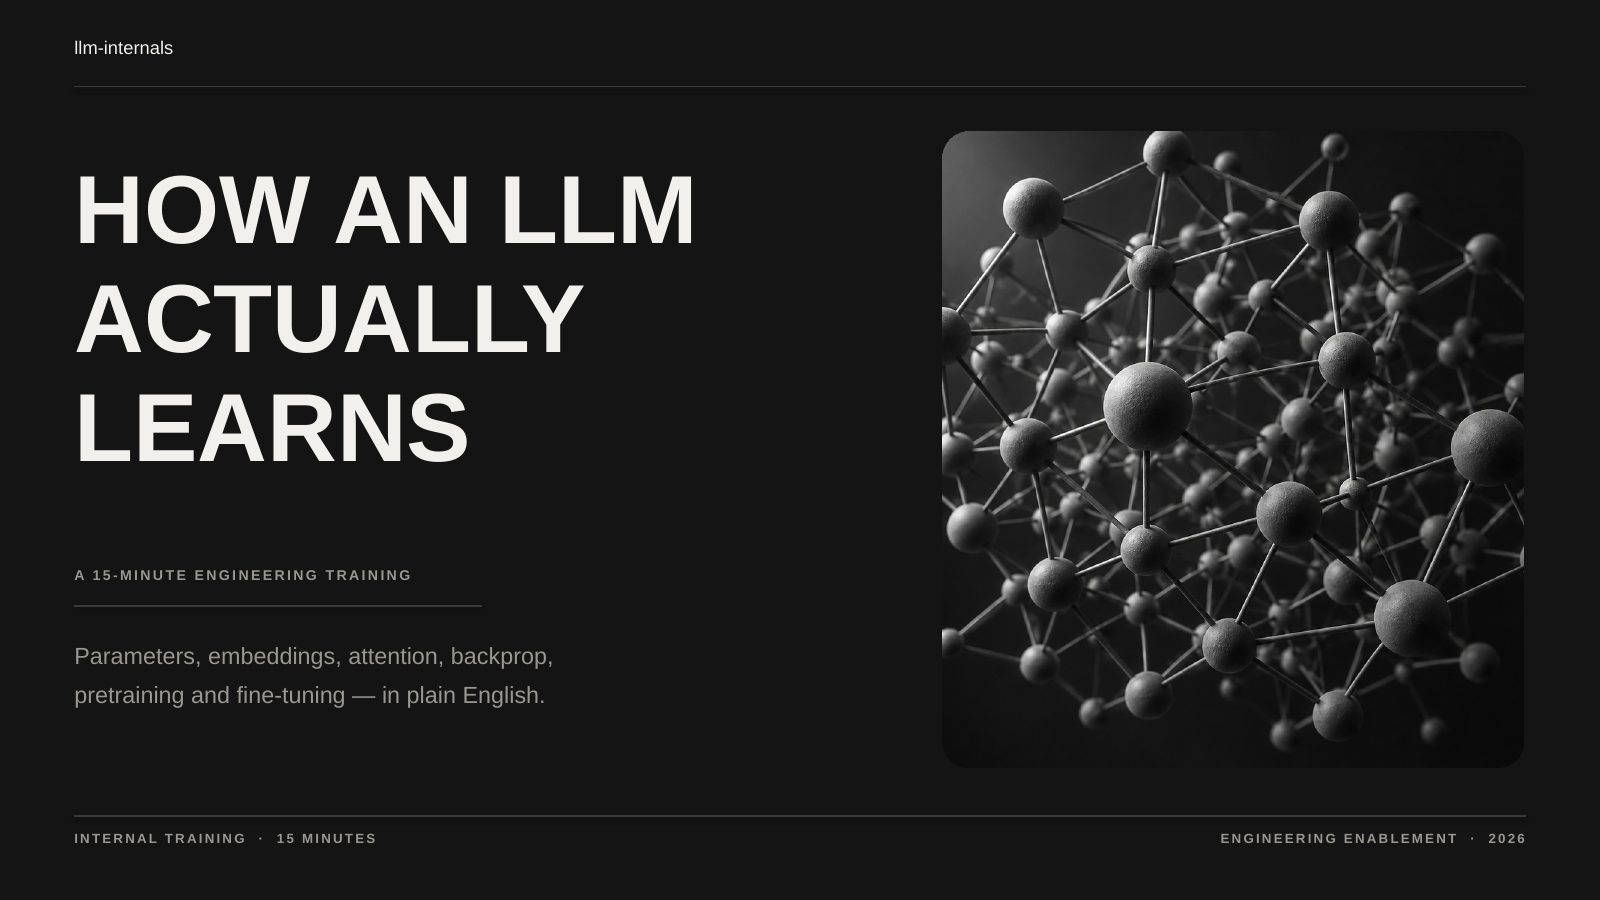
슬라이드 쪽에서는 한 줄짜리 요청 개요(brief)에서 덱 하나를 만들어 내는 사례 세 건을 공개했습니다. LLM이 어떻게 학습하는지를 설명하는 사내 엔지니어링 교육 자료, 핵심 광물 슈퍼사이클(supercycle)을 다룬 리서치 노트, 그리고 어떤 회사의 첫 연차 보고서 방향 세 가지를 제안하는 디자인 리뷰입니다.
영상 제작은 시각 디자인부터 샷과 모션 구성, 음악 작곡, 비트에 맞춘 편집까지 한 흐름으로 처리합니다. 교육용 영상에서는 푸리에 분해 같은 추상 개념을 설명 가능한 형태로 풀고 애니메이션으로 옮긴 뒤, MiMo-V2.5-TTS로 화면에 정확히 맞춘 내레이션을 생성합니다.
https://mimocode-cdn.xiaomimimo.com/mimocode/blog/mimo-v2-6/19.mp4작곡: 데모 수준까지 올라온 첫 시도
MiMo 팀은 음악 이해와 미적 판단, 음악 지식 활용을 이번 버전에서 강화했고 이를 작곡에 대한 첫 탐색이라고 설명합니다. 공개된 사례에서는 MiMo-V2.6-Pro에게 약 10개 악기로 구성된 관현악곡을 요청했고, 모델이 악보를 쓴 뒤 스스로 MIDI로 변환했습니다. 결과물인 "Night Road" 는 현악기, 오보에, 클라리넷, 트럼펫, 트롬본, 프렌치 호른, 글로켄슈필, 팀파니로 편성되어 있습니다.
https://mimocode-cdn.xiaomimimo.com/mimocode/blog/mimo-v2-6/16.mp4두 번째 사례에서는 A단조 피아노곡 두 곡을 느린 템포와 중간 템포로 각각 요청했습니다. MiMo 팀은 이 결과물이 데모 수준이며 전문 작곡가와 편곡자를 돕는 보조 도구로서의 가능성을 보여 준다고 선을 그었습니다.
연구 보조: MOF 설계와 Lean 4 정리 형식화
과학 연구를 겨냥한 별도의 강화학습을 하지 않았는데도 몇몇 연구 영역에서 쓸 만한 결과가 나왔다는 것이 MiMo 팀의 설명입니다. 두 가지 사례가 공개되었습니다.
소재 연구 보조: PFAS를 잡는 MOF 설계
Xiaomi의 소재 전문가들은 MiMo-V2.6-Pro에게 과불화 화합물(per- and polyfluoroalkyl substances, PFAS) 을 흡착하는 새로운 금속 유기 골격체(Metal-Organic Framework, MOF) 를 설계하게 했습니다. PFAS는 자연에서 분해되지 않아 "영원한 화학물질" 로 불리는 물질군입니다. 모델은 웹 검색으로 관련 문헌과 특허를 훑고 가설을 세운 뒤 신규성을 평가했고, 이어 오픈소스 계산 도구를 호출해 시뮬레이션 환경을 자동으로 구성하고 MOF와 PFAS 사이의 결합 세기를 계산해 후보를 골랐습니다.
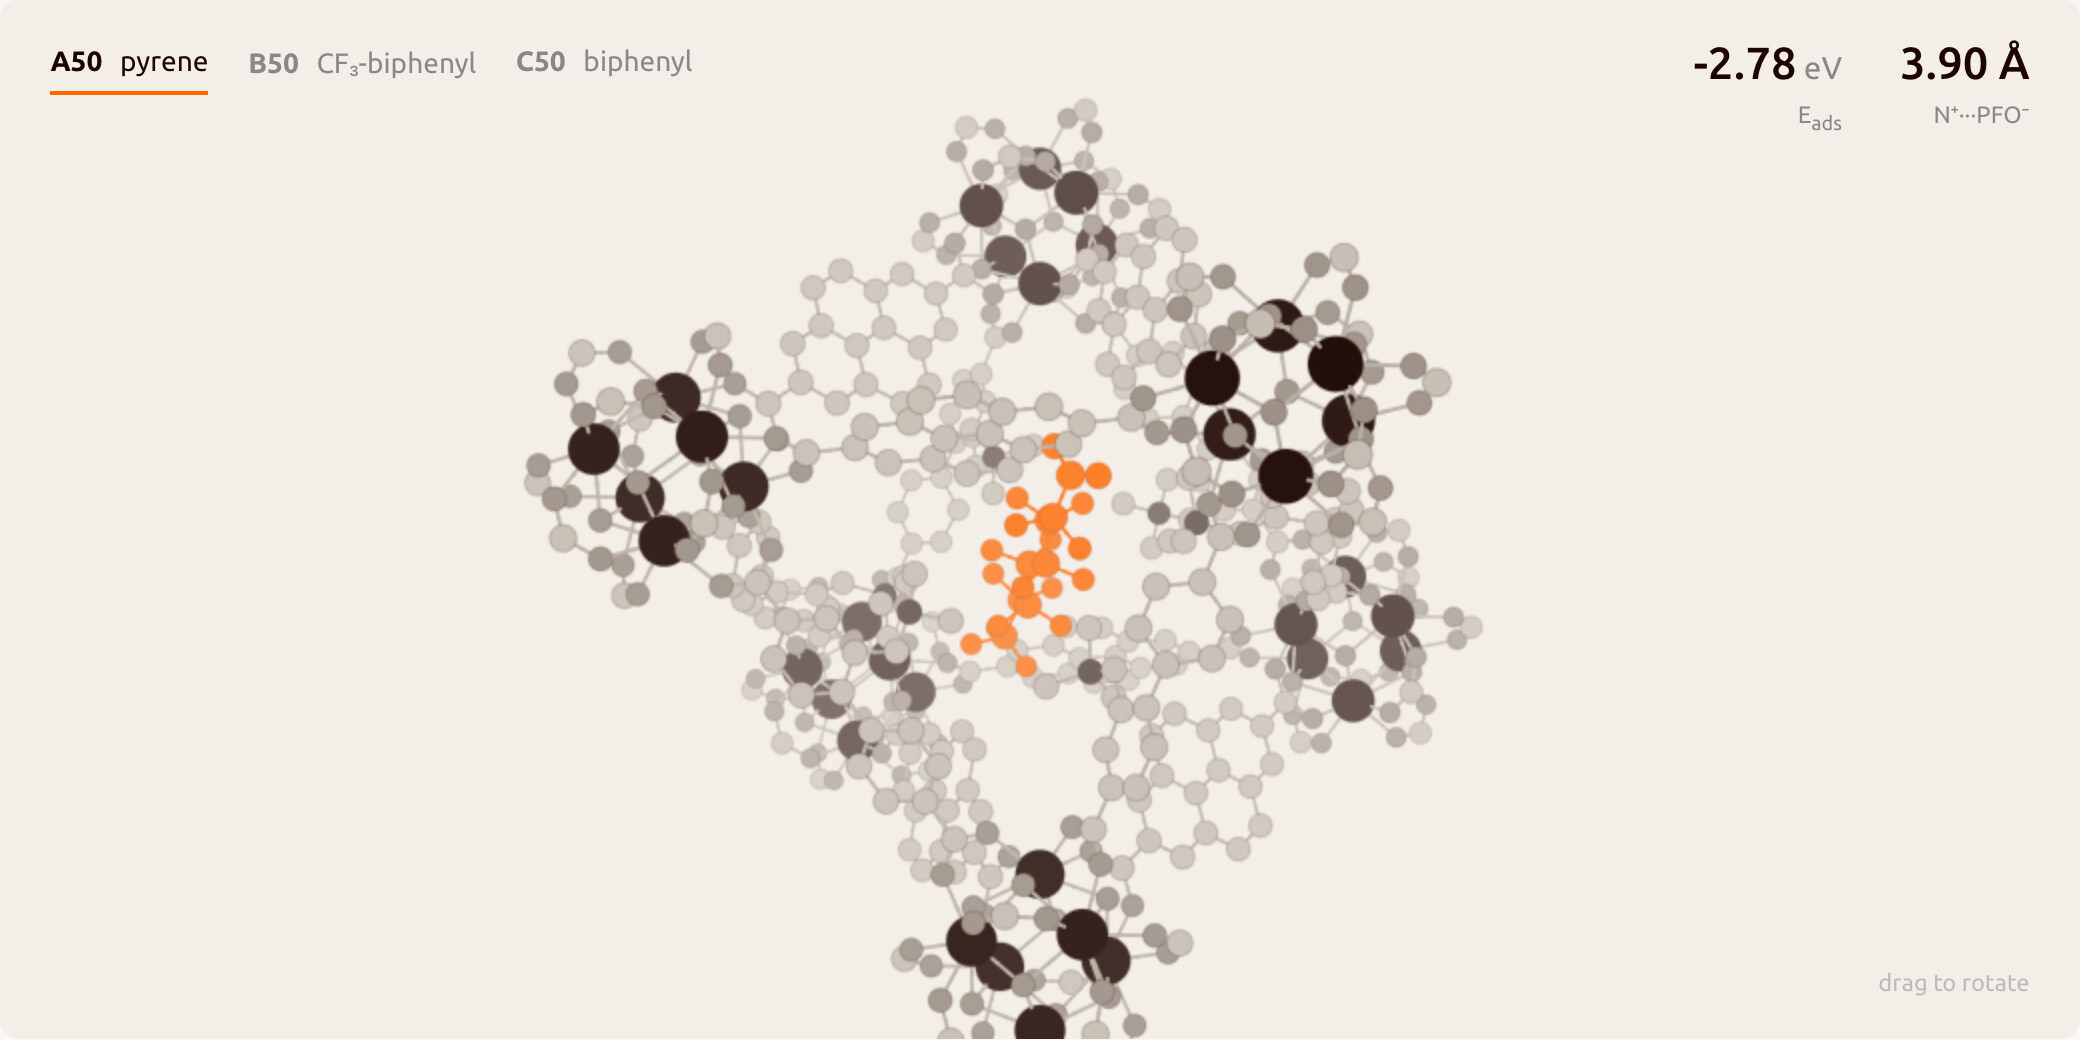
세 후보는 모두 UiO-67 계열 Zr₆ 골격체이고 세공 벽 리간드만 다릅니다. 모델 자신의 최적화 계산에서 나온 값은 다음과 같습니다.
후보 리간드 흡착 에너지 E_\text{ads} \mathrm{N}^+ \cdots \mathrm{PFO}^- 거리 A50 파이렌(pyrene) -2.78 eV 3.90 Å B50 CF₃-비페닐 -2.63 eV 3.92 Å C50 비페닐 -2.26 eV 4.04 Å다만 여기까지는 이른바 "건식 실험" 단계이고, 실제 합성과 측정을 거치는 습식 실험은 남아 있습니다. 전체 과정은 별도 케이스 스터디로 공개되어 있습니다.
Lean 4로 옮긴 리와 요크의 정리
두 번째 사례는 Lean 4 형식화입니다. MiMo-V2.6-Pro는 연구자들과 함께 리(Li)와 요크(Yorke)의 고전 논문 "Period Three Implies Chaos" 의 주 정리 전체를 형식화했습니다. 구간에서 자기 자신으로 가는 연속 사상에 주기 3인 궤도가 존재하면 모든 양의 정수 주기의 궤도가 존재하고, 나아가 비가산 스크램블 집합(scrambled set)이 존재한다는 정리입니다.
연구자들이 설계한 탐색 전략을 따라 모델은 서브에이전트 협업으로 정리 서술과 증명을 함께 밀고 나갔습니다. 이후 수정과 통합을 거친 프로젝트는 6,000줄이 넘는 Lean 소스 코드로 완성되었고, 미완성 증명 자리 표시자 없이 Lean 커널의 검증을 통과했습니다. 모델은 Lean 전용 사후 학습을 전혀 받지 않았습니다. 전체 Lean 코드는 zip 파일로 내려받을 수 있습니다.
정리 증명 형식화에 LLM을 붙이는 흐름은 최근 여러 곳에서 동시에 진행되고 있습니다. 관련해서는 Claude가 11일 만에 완성한 페르마의 마지막 정리 Lean 증명이나 LLM 피드백 증류로 Lean 정리 증명을 학습시킨 Meta FAIR 연구를 함께 보시면 좋습니다.
사용 방법과 가격
MiMo-V2.6-Pro와 MiMo-V2.6-Flash는 AI Studio, MiMo Code, MiMo Desktop에서 바로 쓸 수 있고, MiMo API 플랫폼과 OpenRouter를 통해서도 호출할 수 있습니다. 터미널 코딩 에이전트인 MiMo Code는 이전에 MiMoCode라는 이름으로 소개한 바 있습니다.
MiMo Desktop은 이번에 얼리 액세스를 벗고 첫 정식 버전을 배포했으며, 두 모델이 기본 탑재됩니다. UltraSpeed 모드도 여기에서 함께 출시되었습니다. 기존 얼리 액세스 프로그램은 일주일 더 운영되고, 이미 접근 권한이 있다면 새 모델 이름으로 바꿔야 계속 쓸 수 있습니다.
API 가격은 V2.5에서 그대로입니다. 단위는 100만 토큰당 미국 달러이고, 캐시 쓰기는 한시적으로 무료입니다. 중국 지역의 위안화 가격은 가격 페이지에 별도로 표기되어 있습니다.
모델 입력 (캐시 적중) 입력 (캐시 미스) 출력 MiMo-V2.6-Flash $0.0028 $0.14 $0.28 MiMo-V2.6-Pro $0.0036 $0.435 $0.87 MiMo-V2.6-Pro-UltraSpeed $0.036 $4.35 $8.7직접 서빙하려면 SGLang 또는 vLLM을 쓰면 됩니다. 모델 카드는 SGLang 쪽을 권장하며, 아래는 2노드 구성 예시입니다.
sglang serve \
  --trust-remote-code \
  --model-path XiaomiMiMo/MiMo-V2.6-Pro-RL \
  --tp 16 \
  --dp 2 \
  --enable-dp-attention \
  --mm-enable-dp-encoder \
  --ep 16 \
  --moe-a2a-backend deepep \
  --moe-dense-tp-size 1 \
  --mem-fraction-static 0.7 \
  --max-running-requests 128 \
  --chunked-prefill-size 32768 \
  --page-size 64 \
  --swa-full-tokens-ratio 0.3 \
  --speculative-algorithm EAGLE \
  --speculative-num-steps 3 \
  --speculative-eagle-topk 1 \
  --speculative-num-draft-tokens 4 \
  --enable-multi-layer-eagle \
  --reasoning-parser mimo \
  --tool-call-parser mimo \
  --host 0.0.0.0 \
  --port 30000 \
  --nnodes 2 \
  --node-rank <node-rank> \
  --dist-init-addr <node0-ip>:20000
vLLM은 MiMo-V2.5 레시피를 그대로 따르면 되고, vllm/vllm-openai:mimov25-cu129 이미지가 준비되어 있습니다.
vllm serve XiaomiMiMo/MiMo-V2.6-Pro-RL \
  --tensor-parallel-size 8 \
  --trust-remote-code \
  --gpu-memory-utilization 0.95 \
  --max-model-len auto \
  --reasoning-parser mimo \
  --tool-call-parser mimo \
  --enable-auto-tool-choice \
  --generation-config vllm
권장 샘플링 설정은 temperature=1.0, top_p=0.95 입니다.
MiMo-V2.6 시리즈의 라이선스
MiMo-V2.6-Pro-RL과 MiMo-V2.6-Flash-RL은 모델 카드에 MIT 라이선스로 명시되어 배포되고 있어, 연구 목적은 물론 상업적 용도로도 자유롭게 사용 및 수정이 가능합니다. 별도의 LICENSE 파일 대신 모델 카드 메타데이터에 선언되어 있습니다.
MiMo-V2.6 시리즈 소개 블로그
mimo.xiaomi.comMiMo-V2.6 | Xiaomi
Introducing the MiMo-V2.6 series: frontier intelligence, all the modalities, built in public.
MiMo-V2.6-Pro-RL 모델 카드
huggingface.coXiaomiMiMo/MiMo-V2.6-Pro-RL · Hugging Face
We’re on a journey to advance and democratize artificial intelligence through open source and open science.
MiMo-V2.6 컬렉션
huggingface.coMiMo-V2.6 - a XiaomiMiMo Collection
We’re on a journey to advance and democratize artificial intelligence through open source and open science.
MiMo-V2.6-Distill-Qwen-9B 모델 카드
huggingface.coXiaomiMiMo/MiMo-V2.6-Distill-Qwen-9B · Hugging Face
We’re on a journey to advance and democratize artificial intelligence through open source and open science.
MiMo-V2.6 RL 학습 과정 공개 페이지
mimo.xiaomi.commimo-v2.6 RL
Training metrics of the mimo-v2.6-pro and mimo-v2.6-flash reinforcement-learning runs, live from the trainer's logs.
MiMo-V2.6 기술 보고서
huggingface.coMiMo_V2_6_technical_report.pdf
140.32 KB
Xiaomi MiMo GitHub 조직
GitHubXiaomi MiMo
Ignite every curiosity with creative spark. Ask Mi Anything! - Xiaomi MiMo
더 읽어보기
-
Xiaomi, 1.02T 파라미터 오픈소스 MoE 추론 모델 MiMo-v2.5 및 MiMo-v2.5-Pro 출시
-
Kimi K3, Moonshot AI가 공개한 세계 첫 3T급 오픈 웨이트 모델 (전체 가중치 공개는 7월 27일 예정)
-
Cognition, Kimi K3 기반 코딩 모델 SWE-2 공개: Fable 5.1과 1점 차, 비용은 64% 절감
-
OpenEnv 프로젝트 소개: 에이전트 강화학습 환경의 공통 인터페이스가 되기까지 (feat. Meta, Hugging Face)
-
페르마의 마지막 정리, Claude가 11일 만에 Lean으로 작성한 첫 컴퓨터 검증 증명 (≠ 새로운 증명 발견)
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
파이토치 한국 사용자 모임에서 이런 글들을 계속 정리하고 있습니다. 회원 가입으로 주요 글들을 이메일로, 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 새 글 알림을 받아보세요!
아래쪽에 좋아요를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
1개의 게시물 - 1명의 참여자
https://discuss.pytorch.kr/t/xiaomi-rl-1-02t-mimo-v2-6-1/11981