
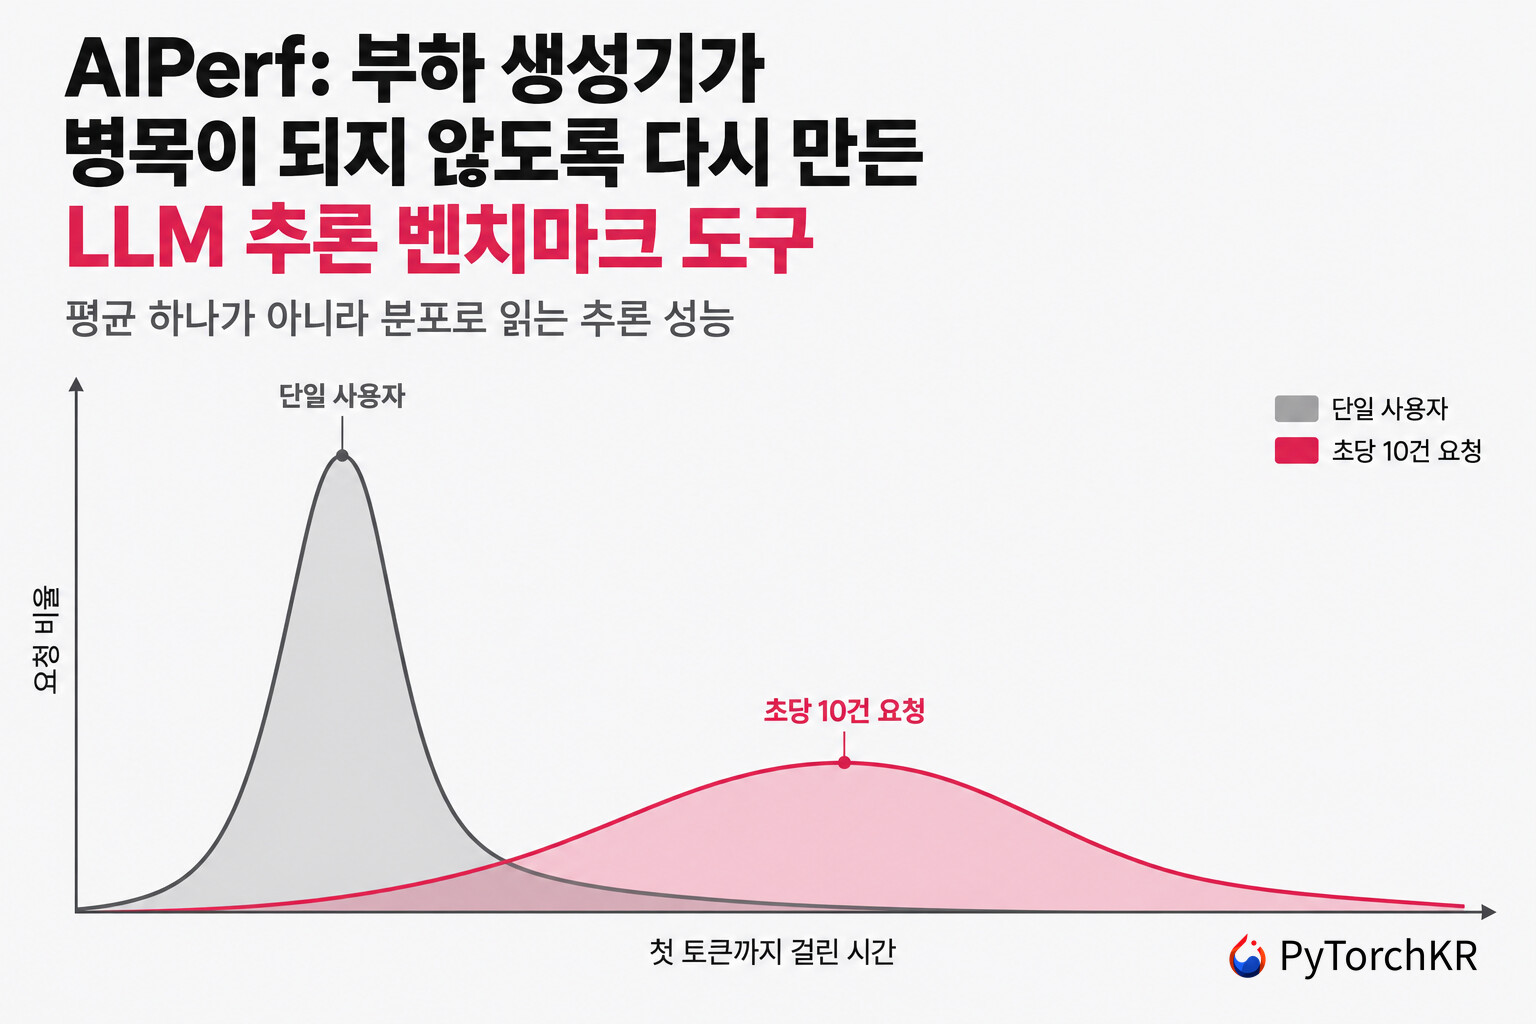


AIPerf: 서버 성능 측정 시, 부하 생성기가 병목이 되지 않도록 NVIDIA가 개발 및 공개한 LLM 추론 벤치마크 도구
AIPerf 소개: 측정 도구가 측정 대상을 가려 버리는 문제
모델을 서버에 올리고 프롬프트를 던지면 응답이 돌아옵니다. 그다음에 반드시 나오는 질문은 "이거 빠른 건가요?" 입니다. 이 질문에 답하려고 개발자들이 가장 먼저 하는 일은 대개 curl을 몇 번 날려 보거나, asyncio 기반의 짧은 부하 스크립트를 직접 짜거나, 일회용 부하 생성기를 하나 더 만드는 것입니다. NVIDIA 기술 블로그가 지적하는 문제는 이 세 갈래가 결국 같은 곳에서 무너진다는 점입니다. 단일 프로세스의 성능 한계에 걸리거나, 파이썬의 전역 인터프리터 잠금(Global Interpreter Lock, GIL) 이 동시성을 제한하거나, 애초에 자기가 만든 기준선에 대고 측정한 숫자가 나옵니다. 어느 쪽이든 완전히 신뢰하기 어려운 결과가, 요구사항이 바뀌는 순간 다시 짜야 하는 도구에 묶인 채로 남습니다.
이 문제가 LLM 서빙에서 유독 고약한 이유가 있습니다. 부하 생성기가 병목이 되면 측정값은 서버의 성능이 아니라 클라이언트의 성능을 반영하게 되는데, 겉으로는 구분이 되지 않습니다. 서버가 낼 수 있는 토큰 속도보다 클라이언트가 파싱할 수 있는 속도가 낮으면 리포트에는 낮은 쪽 숫자가 찍히고, 그 숫자를 근거로 GPU를 더 사는 결정이 내려집니다. 게다가 LLM 추론은 요청 하나가 수 초 동안 스트리밍되면서 수십에서 수백 개의 청크를 보내기 때문에, 부하 생성기가 처리해야 하는 이벤트 수가 일반적인 HTTP 벤치마크와 자릿수가 다릅니다.
AIPerf는 이 지점을 겨냥해 NVIDIA가 바닥부터 다시 만든 생성형 AI 추론(inference) 벤치마크 도구입니다. NVIDIA는 AIPerf를 Triton Inference Server의 perf_analyzer 안에 있던 GenAI-Perf의 지정된 후속 도구(designated successor) 로 규정하고, GenAI-Perf가 얹혀 있던 Perf Analyzer 위에서 돌아가는 구조 자체를 끊어 냈습니다. 저장소는 ai-dynamo 조직 아래에 있어 같은 조직의 추론 프레임워크인 Dynamo와 나란히 관리되고, Apache License 2.0으로 공개되어 있으며, PyPI에는 aiperf 패키지로 올라가 있습니다. 2026년 9월 21일 기준 최신 버전은 0.12.0이고 Python 3.11 이상 3.14 미만을 요구합니다.
이 글은 2026년 9월 18일에 Francesco Di Natale, Elias Bermudez, Anthony Casagrande, Matthew Kotila, Harshini Komali, Ganesh Kudleppanavar가 함께 쓴 NVIDIA 기술 블로그 Benchmarking LLM Inference at Scale with AIPerf를 바탕으로, 원문이 짧게 스치고 지나간 개념들을 AIPerf 저장소의 문서로 보강해 정리한 것입니다.
세 개의 평면으로 나눈 구조: 클라이언트가 병목이 되지 않는다는 것
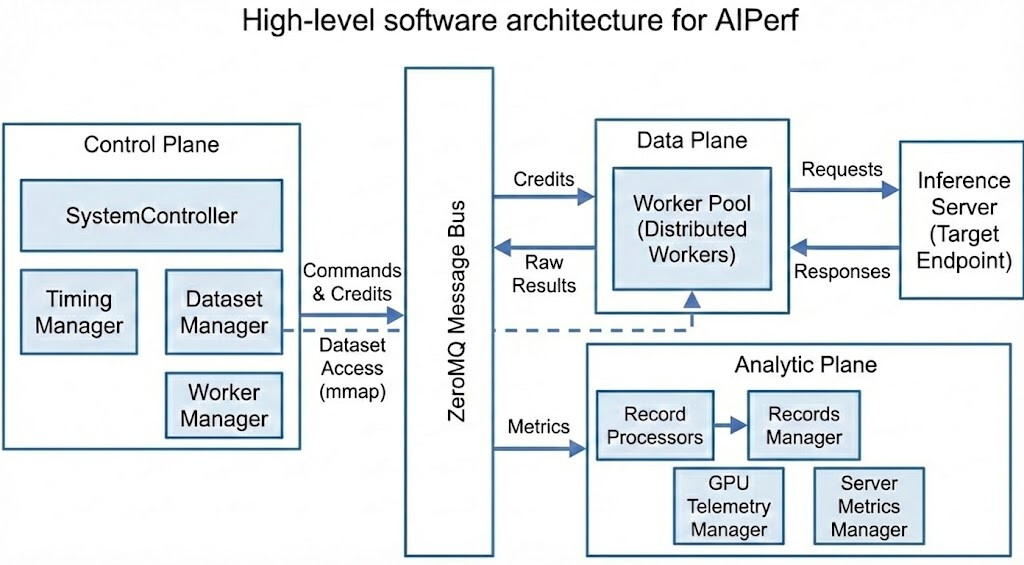
AIPerf가 "클라이언트가 병목이 되지 않는다"고 말할 때 그것은 구호가 아니라 프로세스 배치의 결과입니다. 저장소 README는 AIPerf를 10개의 서비스가 ZeroMQ 메시지 버스로 통신하는 다중 프로세스 구조라고 요약합니다. 아키텍처 문서는 이 서비스들을 역할에 따라 세 개의 평면으로 나눕니다.
평면 구성 요소 하는 일 제어 평면(Control Plane) SystemController, Timing Manager, Dataset Manager, Worker Manager 무엇을, 언제, 얼마나 보낼지 결정 데이터 평면(Data Plane) Worker 풀, 추론 서버 실제 요청과 응답의 입출력 수행 분석 평면(Analytic Plane) Record Processor, Records Manager, GPU Telemetry Manager, Server Metrics Manager 지표 계산과 텔레메트리 수집핵심은 요청을 보내는 주체와 결과를 해석하는 주체가 서로 다른 프로세스라는 점입니다. Worker는 HTTP 요청을 보내고 응답 타이밍만 기록한 뒤 곧바로 다음 요청으로 넘어가고, 스트리밍 청크를 파싱해서 TTFT와 ITL을 계산하는 무거운 일은 Record Processor가 별도 프로세스에서 병렬로 처리합니다. GIL이 문제가 되는 지점이 바로 이 파싱과 계산인데, 그것을 요청 발송 경로에서 떼어 냈기 때문에 Worker를 10개, 50개, 100개로 늘리는 것이 그대로 부하 용량 증가로 이어집니다. Worker들 사이에는 조율이 없으므로 수평 확장에 조정 비용도 들지 않습니다.
부하의 시점을 맞추는 방식도 눈여겨볼 만합니다. AIPerf는 Timing Manager가 발급하는 크레딧(credit) 을 Worker가 받아야만 요청을 보낼 수 있는 구조입니다. 요청을 언제 보낼지 결정하는 책임이 Worker가 아니라 중앙의 Timing Manager에 있으므로, 포아송 분포에 따른 불규칙한 도착이든 트레이스에 기록된 실제 시각이든 동일한 메커니즘으로 재현됩니다. 데이터셋 역시 메시지로 주고받지 않고 메모리 맵 파일(memory-mapped file) 에 써 두어 Worker가 직접 읽게 함으로써, 프롬프트 전달이 메시지 버스의 부하가 되지 않도록 했습니다.
이 구조 위에서 원문이 내세우는 두 가지 폭이 나옵니다. 하나는 워크로드의 폭입니다. 원문은 15종 이상의 엔드포인트 타입을 지원한다고 적었는데, 저장소의 플러그인 정의 파일을 직접 세어 보면 현재 등록된 엔드포인트 플러그인은 19종입니다(폴백용 raw 와 플러그인 개발용 template 포함). 채팅과 텍스트 완성, OpenAI Responses API, Anthropic Messages API, 임베딩, 리랭킹(NIM, Hugging Face TEI, Cohere 각각 별도 구현), 음성 인식, 이미지 생성과 편집, 영상 생성까지 들어 있습니다. 여기에 ShareGPT 같은 공개 데이터셋과 Mooncake, Baseten, WEKA 등의 프로덕션 트레이스 재생 포맷이 더해집니다.
다른 하나는 부하 모양의 폭입니다. 총량만 정하는 것이 아니라 요청이 어떤 리듬으로 도착하는지, 동시성과 요청 속도를 얼마 동안 서서히 올릴지, 입출력 길이를 vLLM과 SGLang의 range-ratio 방식으로 흩뿌릴지까지 지정할 수 있습니다. 도착 리듬은 뒤에서 따로 다룹니다.
첫 벤치마크: vLLM 위의 Qwen3-0.6B에 정적 128/128 부하 걸기
원문의 실습은 vLLM으로 서빙한 Qwen3-0.6B를 대상으로 합니다. 모델 선택은 의도적입니다. GPU 한 장에서 돌아갈 만큼 작고, 기다리지 않고 반복할 수 있을 만큼 빠릅니다. 목적은 Qwen3-0.6B 자체를 평가하는 것이 아니라 측정 루프를 만드는 것이고, 루프가 손에 익으면 다른 모델이나 엔드포인트로 바꾸는 것은 플래그 하나를 고치는 일이 됩니다.
서버는 vLLM의 OpenAI 호환 컨테이너를 그대로 씁니다. 추론 파서를 켜 두는 것이 중요한데, 그 이유는 뒤의 TTFT 절에서 설명합니다. 한 가지 덧붙이면, 저장소의 기본 튜토리얼은 같은 명령에 --enforce-eager 를 더 붙입니다. CUDA 그래프 캡쳐를 끄는 옵션이라 기동은 빨라지지만 디코딩 성능은 달라지므로, 블로그의 숫자와 튜토리얼의 숫자를 나란히 놓고 비교할 생각이라면 이 차이를 먼저 맞춰야 합니다.
docker pull vllm/vllm-openai:latest
docker run --gpus all -p 8000:8000 -e HF_TOKEN vllm/vllm-openai:latest \
  --model Qwen/Qwen3-0.6B \
  --reasoning-parser qwen3 \
  --host 0.0.0.0 --port 8000
AIPerf 설치는 uv로 한 벌을 전역에 두거나, 가상 환경 안에 넣는 두 가지 방법이 있습니다.
uv tool install aiperf
uv venv venv
source venv/bin/activate
uv pip install aiperf
플랫폼과 관련해 한 가지 주의할 점이 있습니다. Linux aarch64(arm64) 에서는 의존성 중 하나인 crick 이 소스 배포본만 제공하므로 설치 시점에 C 컴파일러가 필요합니다. Debian과 Ubuntu 계열은 build-essential, RHEL 계열은 Development Tools 를 미리 깔아 두어야 하고, 설치가 그 패키지에서 멈춰 있다면 원인은 십중팔구 이것입니다. x86_64 Linux와 macOS, Windows는 미리 빌드된 휠을 받으므로 툴체인이 필요 없습니다.
서버가 준비되고 AIPerf 설치가 끝났으면 첫 프로파일을 실행합니다.
aiperf profile \
  --model Qwen/Qwen3-0.6B \
  --endpoint-type chat \
  --streaming \
  --url localhost:8000 \
  --synthetic-input-tokens-mean 128 \
  --synthetic-input-tokens-stddev 0 \
  --output-tokens-mean 128 \
  --output-tokens-stddev 0 \
  --extra-inputs min_tokens:128 \
  --extra-inputs ignore_eos:true
실행 중에는 대시보드가 실행됩니다. 정확히는 대화형 터미널에서만 dashboard 가 기본값이고, 출력이 파이프나 리다이렉션으로 넘어가는 비대화형 환경에서는 자동으로 none 이 됩니다. 화면은 세 구역으로 나뉘어 위쪽 3분의 2의 왼편에 진행 상황이, 오른편에 백분위별로 쪼갠 지표가 실시간으로 갱신되고, 아래쪽 3분의 1에는 백엔드 로그가 흐릅니다. 대시보드 대신 진행 막대만 보는 simple 모드도 있으며, --verbose 를 주면 터미널에서도 자동으로 simple 로 바뀝니다. CI에서 돌릴 때 --ui none 을 따로 붙일 필요는 없습니다.
대시보드 오른편을 자세히 보면 AIPerf가 클라이언트에서 잰 값만 보여주는 것이 아니라는 점을 알 수 있습니다. 접두어 캐시 적중률(Prefix Cache Hit Rate), KV 캐시(Key-Value Cache) 사용률, 서버에서 실행 중인 요청 수와 대기 중인 요청 수, 선점(preemption) 횟수 같은 항목이 함께 올라와 있습니다. 이것은 AIPerf가 모델 엔드포인트의 /metrics 경로를 수집하는 서버 지표(server metrics) 기능으로, 기본값이 활성화입니다. 클라이언트가 관측한 지연이 길어졌을 때 그것이 큐 대기 때문인지 KV 캐시 압박 때문인지를 별도 도구 없이 같은 화면에서 대조할 수 있습니다.
플래그 네 개가 결과를 좌우합니다
위 명령에서 겉보기보다 훨씬 큰 일을 하는 플래그가 넷 있습니다. 벤치마크 결과가 재현되지 않거나 남의 숫자와 어긋난다면 대개 이 넷 중 하나가 빠져 있습니다.
--synthetic-input-tokens-stddev 0 과 --output-tokens-stddev 0: 입력과 출력을 정확히 128토큰으로 고정합니다. 요청 길이와 출력 길이를 상수로 고정하는, 널리 쓰이는 정적 벤치마크 설정을 재현하는 것입니다.
--extra-inputs min_tokens:128 과 --extra-inputs ignore_eos:true: 모델이 실제로 128토큰을 생성하도록 강제합니다. 이 둘이 없으면 출력 토큰 수는 목표가 아니라 권고에 그칩니다. 모델은 자연스럽게 끝났다고 판단하는 지점에서 멈추므로 목표 출력 시퀀스 길이(Output Sequence Length, OSL)에 한참 못 미치는 경우가 생기고, 처리량은 실제보다 낮게 나오면서 실행마다 값이 달라집니다. AIPerf 저장소도 이 점을 알려진 문제로 명시해 두고 있습니다. 출력 길이 제약은 서버가 ignore_eos 와 min_tokens 를 지원할 때만 보장됩니다.
--streaming: TTFT와 ITL을 재려면 선택이 아니라 필수입니다. 스트리밍을 켜지 않으면 서버가 응답 전체를 모아 한 번에 보내므로, 첫 토큰 이벤트도 디코딩 토큰 이벤트도 존재하지 않아 잴 것이 없습니다.
핵심 지표 네 가지와, 평균 대신 백분위를 봐야 하는 이유
실행이 끝나면 AIPerf는 콘솔에 지표 표를 찍고 전체 결과를 CSV와 JSON으로 남깁니다. 아래가 원문이 보여준 정적 128/128 실행의 출력입니다.
먼저 가장 자주 인용되는 네 가지입니다. 지표 레퍼런스 문서에 실린 정의와 수식을 함께 정리합니다.
TTFT(Time to First Token): 요청을 보낸 시점부터 첫 토큰을 받기까지의 시간입니다. 대화형 서비스의 체감 반응성을 좌우하는 1차 지표이고, 네트워크 지연과 큐 대기, 프롬프트 처리, 첫 토큰 생성이 모두 포함됩니다. 수식으로는 \text{TTFT} = t_{\text{first chunk}} - t_{\text{request start}} 입니다.
ITL(Inter Token Latency): 생성 도중 연속한 토큰 사이의 평균 간격으로, TTFT 오버헤드를 뺀 정상 상태의 생성 속도를 나타냅니다. TTFT가 멀쩡해도 ITL이 높으면 디코딩 단계가 버거운 것입니다. 기본 계산식은 다음과 같습니다.
분모가 \text{OSL} - 1 인 것은 첫 청크에 토큰이 하나만 들어 있다고 가정하기 때문입니다. TensorRT-LLM의 stream-interval 처럼 서버가 첫 청크에 여러 토큰을 묶어 보내면 이 가정이 깨지면서 ITL이 과소평가되고 사용자당 처리량은 부풀려집니다. 이 경우 --per-chunk-usage 를 켜면 서버가 보고하는 누적 사용량을 근거로 분모가 \text{OSL} - \text{첫 청크 토큰 수} 로 바뀝니다. 다만 이 플래그는 단독으로 동작하지 않아서 --use-server-token-count 와 chat 엔드포인트, --streaming 이 함께 필요하고, 서버도 continuous_usage_stats 를 받아 주어야 합니다. vLLM과 TensorRT-LLM은 지원하지만 엄격한 OpenAI API는 거부합니다.
요청 지연(Request Latency): 응답 전체를 받기까지의 종단 간 시간입니다. 프리필과 디코딩 비용을 한 숫자로 합칩니다.
출력 토큰 처리량(Output Token Throughput): 동시에 처리되는 모든 요청을 합산한 초당 생성 토큰 수로, 용량 산정의 1차 지표입니다. \text{OutputTokenThroughput} = \text{TotalOSL} / \text{BenchmarkDuration} 으로 계산되므로 TTFT가 분모에 포함됩니다. 같은 이름처럼 보이는 사용자당 출력 토큰 처리량(Output Token Throughput Per User)은 1 / \text{ITL} 이라 TTFT를 제외하므로, 두 값을 직접 비교하면 안 됩니다.
이 넷을 포함한 모든 지표는 p25, p50, p75, p90, p95, p99 백분위와 최솟값, 최댓값, 평균, 표준편차로 함께 보고됩니다. 백분위가 중요한 이유는 꼬리에 있습니다. 위 화면에서 TTFT의 평균은 242.03ms지만 p99는 414.92ms이고 최댓값은 433.20ms입니다. 평균만 보면 건강해 보이는 서버의 꼬리가 1.7배 느리다는 뜻이고, 이런 서버는 집계에서 멀쩡해 보이다가 프로덕션에서 무너집니다. 다만 이 실행은 요청이 10건뿐이라 p99가 사실상 최댓값이므로, 백분위가 제 몫을 하는 것은 뒤에 나오는 200건 실행 쪽입니다.
여기에 더해 DCGM(Data Center GPU Manager)이나 pynvml을 쓸 수 있는 환경이라면 GPU 전력 소모와 사용률, 메모리 점유가 같은 실행 결과 안으로 들어옵니다. AMD GPU는 amdsmi로 수집합니다. 지연 스파이크와 메모리 압박 이벤트를 맞춰 보려고 별도 프로파일링 세션을 다시 잡을 필요가 없습니다.
Effective와 Active: 같은 실행에서 처리량이 14배 차이 나는 이유
위 스크린샷을 다시 보면 표가 세 개입니다. 맨 아래가 익숙한 지표 표이고, 위의 두 표는 각각 Effective 와 Active 라는 이름을 달고 있습니다. 원문은 이 두 표를 화면에 보여만 주고 설명하지 않는데, 저장소의 기술 개요 문서가 이유를 정리해 두었습니다. 요약하면 LLM 추론에는 산술 평균이 감추는 함정이 셋 있습니다.
첫째, 레코드 단위로 평균을 내면 빠른 요청 쪽으로 편향됩니다. 10초짜리 요청 하나에 1초짜리 아흔아홉 개인 실행과, 100초짜리 요청 하나에 1초짜리 아흔아홉 개인 실행은 레코드 산술 평균이 같습니다. 앞쪽이 훨씬 건강한 서버인데도 그렇습니다.
둘째, 전체 구간 평균은 빈 시간으로 희석됩니다. 요청 하나는 계산 집약적이고 짧은 프리필과 메모리 집약적이고 긴 디코딩의 두 단계를 거칩니다. 어느 순간을 잘라 보아도 진행 중인 요청의 대부분은 디코딩에 있고 프리필 구간은 짧고 드뭅니다. 그래서 전체 구간에 걸쳐 프리필 처리량을 평균 내면 디코딩만 진행되던 시간에 희석된, 하드웨어가 실제로 낸 것보다 훨씬 작은 숫자가 나옵니다.
셋째, 조율된 누락(coordinated omission) 입니다. 부하 생성기가 서버를 포화시키면 요청들이 발송 전에 AIPerf의 크레딧 큐에 쌓입니다. 서버 쪽 타이밍은 이 대기 시간을 빼고 재므로, 실제로 그 시각에 요청을 보낸 사용자가 겪었을 지연보다 낙관적인 숫자가 나옵니다.
AIPerf의 답은 시간 가중 평균입니다. 관심 있는 값의 계단 함수를 만든 뒤 전체 실행 구간에 대해 적분합니다.
\text{avg} = \frac{\sum_i v_i \times \Delta t_i}{t_{\text{end}} - t_{\text{start}}}Effective 지표는 이 식을 실행 전체 구간에 적용한 값이고, Active 지표는 해당 단계에 요청이 하나라도 진행 중인 구간으로만 적분 범위를 좁힌 값입니다. 백분위도 마찬가지로 시간 가중이라, "p99가 920 tok/s" 는 "실행 시간의 99% 동안 디코딩 처리량이 920 tok/s 이하였다" 는 뜻이지 "레코드의 99%가 그 이하" 라는 뜻이 아닙니다. 그리고 effective_latency 는 end_ns - credit_issued_ns 로 계산되어 크레딧 큐 대기까지 요청에 부과하는, AIPerf에서 유일하게 조율된 누락을 고려한 지연 지표입니다.
차이가 얼마나 큰지는 위 스크린샷의 숫자가 보여줍니다. 같은 실행에서 Effective Prefill Throughput은 36.47 tok/s인데 Active Prefill Throughput은 528.86 tok/s입니다. 14배가 넘는 격차인데, 둘 다 맞는 값입니다. 앞엣것은 "이 워크로드를 실행하는 동안 프리필에 쓰인 평균 능력" 이고 뒤엣것은 "프리필이 실제로 진행되고 있을 때의 강도" 입니다. 문서가 제시하는 인용 기준은 명확합니다. 측정한 워크로드 조합 그대로 용량을 산정할 때는 Effective를, 단계별 최대 강도를 특성화할 때는 Active를, 포화 가능성이 있는 부하에서 사용자 체감 지연을 보고할 때는 effective_latency 를 인용합니다.
추론 토큰이 TTFT를 바꿉니다: TTFT, TTFO, 그리고 OSL의 함정
앞의 vLLM 명령에 --reasoning-parser qwen3 가 들어 있던 이유가 여기 있습니다. Qwen3나 DeepSeek-R1, gpt-oss 계열처럼 최종 응답 전에 추론 토큰(reasoning token) 을 생성하는 모델은 그 내용을 API 응답의 reasoning_content 필드로 돌려줍니다. 마이그레이션 문서가 경고하듯, GenAI-Perf는 이 필드를 아예 파싱하지 않고 무시했습니다. 그래서 GenAI-Perf의 TTFT는 추론이 아닌 첫 출력 토큰이 나올 때까지 기다린 값이 됩니다.
AIPerf는 추론 토큰을 파싱하고 지표를 둘로 쪼갭니다.
지표 AIPerf GenAI-Perf 관계 TTFT 추론 토큰을 포함한 모든 첫 토큰까지의 시간 지원하지 않음 AIPerf TTFT가 더 작게 나옴 TTFO(Time to First Output Token) 추론이 아닌 첫 출력 토큰까지의 시간 이것이 GenAI-Perf의 TTFT AIPerf TTFO = GenAI-Perf TTFT OSL 추론 토큰 + 출력 토큰 출력 토큰만 AIPerf OSL이 더 크게 나옴 Output Token Count 출력 토큰만 이것이 GenAI-Perf의 OSL AIPerf Output Token Count = GenAI-Perf OSL Reasoning Token Count 추론 토큰만 없음 AIPerf 전용이 표가 왜 중요한가 하면, 두 도구의 숫자를 나란히 놓고 "AIPerf로 바꿨더니 TTFT가 좋아졌다" 고 결론 내리는 일이 실제로 가능하기 때문입니다. 추론 모델을 재는 경우 GenAI-Perf의 TTFT와 비교해야 할 값은 AIPerf의 TTFT가 아니라 TTFO이고, GenAI-Perf의 OSL과 비교해야 할 값은 AIPerf의 OSL이 아니라 Output Token Count입니다. 추론 능력이 없는 모델에서는 TTFT와 TTFO가 같은 값이 되므로 이 구분이 필요 없습니다.
고정된 부하에서 현실의 트래픽으로: 도착 패턴 조정하기
정적 벤치마크는 기준선으로는 훌륭하지만 현실의 추론 트래픽은 그렇게 흐르지 않습니다. 원문은 두 번째 실행에서 합성 워크로드 관련 옵션 몇 개를 조정해 변동성을 집어넣습니다.
aiperf profile \
  --model Qwen/Qwen3-0.6B \
  --endpoint-type chat \
  --streaming \
  --url localhost:8000 \
  --request-rate 10 \
  --arrival-pattern poisson \
  --synthetic-input-tokens-mean 512 \
  --synthetic-input-tokens-stddev 128 \
  --output-tokens-mean 128 \
  --output-tokens-stddev 32 \
  --random-seed 42 \
  --request-count 200
--arrival-pattern poisson 과 --request-rate 10 의 조합은 평균 초당 10건으로 요청을 보내되 도착 간격을 지수 분포에서 뽑습니다. 단일 사용자가 꾸준히 두드리는 흐름이 아니라 몰림과 공백이 번갈아 오는 흐름, 즉 실제 트래픽에서 큐가 만들어지는 방식을 서버가 겪게 됩니다. 도착 패턴 문서를 보면 선택지는 넷입니다.
constant
정확히 1/\text{rate} 초 간격
변동 없는 기준선, 타이밍 디버깅
poisson (기본값)
지수 분포, 분산 = (1/\text{rate})^2
일반적인 부하 테스트, 대기행렬 이론과의 대조
gamma
감마 분포, --arrival-smoothness 로 조절
몰림 강도를 직접 정하는 스트레스 테스트
concurrency_burst
지연 없음, 동시성 세마포어로만 제한
--request-rate 없이 --concurrency 만 줄 때
--arrival-smoothness 는 감마 분포의 형상 모수 k 입니다. 1보다 작으면 몰림이 심해지고, 1이면 포아송과 같아지며, 1보다 크면 등간격에 가까워집니다. 척도 모수는 평균 속도가 유지되도록 자동으로 계산됩니다. vLLM의 자체 벤치마크 스크립트에서 넘어온다면 이 옵션에 --vllm-burstiness 라는 별칭이 있고, 같은 값을 주면 vLLM의 --burstiness 와 같은 분포가 나옵니다. 참고로 --request-rate 를 줄 때 도착 패턴의 기본값이 이미 포아송이므로, 위 명령의 --arrival-pattern poisson 은 의도를 명시하는 역할입니다.
나머지 플래그도 각자 역할이 있습니다. --synthetic-input-tokens-stddev 128 은 512토큰 평균 주변에 분산을 넣어 짧은 프롬프트와 긴 프롬프트가 섞이게 하고, --output-tokens-stddev 32 는 출력 쪽에 변동을 줍니다. 여기서 min_tokens 와 ignore_eos 가 사라진 것은 실수가 아니라 의도입니다. 정적 기준선에서는 출력을 정확히 128토큰으로 고정해 기준선을 깨끗하게 유지했지만, 이번에는 출력 분포가 변하도록 그 제약을 일부러 풀었습니다. --random-seed 42 는 포아송 타이밍과 합성 길이 추출을 재현 가능하게 만들어, 같은 명령을 다시 실행하면 같은 요청 시퀀스가 나오게 합니다.
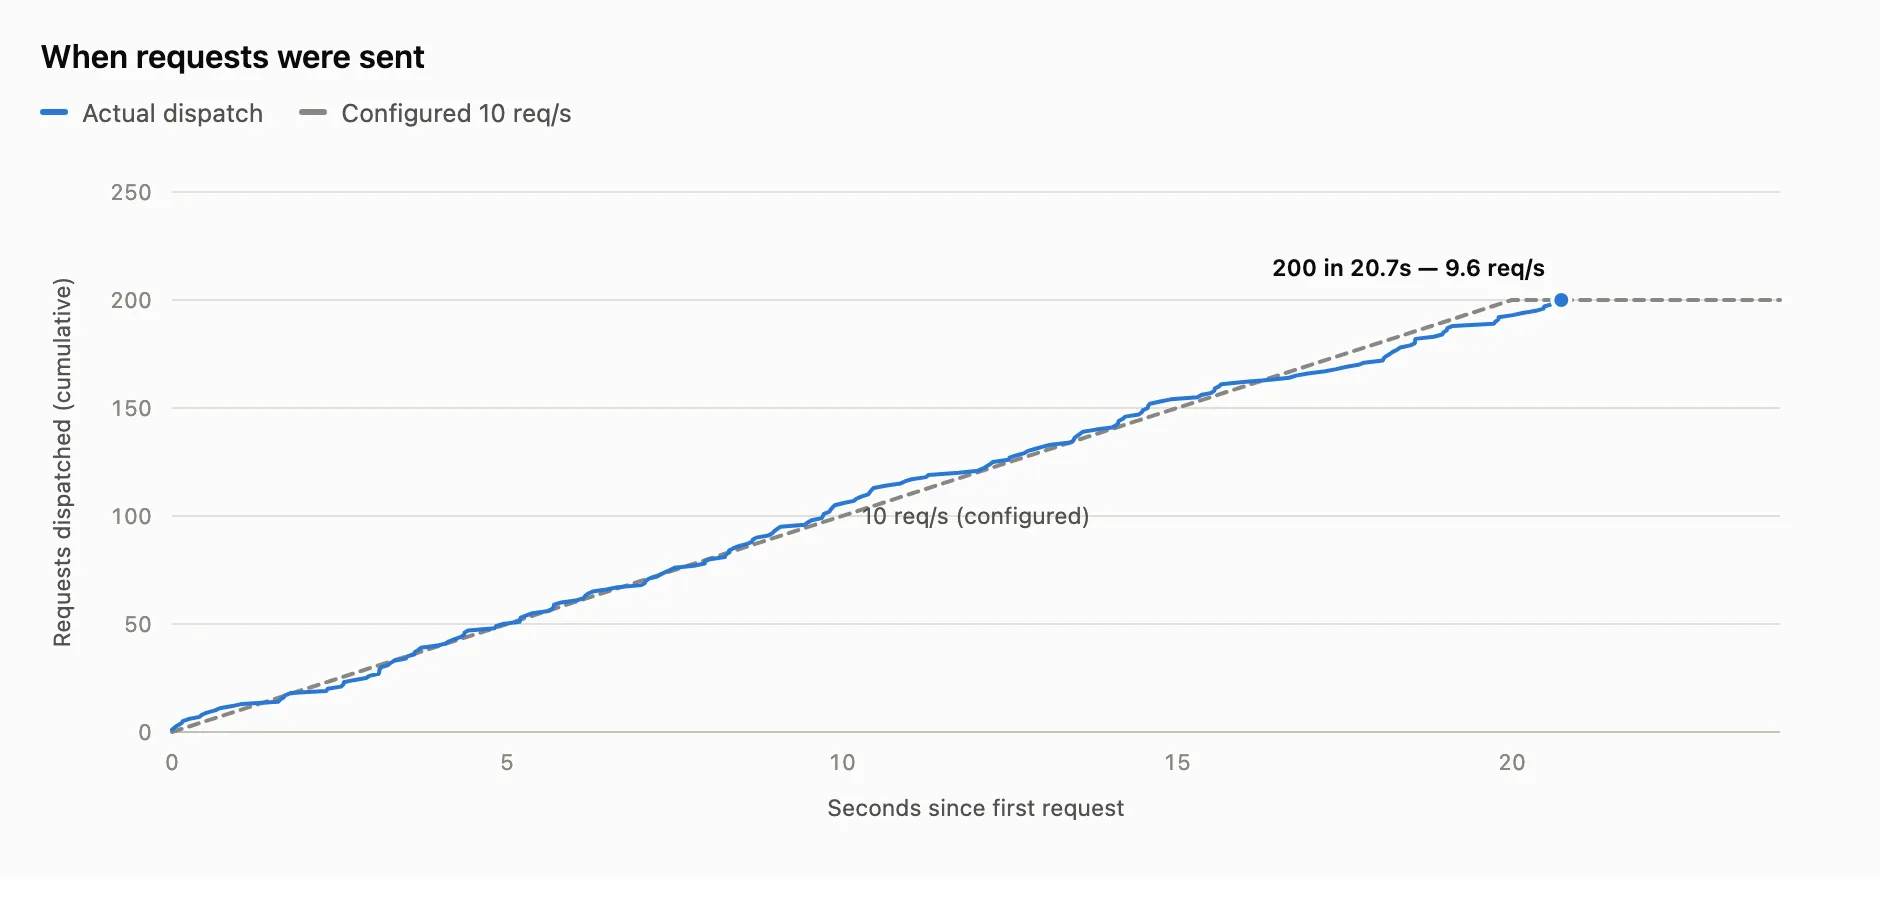
요청이 실제로 어떻게 나갔는지는 아래 그림이 보여줍니다. 회색 점선이 지터 없이 고정 10 req/s로 보냈을 때의 기울기이고, 파란 선이 포아송 모드의 실제 누적 발송량입니다. 200건을 20.7초에 보내 평균 9.6 req/s가 나왔고, 선이 점선을 중심으로 오르내리며 들쭉날쭉한 것이 도착 간격에 넣은 변동입니다.
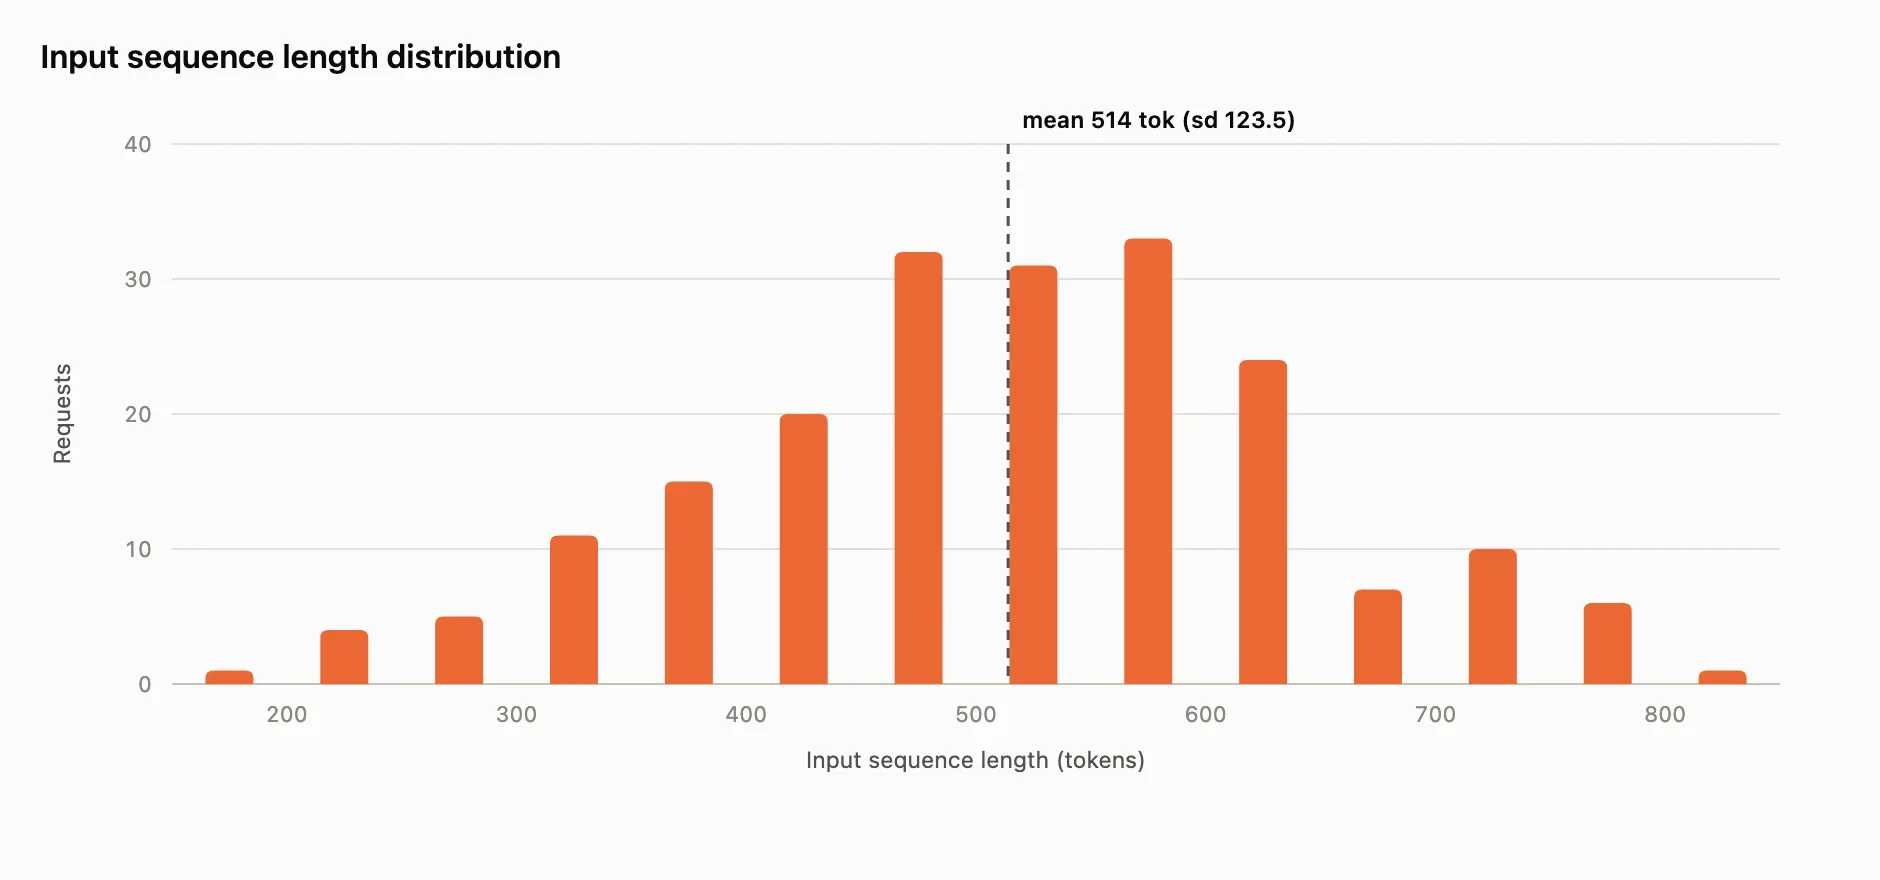
입력 길이 쪽도 요청한 대로 흩어졌습니다. 평균 512토큰, 표준편차 128을 지정한 결과 실측 평균은 514토큰(표준편차 123.5)이고, 가장 짧은 요청이 154토큰, 가장 긴 요청이 818토큰으로 대칭에 가까운 종 모양 분포가 만들어졌습니다.
두 실행을 나란히 놓기: 평균이 아니라 분포가 달라집니다
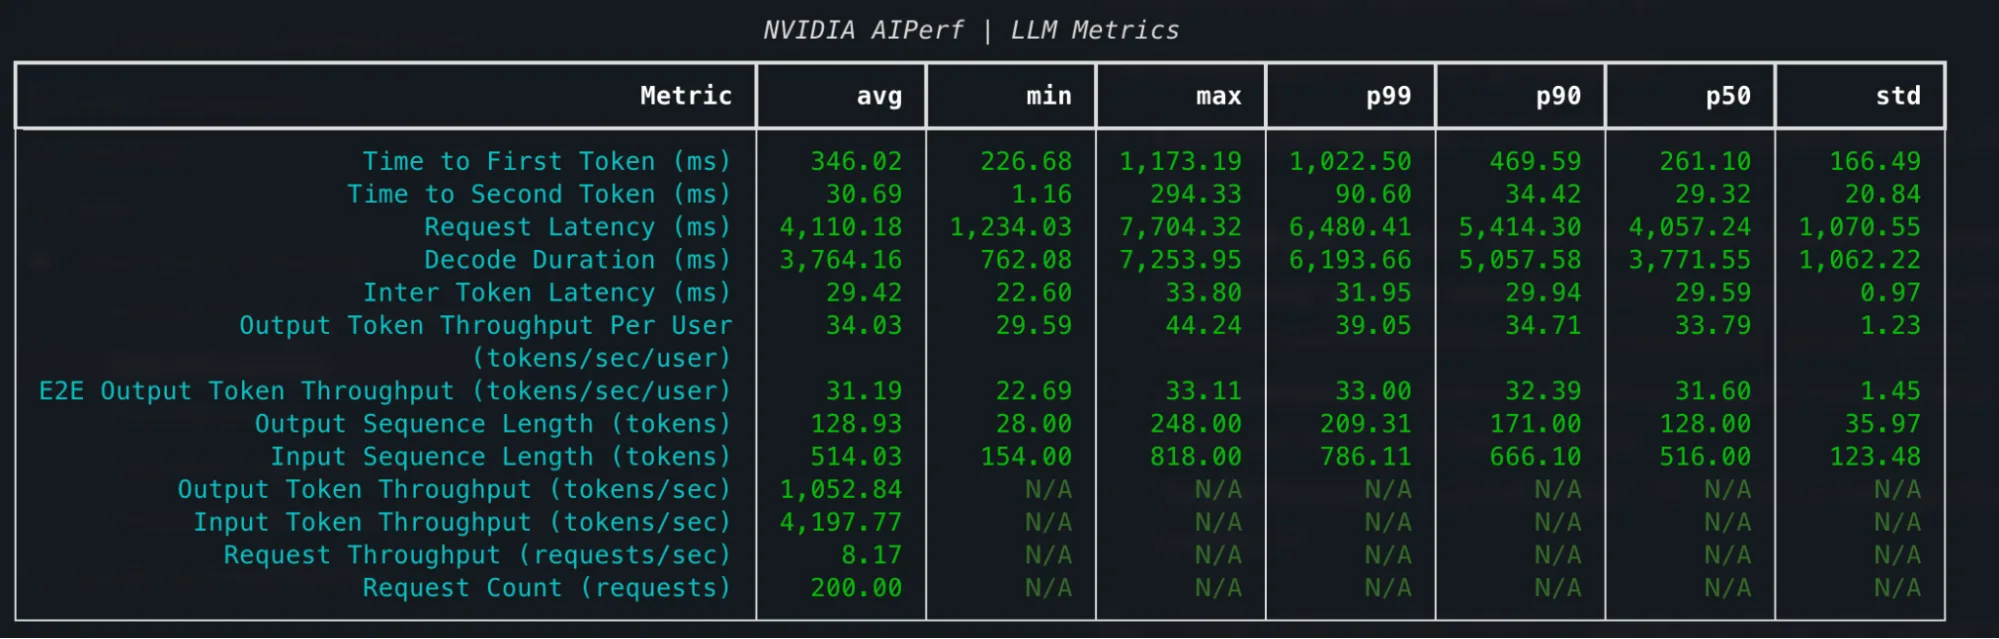
포아송 실행의 지표 요약은 아래와 같습니다.
두 실행의 숫자를 한 표에 모으면 무엇이 달라졌는지가 분명해집니다. 다만 두 실행은 워크로드 자체가 다르므로(요청 10건의 128/128 고정에 동시성 1 대 요청 200건의 512±128 입력과 128±32 출력에 초당 10건), 통제된 A/B 비교가 아니라 부하 형태가 바뀌면 분포가 어떻게 반응하는지를 보여주는 대조로 읽어야 합니다.
지표 정적 128/128, 동시성 1 포아송 10 req/s, 200건 TTFT 평균 242.03 ms 346.02 ms TTFT p50 220.57 ms 261.10 ms TTFT p99 414.92 ms 1,022.50 ms TTFT 표준편차 63.92 ms 166.49 ms 요청 지연 평균 3,508.37 ms 4,110.18 ms ITL 평균 25.92 ms 29.42 ms 입력 시퀀스 길이 평균 128.00 토큰 514.03 토큰 출력 시퀀스 길이 평균 127.00 토큰 128.93 토큰 출력 토큰 처리량 36.19 tok/s 1,052.84 tok/s 요청 처리량 0.28 req/s 8.17 req/s위 표에서 눈여겨볼 것은 두 가지입니다. 하나는 평균보다 꼬리가 훨씬 크게 움직였다는 점입니다. TTFT 평균은 1.4배 늘었는데 p99는 2.5배로 뛰었고 표준편차는 2.6배가 되었습니다. 동시에 여러 요청이 GPU를 두고 경쟁하고, 프리필 길이가 요청마다 다르며, 프리필과 디코딩이 서로 겹치면서 생기는 결과입니다. 다른 하나는 처리량과 지연이 맞바꿔졌다는 점입니다. 동시성 1은 한 번에 요청 하나만 처리하는 이상화된 상황이라 가능한 가장 낮은 TTFT를 주지만, 그 대가로 출력 토큰 처리량이 36 tok/s에 그칩니다. 부하를 걸면 처리량은 29배가 되고 꼬리 지연은 나빠집니다. 용량 산정이란 결국 이 곡선 위에서 어느 점을 고를지의 문제입니다.
원문은 두 실행의 TTFT 분포를 겹쳐 놓은 히스토그램도 함께 싣습니다. 파란 쪽이 동시성 1, 초록 쪽이 초당 10건이고 각각 200건씩입니다. 동시성 1은 하나의 막대에 요청의 66%가 몰릴 만큼 뾰족하고, 초당 10건은 100ms대 초반부터 160ms 너머까지 완만하게 퍼져 있습니다.
이 그림의 중앙값은 각각 88ms와 131ms로 표시되어 있는데, 바로 위 표의 p50(220.57ms, 261.10ms)과는 맞지 않습니다. 같은 실행에서 뽑은 그림이 아니라 별도로 실행한 한 쌍에서 그린 것이므로, 절대값을 앞의 표와 이어 붙이지 말고 분포의 모양 차이를 읽는 용도로 보는 편이 안전합니다.
GenAI-Perf에서 넘어올 때 확인할 것
AIPerf는 현재 지원하는 기능에 한해 GenAI-Perf의 대체재(drop-in replacement) 로 설계되었습니다. 이 단서는 형식적인 표현이 아닙니다. CLI 기능 비교 문서를 보면 AIPerf가 훨씬 넓은 영역이 대부분이지만, GenAI-Perf에 있고 AIPerf에 아직 없는 항목도 분명히 존재합니다.
dynamic_grpc와--grpc-method: gRPC 기반 서비스 호출 경로가 없습니다.kserve와tensorrtllm_engine: KServe 엔드포인트와 TensorRT-LLM 엔진 직접 접근이 빠졌습니다. AIPerf는 OpenAI 호환 HTTP 표면을 중심으로 재설계되었기 때문에, Triton 네이티브 경로로 재던 벤치마크는 그대로 옮겨지지 않습니다. 같은 이유로 Triton 전용이던--output-tokens-mean-deterministic도 없습니다.nvclip과generate: NVIDIA CLIP 엔드포인트와 범용 텍스트 생성 엔드포인트가 없습니다. 다만 Hugging Face TGI의/generate는huggingface_generate로 그대로 지원합니다.--backend {tensorrtllm,vllm}: 백엔드 선택 플래그 자체가 사라졌습니다.--checkpoint-dir과--enable-checkpointing: 체크포인트 관련 옵션이 없습니다.
반대로 이름이 같거나 비슷해서 헷갈리기 쉬운 항목도 있습니다. 가장 주의할 것은 --server-metrics-url 입니다. 이름과 달리 GenAI-Perf의 이 플래그는 Triton과 DCGM의 GPU 텔레메트리 엔드포인트를 가리키는 것이지 범용 Prometheus 스크레이퍼가 아니었습니다. AIPerf는 이 관심사를 둘로 쪼개서, GPU 텔레메트리는 --gpu-telemetry 가, 모델 엔드포인트의 Prometheus 지표는 --server-metrics 가 담당합니다. 따라서 --server-metrics-url http://node:9400 은 --gpu-telemetry http://node:9400 으로 옮겨야 하며, 이름이 비슷하다고 --server-metrics 에 지정하면 전혀 다른 표면을 겨누게 됩니다.
나머지 차이는 단순합니다. --max-threads 는 없어졌고, 요청을 보내는 워커 수는 --workers-max 로 더 세밀하게 조절합니다. 패스스루 인자 구분자 -- 도 필요 없어졌습니다. 입력 파일 포맷에서는 payload 가 payloads 복수형으로 바뀌면서 배열의 각 항목이 대화의 한 턴을 뜻하게 되었고, 요청과 페이로드를 연결할 수 있도록 session_id 필드가 추가되었습니다.
여기서 더 나아가기
원문은 다중 노드 쿠버네티스 배포, KV 캐시 재사용 워밍업, 트레이스 재생, 프리픽스 합성, 커스텀 데이터셋, 스윕 설정을 한 문단에 열거하고 링크만 건 채 끝나지만, 저장소의 튜토리얼 디렉토리에는 74개의 문서가, docs/ 전체로는 150개의 문서가 들어 있습니다. 측정 루프를 손에 익힌 다음 실제로 쓸모가 큰 것들만 골라 보면 다음과 같습니다.
굿풋(Goodput): 단순 처리량이 아니라 지정한 제약을 만족한 요청만 세는 초당 완료 요청 수입니다. TTFT 100ms 이하, ITL 3.40ms 이하 같은 서비스 수준 목표(Service Level Objective, SLO)를 --goodput "time_to_first_token:100 inter_token_latency:3.40" 형태로 주면 그 조건을 통과한 요청만 집계합니다. 서비스 수준 협약(Service Level Agreement, SLA)을 지키면서 낼 수 있는 처리량이 얼마인지가 용량 산정의 실제 질문이라면, 이쪽이 처리량보다 정직한 숫자입니다. 자세한 절차는 굿풋 튜토리얼에 있습니다.
파라미터 스윕과 적응형 탐색: 동시성이나 요청 속도를 바꿔 가며 여러 번 실행하는 일을 YAML 설정의 sweep: 블록으로 묶을 수 있고, 베이지안 최적화 기반의 적응형 탐색으로 격자를 나열하지 않고 목표 지표가 가장 좋아지는 지점을 찾게 할 수도 있습니다. SLA 아래의 최대 처리량이나 최대 동시성처럼 자주 나오는 질문은 max-concurrency-under-sla 같은 이름 붙은 탐색 레시피로 준비되어 있습니다. aiperf plot 은 여러 실행 결과를 받아 처리량 대 상호작용성의 파레토 곡선을 그려 줍니다.
트레이스 재생: 합성 부하 대신 실제로 기록된 트래픽을 그대로 재생합니다. Mooncake, Bailian, BurstGPT, Baseten Parquet, Amazon SageMaker 데이터 캡처, WEKA와 TraceLab의 실제 에이전틱 코딩 세션 트레이스까지 로더가 준비되어 있습니다. KV 캐시 재사용률처럼 합성 프롬프트로는 재현하기 어려운 특성을 보려면 이쪽이 유일한 길입니다.
Kubernetes 오퍼레이터: 클러스터 위에서 CRD로 벤치마크를 정의하고, Kueue로 큐잉하며, 결과를 사이드카로 수거하는 운영 경로가 문서화되어 있습니다.
텔레메트리 연동: Weights & Biases, MLflow, OpenTelemetry로 결과와 실시간 지표를 내보내는 선택적 의존성이 각각 aiperf[wandb], aiperf[mlflow], aiperf[otel] 로 제공됩니다.
AIPerf가 NVIDIA 단독 프로젝트가 아니라는 점도 짚어 둘 만합니다. 원문의 감사의 글은 AWS, CoreWeave, Baseten, Pinterest 소속 기여자들의 이름을 나열하면서 AIPerf로 표준화하려는 회사 간 협업을 언급합니다. Weights & Biases 익스포터, Baseten 트레이스 재생, 방향 비순환 그래프(Directed Acyclic Graph, DAG) 벤치마킹 방법론 같은 기능이 이 협업에서 나왔습니다. 서로 다른 회사가 같은 도구로 측정하면, 벤치마크 결과를 비교할 때 도구 차이부터 의심할 필요가 줄어듭니다.
라이선스
AIPerf는 Apache License 2.0으로 배포되고 있어, 연구 목적은 물론 상업적 용도로도 자유롭게 사용 및 수정이 가능합니다.
Benchmarking LLM Inference at Scale with AIPerf 소개 블로그
NVIDIA Technical Blog – 18 Sep 26Benchmarking LLM Inference at Scale with AIPerf | NVIDIA Technical Blog
You’re deploying a model on a system. It starts up, prompts are getting responses. Now the hard question: Is this fast? Your instincts might lead you to send curl commands, hand-roll an asyncio script…
AIPerf GitHub 저장소
github.comGitHub - ai-dynamo/aiperf: AIPerf is a comprehensive benchmarking tool that...
AIPerf is a comprehensive benchmarking tool that measures the performance of generative AI models served by your preferred inference solution.
AIPerf 공식 문서
docs.nvidia.comWelcome to AIPerf Documentation | NVIDIA AIPerf Documentation
AIPerf is a package for performance testing AI models.
더 읽어보기
-
E-P-D 분리 서빙: 비전 인코더를 떼어내 TTFT를 최대 93% 줄이는 조건과 오히려 느려지는 조건 (feat. NVIDIA Dynamo)
-
LLM Optimizer: 다양한 LLM의 추론 성능을 벤치마킹하고 최적화하는 도구 (feat. BentoML)
-
Tokenflood: LLM의 성능 및 안정성 테스트 및 LLM 서비스 거부(DoS) 시뮬레이션을 위한 프레임워크
-
NVIDIA Model Optimizer: 모델을 경량화하여 vLLM / TensorRT / SGLang 등의 추론 서버용 배포용 체크포인트를 만드는 프로젝트
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
파이토치 한국 사용자 모임은 이런 글들을 한국어로 정리해 나누고 있습니다. 회원으로 가입하시면 주요 글들을 이메일로 보내드리고, 텔레그램(Telegram)과 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.
아래쪽에 좋아요를 눌러주시면 다음 글을 정리하는 데 힘이 됩니다~
1개의 게시물 - 1명의 참여자