
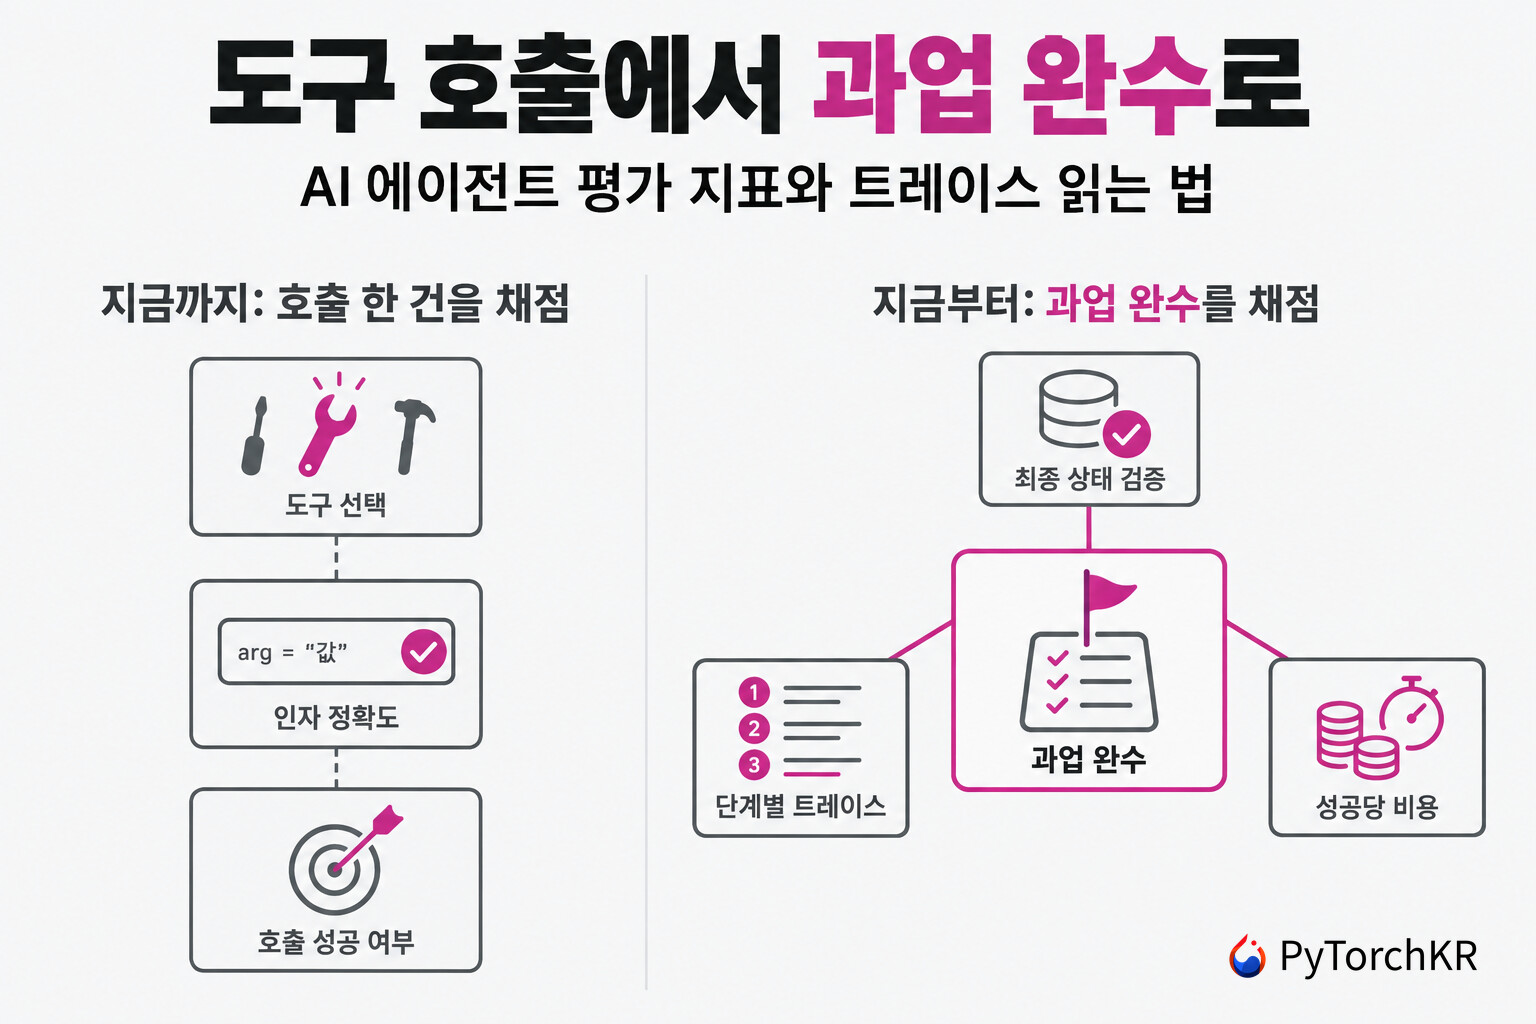
AI 에이전트 평가가 도구 호출 채점에서 과업 완수 채점으로 옮겨간 이유
NVIDIA 기술 블로그가 2026년 9월 21일 공개한 How to Evaluate AI Agents From Tool Calls to Task Completion 은 AI 에이전트의 평가 방법이 함수 호출 한 건을 채점하는 방식에서 과업 전체를 채점하는 방식으로 어떻게 옮겨왔는지를 정리한 글입니다. 결론부터 적으면, 모델이 그럴듯하게 답하는지 를 채점하는 것은 그 모델이 일을 끝냈는지 에 대해 거의 아무것도 알려주지 않으며, 지금 쓸 만한 에이전트 벤치마크는 거의 전부 도구 사용을 전제로 삼고 있다는 것입니다.
에이전트를 배포해 본 팀이라면 이 문제를 이미 겪어 봤을 것입니다. 모델을 고를 때 참고한 점수는 단일 응답의 품질을 재는 점수인데, 실제 서비스에서 에이전트가 하는 일은 살아 있는 환경을 상대로 수십 번의 도구 호출을 순서대로 이어 붙이고, 중간에 한 단계가 실패하면 그것을 복구하는 일입니다. 두 작업 사이에는 측정 대상 자체가 다릅니다. 그래서 정적 벤치마크에서 잘 나오던 모델이 배포 후에 여덟 번째 단계에서 무너지는 일이 반복되고, 그 원인을 점수표만 보고는 짚어낼 수 없습니다.
이 글은 그 간극을 좁히기 위해 평가 체계가 어떤 순서로 바뀌어 왔는지, 실행 결과를 담은 트레이스(Trace) 를 어떤 층위로 나눠 읽어야 하는지, 그리고 지표 여섯 개가 각각 무엇을 잡아내는지를 설명합니다. 저자는 Sophia Abbassi, Chris Alexiuk, Davide Onofrio, Gomathy Venkata Krishnan 네 명이고, 후반부에서는 같은 렌즈로 NVIDIA 자사 모델인 Nemotron 3.5 Lightning의 공개 점수를 읽는 방법까지 이어집니다. 아래에서는 원문의 순서를 따라가되, 원문이 이름만 스치고 지나간 벤치마크들의 정체와 한국어 커뮤니티에 이미 정리된 관련 자료를 함께 붙여 두었습니다.
정적 LLM 벤치마크의 한계와 BFCL이 채운 자리
초기 평가 하네스(Harness)는 정적인 과제를 전제로 설계되었습니다. 모델과 평가 프로토콜을 분리한 최초의 모델 비의존적(model-agnostic) 오픈소스 하네스가 등장하면서 같은 과제를 여러 모델에 똑같이 적용할 수 있게 되었고, 그 덕분에 점수를 서로 비교하는 문화가 자리 잡았습니다. 원문은 그 하네스의 이름을 밝히지 않았지만, 이 설명에 해당하는 세대의 도구로는 EleutherAI의 lm-evaluation-harness나 스탠퍼드 CRFM(Center for Research on Foundation Models)의 HELM(Holistic Evaluation of Language Models)이 대표적입니다.
에이전트는 이 전제를 깼습니다. 여러 단계에 걸친 과업을 수행하는 동안 에이전트는 도구를 호출하고, 오류를 처리하고, 그 결과를 관찰한 뒤 다음 행동을 정합니다. 출력 문자열 하나로는 이 과정을 채점할 수가 없습니다. 그 공백을 처음 메운 것이 UC 버클리 Gorilla 팀의 Berkeley Function-Calling Leaderboard(BFCL)였습니다. BFCL은 단일 턴과 다중 턴 시나리오 모두에서 모델이 어떤 함수를 골랐는지 와 인자를 정확히 채웠는지 를 평가합니다.
이 전환이 왜 필요했는지는 실패 양상을 나열해 보면 분명해집니다. 정적 벤치마크에서 모델이 틀리는 방식은 대체로 한 가지, 즉 답이 사실과 다른 것입니다. 에이전트가 틀리는 방식은 여러 가지입니다. 필요한 도구를 아예 부르지 않기도 하고, 존재하지 않는 도구 이름을 지어내기도 하고, 도구는 맞게 고르고도 인자를 잘못 채우기도 하고, 앞 단계에서 받은 오류를 무시한 채 다음 단계로 넘어가기도 합니다. 이 넷은 점수 하나로 합쳐 놓으면 구분되지 않는데, 정작 고치는 방법은 전부 다릅니다.
그러나 BFCL이 채점하는 대상은 여전히 호출 한 건 입니다. 원문이 드는 예가 이 한계를 잘 보여줍니다. issue_refund 호출 자체는 문법적으로 완벽하게 만들어졌더라도, 그 앞에 있어야 할 확인 절차나 뒤따라야 할 갱신 작업을 건너뛰었다면 업무는 실패한 것입니다. 호출 정확도는 필요조건이지만 충분조건이 아닙니다.
도구 호출 벤치마크 더 알아보기
Berkeley Function-Calling Leaderboard (BFCL) - UC Berkeley Gorilla 프로젝트의 함수 호출 리더보드
gorilla.cs.berkeley.eduBerkeley Function Calling Leaderboard (BFCL) V4
Explore The Berkeley Function Calling Leaderboard (also called The Berkeley Tool Calling Leaderboard) to see the LLM's ability to call functions (aka tools) accurately.
Gorilla GitHub 저장소 - BFCL 평가 코드와 데이터셋
github.comGitHub - ShishirPatil/gorilla: Gorilla: Training and Evaluating LLMs for Function...
Gorilla: Training and Evaluating LLMs for Function Calls (Tool Calls)
τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains - 도구, 에이전트, 사용자 3자 상호작용을 다중 턴으로 평가한 논문
arXiv.org$τ$-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains
Existing benchmarks do not test language agents on their interaction with human users or ability to follow domain-specific rules, both of which are vital for deploying them in real world applications. We propose $τ$-bench, a benchmark emulating...
lm-evaluation-harness - 모델과 평가 프로토콜을 분리한 오픈소스 하네스
github.comGitHub - EleutherAI/lm-evaluation-harness: A framework for few-shot evaluation of language...
A framework for few-shot evaluation of language models.
단계별 채점과 E2E 채점: 하나의 트레이스를 읽는 두 가지 방식
호출이 아니라 업무를 채점하려면 완전한 실행 환경(Full Execution Environment) 이 필요합니다. 각 도구 호출을 실제로 실행하고, 단계 사이의 상태를 추적하며, 모든 것이 끝난 뒤 환경을 다시 읽어 일이 실제로 끝났는지 판정하는 환경입니다. 이 환경 위에 채점 계층 두 개가 올라갑니다.
-
단계별 채점(Step-level, Process Scoring): 그 시점의 상태를 고려했을 때 이 호출이 유효했는가, 관련이 있었는가, 유용했는가를 묻습니다.
-
종단 간 채점(End-to-End, E2E, Outcome Scoring): 경로를 무시하고 최종 상태만 확인합니다. 환불이 실제로 기록되었는가, 티켓이 올바른 담당자에게 배정되었는가를 봅니다.
두 채점은 서로를 대체하지 않습니다. 단계별 채점은 사슬이 어디서 끊어졌는지 알려주므로 디버깅을 하거나 미세조정(Fine-tuning)의 목표 지점을 정할 때 필요합니다. 반면 E2E 채점은 첫 단계에서의 실패와 아홉 번째 단계에서의 실패를 똑같은 과업 실패 로 합쳐 버립니다. 그 대신 E2E는 사용자가 실제로 경험하는 것과 같습니다. 그래서 프로덕션 평가 대부분은 릴리즈 여부를 E2E로 결정하고, 그 아래에 단계별 트레이스를 디버깅용으로 계속 남겨 둡니다.
두 점수는 서로 다른 두 대상을 재는 것이 아니라, 하나의 대상인 트레이스 를 두 가지 방식으로 읽은 결과입니다. 트레이스란 한 번의 시도를 순서대로 기록한 로그로, 사용자 메시지와 각 단계, 그리고 시도가 멈춘 시점의 환경 상태로 이뤄집니다. 단계별 채점은 이 로그의 행들을 채점하고, E2E 채점은 마지막 상태를 채점합니다.
구분 단계별 채점 (Process Scoring) 종단 간 채점 (E2E, Outcome Scoring) 채점 대상 트레이스의 각 행(단계) 시도가 끝난 시점의 환경 상태 묻는 질문 이 호출이 그 시점에 유효하고 유용했는가 목표 상태에 도달했는가 알려주는 것 사슬이 끊어진 위치 사용자가 체감하는 성공 여부 주 용도 디버깅, 미세조정 목표 설정 릴리즈 게이트 한계 경로가 좋아도 결과가 틀릴 수 있음 1단계 실패와 9단계 실패를 구분하지 못함에이전트 하네스를 실행 트레이스 기준으로 진화시키는 접근은 커뮤니티에도 여러 차례 소개된 적이 있습니다. 에이전트의 실패를 추적하고 평가해 스스로 고치는 PandaProbe나, 정적 벤치마크 환경을 에이전트의 약점에 맞춰 재구성하는 EnvHarness가 같은 문제의식에서 출발한 프로젝트들입니다.
에이전트 하네스와 실행 환경 더 알아보기
OpenHands - 원문 트레이스가 사용한 오픈소스 에이전트 하네스
OpenHandsOpenHands | The Open Platform for Cloud Coding Agents
Meet OpenHands, the open-source, model-agnostic platform for cloud coding agents. Automate real engineering work securely and transparently. Build faster with full control.
NVIDIA NeMo Gym - 환경 기반 평가와 롤아웃을 실행하는 오픈소스 라이브러리
github.comGitHub - NVIDIA-NeMo/Gym: Evaluate and improve models and agents using...
Evaluate and improve models and agents using environments
Harness Engineering: 코딩 에이전트의 환경을 설계하는 12개 논제 - 하네스 설계 논의를 한국어로 정리한 글
Harness Engineering: 코딩 에이전트의 환경을 설계하는 12개 논제와 플레이북 모음 읽을거리&정보공유[Harness Engineering: 코딩 에이전트의 환경을 설계하는 12개 논제와 플레이북 모음] Harness Engineering 소개 같은 모델과 같은 코딩 에이전트를 쓰는데도 조직마다 결과물의 수준이 갈립니다. 모델을 바꾸거나 프롬프트를 다듬는 것 말고 어떤 레버가 남아 있는지는 대개 각 팀의 경험담으로만 돌아다닙니다. 조직이 실제로 요구하는 신뢰성과 보안, 호환성, 유지보수성, 성능, 운영 가능성 같은 비기능 요구사항은 어느 모델 가중치에도 들어 있지 않기 때문에, 그 요구사항을 에이전트가 꺼내 쓸 수 있는 형태로 옮기는 일은 결국 조직이 직접 해야 합니다. Harness Engineering은 그 일을 하나의 실천으로 정리한 문서 저장소입니다. Ryan Lopopolo가 자신의 글과 발표, 인터뷰, 공개 포스트를 근거로 엮은 선집이자 현장 가이드이며, 동시에 코딩 에이전트에게 그대로 물릴 수 있는 컨텍스트 번들입니다. 저자가 정의하는 하네스 엔지니어링은 "에이전트…

HarnessX - 에이전트 하네스를 실행 트레이스로 진화시키는 연구
HarnessX: 에이전트 하네스를 실행 트레이스로 진화시키는 연구 (feat. Xiaomi) 읽을거리&정보공유[HarnessX: 에이전트 하네스를 실행 트레이스로 진화시키는 연구 (feat. Xiaomi)] HarnessX 소개 같은 요리사라도 손에 쥔 도구와 주방 동선이 바뀌면 전혀 다른 결과물이 나옵니다. 무딘 칼과 어수선한 작업대 앞에서는 실력자도 제 기량을 내기 어렵고, 잘 정돈된 주방에서는 평범한 요리사도 한 단계 위의 요리를 만들어냅니다. 최근의 AI 에이전트(agent)도 마찬가지입니다. 같은 모델이라도 그 주변을 감싸는 실행 환경, 즉 프롬프트(prompt), 도구, 메모리, 제어 흐름이 어떻게 짜여 있느냐에 따라 성능이 크게 달라집니다. 이 논문은 에이전트를 감싸는 이 실행 환경을 하네스(harness) 라고 부르며, 하네스를 사람이 손으로 매번 새로 짜는 정적인 코드가 아니라 조합하고, 적응시키고, 진화시킬 수 있는 1급 객체(first-class object) 로 다루는 방법을 제안합니다. 핵심 질문은 분명합니다. 모델을 더 크게 키우지 않고도, 모델 주변의 실행 …
벤치마크 실행의 5단 계층: Benchmark에서 Step까지
도구 호출 벤치마크는 세 가지를 순서대로 채점합니다. 첫째로 도구를 쓰기로 결정(deciding)했는지, 둘째로 올바른 도구를 선택(selecting)했는지, 셋째로 그 도구의 인자를 정확히 채웠는지(populating) 입니다. 여기서 놓치기 쉬운 대칭이 하나 있습니다. 직접 답하면 될 상황에서 굳이 도구를 호출하는 모델은, 필요한 도구를 건너뛴 모델과 똑같이 실패한 것입니다. 비용과 지연 시간(latency)은 이 세 층 위에 얹히며, 호출이 얼마나 장황한지와 실행이 얼마나 오래 걸리는지가 그 값을 정합니다.
모든 실행 결과는 고정된 계층을 따라 위로 집계됩니다. Benchmark → Trial → Task → Turn → Step 의 다섯 단계입니다.
-
시행(Trial): 고정된 설정 아래에서 전체 과업 집합을 한 번 독립적으로 통과한 것을 말합니다. 같은 벤치마크를 3회에서 5회 반복 실행할 때 각각의 실행이 하나의 시행입니다.
-
과업(Task): 독립적으로 채점 가능한 문제 하나입니다. 과업 ID로 식별되며, 뒤에서 볼
pytest-dev__pytest-5262같은 문자열이 그 ID입니다. -
턴(Turn): 대화가 오가는 경계 하나입니다. 메시지가 들어오고 에이전트의 답이 나갈 때까지, 그 사이에 벌어진 모든 일이 그 턴에 속합니다.
-
단계(Step): 턴 안에서 일어나는 원자적 행동 하나입니다. 도구나 명령어 호출이 대표적이고, 계획을 세우거나 최종 메시지를 내보내는 것처럼 도구를 쓰지 않는 행동도 단계에 포함됩니다.
아래 그림이 턴과 단계의 차이를 보여줍니다. 턴 1은 사용자 메시지 뒤에 네 개의 단계를 거쳐 답을 내놓았고, 턴 2는 단계 하나만으로 끝났습니다.
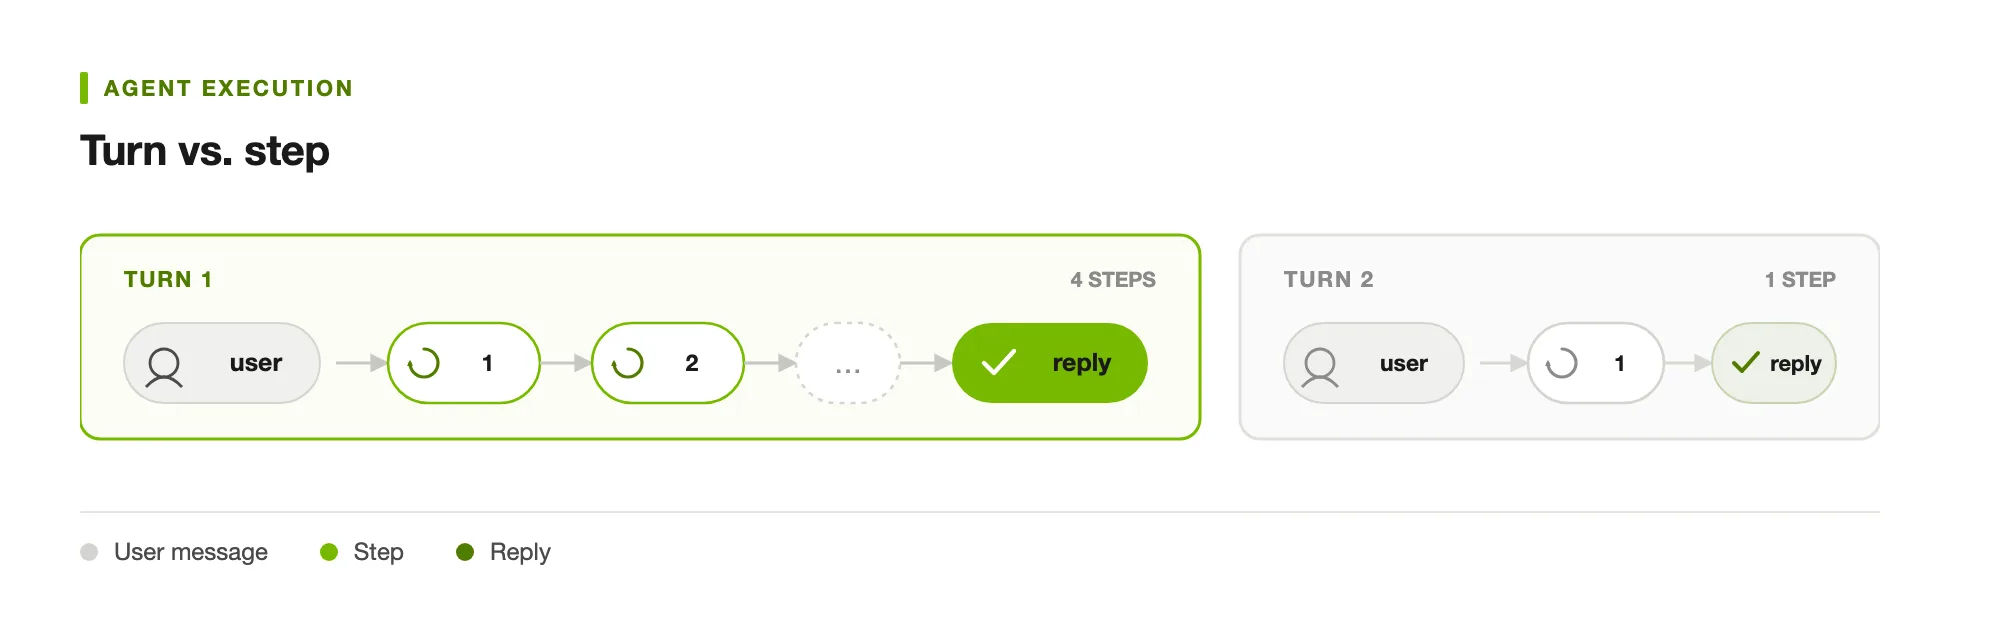
단계는 대개 도구 호출이고, 그 위의 모든 점수는 이 단계들로부터 위로 집계됩니다. 순서를 거스르지 않는 것이 중요합니다. 단계 수를 평균 내어 그것을 벤치마크 점수라고 부르는 집계는 계층을 건너뛴 것입니다.
이 계층이 실무에서 쓸모 있는 이유는 서로 다른 팀이 같은 단어로 다른 층을 가리키는 일을 막아 주기 때문입니다. 한 번 호출에 실패했다 는 보고가 단계를 말하는지 턴을 말하는지에 따라 원인 분석의 출발점이 달라지고, 성공률 86% 가 한 번의 시행에서 나온 값인지 다섯 번의 시행을 평균한 값인지에 따라 그 숫자를 믿을 수 있는 정도가 달라집니다. 벤치마크 결과를 주고받을 때 어느 층의 수치인지를 함께 적어 두는 것만으로도 오해가 크게 줄어듭니다.
정확도, 장황함, 비용: 에이전트 평가 지표 6개
추적할 가치가 있는 지표들은 결국 정확도(Accuracy), 장황함(Verbosity), 비용(Cost) 세 축으로 모입니다. 원문의 Table 1을 한국어로 옮기면 다음과 같습니다.
지표 계산식 축 존재 이유 과업 성공률 (Task success rate)successful_tasks / tasks
정확도
릴리즈 게이트. 환경이 목표 상태에 도달했는가
일관성 (Consistency)
3~5회 시행에 걸친 성공률의 범위
정확도
90%와 74%는 평균 84%가 아니다. 점 추정이 아니라 82~88% 처럼 범위로 보고
도구 호출 정밀도 (Tool-call precision)
correct_calls / calls_issued
정확도
존재하지 않는 도구 이름과 불필요한 추가 호출이 여기서 드러남
인자 정확도 (Argument accuracy)
correct_args / calls_with_right_tool
정확도
잘못된 API 와 맞는 API를 잘못 채운 것 을 분리
성공당 단계 수 (Steps per success)
steps / successful_tasks
장황함
과업이 실제로 끝났을 때 궤적이 얼마나 길었는가
성공당 비용 (Cost per success)
spend / successful_tasks
비용
경제적 단위. 토큰과 GPU 시간은 성공한 과업당으로 환산해야 의미가 있음
위 표에서 눈여겨볼 것은 지표들이 짝으로 묶여 있다 는 점입니다. 일관성 없이 성공률만 보면 확률적으로 움직이는 시스템을 점 추정 하나로 요약하는 셈이 됩니다. 90%가 나왔다가 74%가 나오는 모델은 84%에 안정적으로 머무는 모델보다 나쁜 선택이지만, 평균만 보면 두 모델이 같아 보입니다. 마찬가지로 도구 호출 정밀도만 보고 인자 정확도를 빼면, 도구는 제대로 골랐는데 인자를 잘못 채우는 슬롯 채우기(Slot-filling) 실패가 통째로 가려집니다.
단계 수는 같은 과업에서도 모델에 따라 가장 크게 벌어지는 축인 경우가 많습니다. 어떤 모델은 네 단계로 끝내고 어떤 모델은 열다섯 단계를 씁니다. 다만 원문은 Terminal-Bench 2.0 같은 스위트(Suite)에서는 턴당 단계 수도 함께 달라지므로 어느 축이 가장 크게 움직이는지는 벤치마크마다 다르다고 단서를 답니다. 참고로 Terminal-Bench는 현재 4.0까지 올라와 있고, Artificial Analysis의 지능 지수 구성에도 포함되어 있습니다.
여기에 한 가지 함정이 더 있습니다. 병렬 도구 호출(Parallel Tool Calling) 은 단계 수와 지연 시간을 줄여 주지만 호출 수는 줄이지 않습니다. 한 단계짜리 턴에서 도구 네 개를 동시에 호출했다면 호출 건수는 여전히 네 건입니다. 단계 수가 줄었다고 비용까지 줄었다고 읽으면 성공당 비용을 잘못 계산하게 됩니다.
모델과 하네스의 조합이 점수를 어떻게 바꾸는지는 HarnessTax 연구와 Artificial Analysis의 코딩 에이전트 벤치마크 정리에서 더 자세히 다룬 적이 있습니다. 같은 모델이라도 어떤 하네스에 얹느냐에 따라 성공률과 비용이 크게 달라진다는 것이 두 자료의 공통된 관찰입니다.
두 벤치마크의 점수를 비교 불가능하게 만드는 세 축
도구 호출을 테스트한다고 똑같이 주장하는 두 벤치마크가 서로 비교할 수 없는 숫자를 내놓는 일은 흔합니다. 원문은 그 격차의 대부분을 세 가지 축으로 설명합니다.
-
과업 복잡도(Task Complexity): 도구 하나를 쓰는 단일 턴인가, 아니면 계획 수립과 오류 복구, 상태 관리가 필요한 다중 턴인가에 따라 측정하는 능력이 달라집니다. 호출 한 건짜리 벤치마크는 열다섯 단계 중 여덟 번째에서 모델이 무너지는지 여부를 알려주지 못합니다.
-
상태성(Statefulness): 행동할 때마다 환경이 갱신되는가를 묻습니다. 상태를 유지하는 벤치마크에서는 정적인 벤치마크에서 확인되지 않는 드리프트(Drift), 컨텍스트 손실, 상태 오염이 드러납니다.
-
방법론(Methodology): 실행 가능한 검증(Executable Verification)이 가장 신뢰할 만합니다. 데이터베이스가 실제로 갱신되었는지, 테스트가 통과했는지를 코드로 확인하는 방식입니다. 참조 기반 평가(Reference-based Evaluation)는 누군가가 계속 관리해야 하는 정답 주석 집합을 필요로 합니다. LLM-as-a-Judge는 실행 가능한 검사를 만들 수 없는 자리를 메워 주지만, 표본에 대해 사람의 평가와 대조해 검증하기 전까지는 그 점수를 잠정적인 값으로 취급해야 합니다.
세 번째 축인 방법론은 점수를 읽을 때 가장 먼저 확인해야 하는 항목입니다. 같은 과업이라도 무엇을 정답으로 삼느냐에 따라 점수의 성격이 완전히 달라지기 때문입니다.
방법론 정답의 출처 강점 대가 실행 가능한 검증 (Executable Verification) 코드 실행 결과, 데이터베이스 상태 사람의 해석이 끼어들지 않음. 재현이 쉬움 검증 가능한 환경을 만들어 두어야 하고, 정답이 실행으로 표현되는 과업에만 적용 가능 참조 기반 평가 (Reference-based Evaluation) 사람이 주석한 정답 집합 실행 환경 없이도 채점 가능 정답 집합을 계속 관리해야 하고, 정답이 하나가 아닌 과업에서는 정상 동작을 오답으로 처리 LLM-as-a-Judge 심판 모델의 판정 실행 가능한 검사를 만들 수 없는 자리를 메움 표본에 대해 사람 평가와 대조하기 전까지 점수는 잠정적. 심판 모델 자체의 편향이 그대로 실림원문이 LLM-as-a-Judge를 배제하지 않고 검증되기 전까지 잠정적 이라는 단서와 함께 남겨 둔 점은 눈여겨볼 만합니다. 최종 메시지의 어투나 설명의 적절성처럼 실행으로 확인할 수 없는 대상이 실제로 존재하기 때문입니다. 뒤에서 볼 GDPval-AA v2가 심판 패널의 판정을 인간 전문가 기준선에 고정하는 방식을 쓰는 것도 같은 맥락입니다.
오염(Contamination) 문제도 학습 데이터 유출에만 머물지 않습니다. 원문은 평가 도중에 웹을 검색하는 에이전트가 정답 키를 그대로 찾아오는 경우, 그리고 Hugging Face에 올라간 데이터셋이 빠르게 다시 수집되어 사전학습 코퍼스로 들어가는 경우를 실시간 변종으로 듭니다. 외부에서 수집해 갈 수 없는 사내 도메인 평가가 이 문제를 구조적으로 해결하는 유일한 방법이라는 것이 원문의 처방입니다.
평가 방법론과 오염 문제 더 알아보기
The LLM Evaluation Guidebook - Hugging Face가 공개한 LLM 평가 종합 안내서의 한국어 정리
The LLM Evaluation Guidebook: Hugging Face가 공개한 LLM 평가를 위한 종합적이고 실질적인 안내서 읽을거리&정보공유[The LLM Evaluation Guidebook: Hugging Face가 공개한 LLM 평가를 위한 종합적이고 실질적인 안내서] The LLM Evaluation Guidebook / LLM 평가 가이드북 저자 / Authors: Clémentine Fourrier, Thibaud Frere, Guilherme Penedo, Thomas Wolf 발행일 / Published: 2025년 12월 3일 PDF 파일 다운로드 / Download PDF 서론: LLM 평가의 본질과 목적 대규모 언어 모델(LLM)의 세계를 항해하다 보면, 모델을 직접 학습하든, 미세 조정(Fine-tuning)하든, 혹은 단순히 애플리케이션에 적용할 모델을 선택하든 필연적으로 "어떤 모델이 좋은 모델인가?"라는 질문에 봉착하게 됩니다. 이 질문에 대한 답은 여러분이 '모델 빌더(Model Builder)'인가 혹은 '모델 사용자(Model User)'인가에 따라 근본적으로 달라…
OSWorld 2.0 - 장시간의 실제 업무로 컴퓨터 사용 에이전트를 평가하는 벤치마크
장시간의 실제 업무를 통해 컴퓨터 사용 에이전트(CUA)를 평가하는 OSWorld 벤치마크 2.0 공개 읽을거리&정보공유[장시간의 실제 업무를 통해 컴퓨터 사용 에이전트를 평가하는 OSWorld 벤치마크 2.0 공개] OSWorld 2.0 소개 새 직장에 출근한 첫날을 떠올려 봅시다. "지난 출장비를 정산해 주세요"라는 한 줄짜리 요청을 받았지만, 실제로 그 앞에 놓인 일은 한 줄이 아닙니다. 낯선 사내 규정 PDF를 먼저 읽고, 메일함을 뒤져 항공권과 호텔 영수증을 찾고, 은행 명세서와 금액을 대조하고, 처음 보는 사내 포털에 양식을 채워 넣어야 합니다. 작업 도중에 "예산을 늘렸으니 다시 확인하라"는 메일이 새로 도착하면 계획을 통째로 수정해야 하고, 영수증의 탑승객 이름이 어긋나 있으면 임의로 처리하지 말고 담당자에게 물어봐야 합니다. 이러한 장시간의 실제 업무를 컴퓨터 사용 에이전트(computer-use agent)가 얼마나 끝까지 해내는지 측정하는 것이 바로 OSWorld 2.0 벤치마크입니다. 홍콩대학교(HKU)를 중심으로 한 XLANG Lab 과 협력 기관들…
Auto-BenchMax - 벤치마크와 같은 분포로 데이터를 합성했을 때 점수가 어떻게 움직이는지 보여주는 사례
Auto-BenchMax: 벤치마크와 같은 분포로 데이터를 합성해 MCP-Atlas 점수를 2배로 올린 파이프라인 읽을거리&정보공유[Auto-BenchMax: 벤치마크와 같은 분포로 데이터를 합성해 MCP-Atlas 점수를 2배로 올린 파이프라인] Auto-BenchMax 소개 도구를 호출하는 에이전트를 학습시킬 때 가장 먼저 막히는 것은 데이터입니다. 벤치마크가 제공하는 과제는 보통 수십 개 수준이고, 이 정도로는 지도 미세조정(SFT, Supervised Fine-Tuning)을 돌릴 분량이 나오지 않습니다. 그래서 비슷한 과제를 합성해 수를 불리는데, 도구 호출 과제는 일반적인 질의응답 데이터와 사정이 다릅니다. 과제에 등장하는 주문 번호나 저장소 이름 같은 대상이 환경 안에 실제로 존재하고 도구로 닿을 수 있어야 하고, 그 과제를 벤치마크가 채점할 수 있어야 합니다. 존재하지 않는 대상을 끼워 넣으면 과제 자체가 풀리지 않고, 남는 것은 쓸모없는 궤적뿐입니다. 이번에 소개할 Auto-BenchMax는 그 합성 과정을 하나의 방법론으로 정리해 공개한 프로젝트입니다. 데이터 구축 파이프라인과 학습 코드…
Terminal-Bench 공식 사이트 - 에이전트의 터미널 작업 능력을 평가하는 벤치마크
TERMINAL-BENCHTERMINAL-BENCH
A benchmark to measure and evolve with the frontier of agent work
SWE-bench Verified 트레이스 읽기 예시: pytest 이슈 한 건
원문의 Table 2는 실제 벤치마크 실행에서 추출한 공개 트레이스입니다. 인위적으로 만든 가상의 티켓이 아니라 스위트가 도구와 사용자, 완료 기준을 모두 제공하는 환경에서 나온 기록이라는 점이 중요합니다. 실행 조건은 다음과 같습니다.
- 스위트: SWE-bench Verified. 실제 GitHub 이슈를 대상으로 하고, 통과 여부를 테스트 실행으로 검증합니다. 참고로 Verified는 OpenAI가 SWE-bench 원본에서 사람이 검수해 추린 500개 문제 부분집합이고, 원문이 링크로 단 arXiv 문서는 그 모태가 되는 SWE-bench 논문입니다.
- 과업 ID:
pytest-dev__pytest-5262(시행 .2, 턴 0~4) - 문제: pytest의
_pytest.capture.EncodedFile이 내부 버퍼의 모드를 그대로 물려받아.mode를rb+(바이너리)로 보고하는데, 정작write()는str만 받습니다. 그래서.mode를 확인한 뒤bytes를 쓰는 외부 코드(원문은 youtube-dl을 예로 듭니다)가 예외를 내며 중단됩니다. - 하네스: OpenHands 에이전트 하네스. 노출된 도구는
terminal,file_editor,task_tracker,finish네 개이고, 병렬 도구 호출은 꺼 둔 상태(턴당 호출 1건)입니다. 저장소 상태는 턴을 넘어 유지되며, 목(Mock)이 아니라 실제 파일시스템과 git 위에서 실행됩니다.
terminal(find /testbed -name "capture.py")
/testbed/src/_pytest/capture.py 반환
유효 (valid)
무엇이든 수정하기 전에 이슈가 지목한 파일부터 찾음
2
1
file_editor(view, capture.py)
400줄이 넘는 파일 전체를 출력
불필요 (redundant)
파일이 크다. 클래스를 먼저 grep 했다면 탐색 범위를 더 좁힐 수 있었음
3
2
terminal(grep -n "EncodedFile" capture.py)
422행 return EncodedFile(...), 425행 class EncodedFile(object): 반환
복구 (recovered)
2단계의 비효율을 바로잡아 관련 행으로 직행
4
3~4
file_editor(view, view_range=[420,450]/[450,470])
EncodedFile.__init__ 와 __getattr__ 를 보여주며, .mode 가 바이너리 모드 버퍼에서 그대로 위임되는 것을 드러냄
유효 (valid)
5단계 이후가 고칠 근본 원인(필터링되지 않은 __getattr__ 위임)을 정확히 짚음
이 트레이스의 채점 결과는 다음 다섯 줄로 요약됩니다.
- E2E 검사 (DB 상태 / 테스트 / 티켓): 통과(PASSED)
- E2E 점수 (0 또는 1): 1
- 단계별 점수 (통과 단계 / 전체 단계): 3/4
- 도구 호출 정밀도: 3/4
- 인자 정확도: 4/4
읽는 순서는 이렇습니다. E2E 검사는 고치려던 버그의 관련 테스트가 통과했다는 뜻이고, 따라서 E2E 점수는 1(is_resolved: true)입니다. 다음으로 단계별 점수는 모델이 밟은 단계 중 몇 개가 실제로 필요했는지를 알려줍니다. 위 표에서 2단계가 불필요한 전체 파일 덤프였으므로 3/4입니다. 그 한 번의 불필요한 호출이 도구 호출 정밀도에도 그대로 반영되어 역시 3/4가 되었습니다. 인자 정확도는 4/4로, 잘못 만들어진 인자는 하나도 없었습니다.
여기서 이 예시가 알려주는 것은 E2E 점수 1과 단계별 점수 3/4가 동시에 성립한다 는 사실입니다. 사용자 관점에서는 완벽한 성공이지만, 비용 관점에서는 400줄짜리 파일을 컨텍스트에 통째로 밀어 넣은 한 번의 낭비가 기록되어 있습니다. 성공당 단계 수와 성공당 비용이 왜 별도의 축으로 필요한지가 이 한 줄에서 드러납니다.
HumanEval과 SWE-bench의 차이: 벤치마크가 도구 사용으로 수렴하는 이유
도구를 호출하는 것 과 과업을 완수하는 것 사이의 경계는 사실상 사라졌습니다. 일반적인 능력을 측정한다고 표방하는 벤치마크 대부분이 이제 도구 사용도 함께 측정하는데, 이유는 단순합니다. 쓸 만한 배포 환경 어디에서도 도구 없이 모델을 실행하지 않기 때문입니다. 도구 접근을 막아 둔 벤치마크는 아무도 실제로 출시하지 않는 형태의 능력을 채점하는 셈입니다.
모든 벤치마크가 그 선을 넘은 것은 아닙니다. HumanEval은 생성된 파이썬 코드를 단위 테스트로 실행하므로 실행 가능한 검증을 제공하지만, 도구 호출이 없고 행동할 환경도 없습니다. 반면 SWE-bench에서는 변화가 분명해집니다. 실제 GitHub 이슈를 해결하려면 코드베이스를 탐색하고, 패치를 작성하고, 테스트 스위트를 통과시켜야 하는데, 이는 파일 읽기와 검색, 편집 호출을 순서대로 이어 붙이는 일입니다. 점수는 결과를 재지만 그 아래 궤적은 전부 도구 호출로 이뤄져 있습니다. 즉, 일반 능력을 확인하려고 이미 실행하고 있는 벤치마크가 사실은 도구 사용을 함께 시험하고 있는 경우가 많습니다.
원문은 여기서 질문 자체를 다시 세웁니다.
학술 벤치마크는 모델의 능력 상한을 추상적인 형태로 측정합니다. 기업 벤치마크는 더 좁지만 훨씬 쓸모 있는 질문에 답합니다. 이 모델이 내 일을 할 수 있는가, 다시 말해 당신의 과업을, 당신의 API를 상대로, 당신의 정책 아래에서 수행할 수 있는가입니다.
벤치마크가 프로덕션 환경에 가까울수록 그 점수가 의사결정에서 차지하는 비중도 커져야 한다는 것이 원문의 결론입니다.
이 렌즈로 읽는 Nemotron 3.5 Lightning의 공개 점수
원문의 후반부는 지금까지의 렌즈를 NVIDIA 자사 모델에 적용하는 데 쓰입니다. Nemotron 3.5 Lightning은 활성 파라미터 3B짜리 30B 규모의 모델로, 장시간 실행되는 에이전트의 실행 계층을 겨냥해 만들어졌습니다. 모델 카드에 따르면 Mamba-2 계층과 MoE(Mixture-of-Experts) 계층을 교차 배치하고 일부 어텐션 계층을 섞은 하이브리드 구조이며, 라이선스는 OpenMDW-1.1입니다. 원문의 권고는 이 모델의 공개 점수를 호출 하나의 정확도 가 아니라 과업 완수와 완료까지 걸린 시간 으로 읽으라는 것입니다.
원문이 이름만 적고 지나간 세 벤치마크는 각각 다음과 같습니다.
-
Banking: 다중 턴 은행 상담 대화 전체에서 과업이 완수되었는지를 채점합니다. 앞에서 본 환불 트레이스를 규모 있게 키운 형태이지, 호출 한 건짜리 평가가 아닙니다. 원문이 링크로 단 Artificial Analysis 페이지를 열어 보면 이 항목의 정식 이름은 τ³-Banking입니다. 에이전트가 방대한 비정형 지식 베이스를 탐색하면서 다단계 도구 호출로 현실적인 은행 업무 흐름을 처리할 수 있는지를 보는 핀테크 고객 지원 벤치마크로, 앞서 소개한 τ-bench 계열의 후속 작업입니다.
-
GDPval-AA v2: 실제 직무 산출물을 바탕으로 구성한 에이전트 업무를 채점합니다. 여러 LLM 심판으로 구성된 패널이 쌍대 비교(pairwise comparison)로 판정하고, 그 결과를 인간 전문가 기준선에 맞춘 Elo 점수로 환산합니다(원문 표현은 Elo anchored to a 1,000 human-expert baseline 입니다). Artificial Analysis의 GDPval-AA 평가 페이지에 따르면 이 평가는 OpenAI의 GDPval 데이터셋을 44개 직업과 9개 주요 산업에 걸쳐 재구성한 것이고, 페이지 기준 현재 버전은 v2.1입니다. 원문이 이 벤치마크를 굳이 꺼낸 이유는 LLM 심판 점수를 믿을 만하게 만들어 주는 것이 바로 이런 형태의 인간 검증이기 때문입니다.
-
PinchBench: 오픈소스 코딩 에이전트를 만드는 Kilo가 공개한 벤치마크입니다. 일정 관리, 코딩, 이메일 분류, 조사, 파일 관리 등 실제 업무 범주에 걸친 53개 과업으로 구성되고, 과업마다 자동 채점과 LLM 심판 채점을 함께 쓰며 공개 리더보드를 운영합니다. 한 가지 눈여겨볼 점은 이 벤치마크가 모델을 단독으로 재는 것이 아니라 OpenClaw 에이전트의 두뇌로 얹었을 때의 성능을 잰다는 것입니다. 앞에서 본 하네스 변수가 이 점수 안에 그대로 포함되어 있습니다.
PinchBench에서 Nemotron 3.5 Lightning은 86%의 정확도를 기록하면서, 비슷한 정확도의 Qwen3.6 35B보다 10,000개 과업을 30% 빠르게 끝냈다는 것이 원문의 주장입니다. 아래가 그 근거로 제시된 산점도입니다.
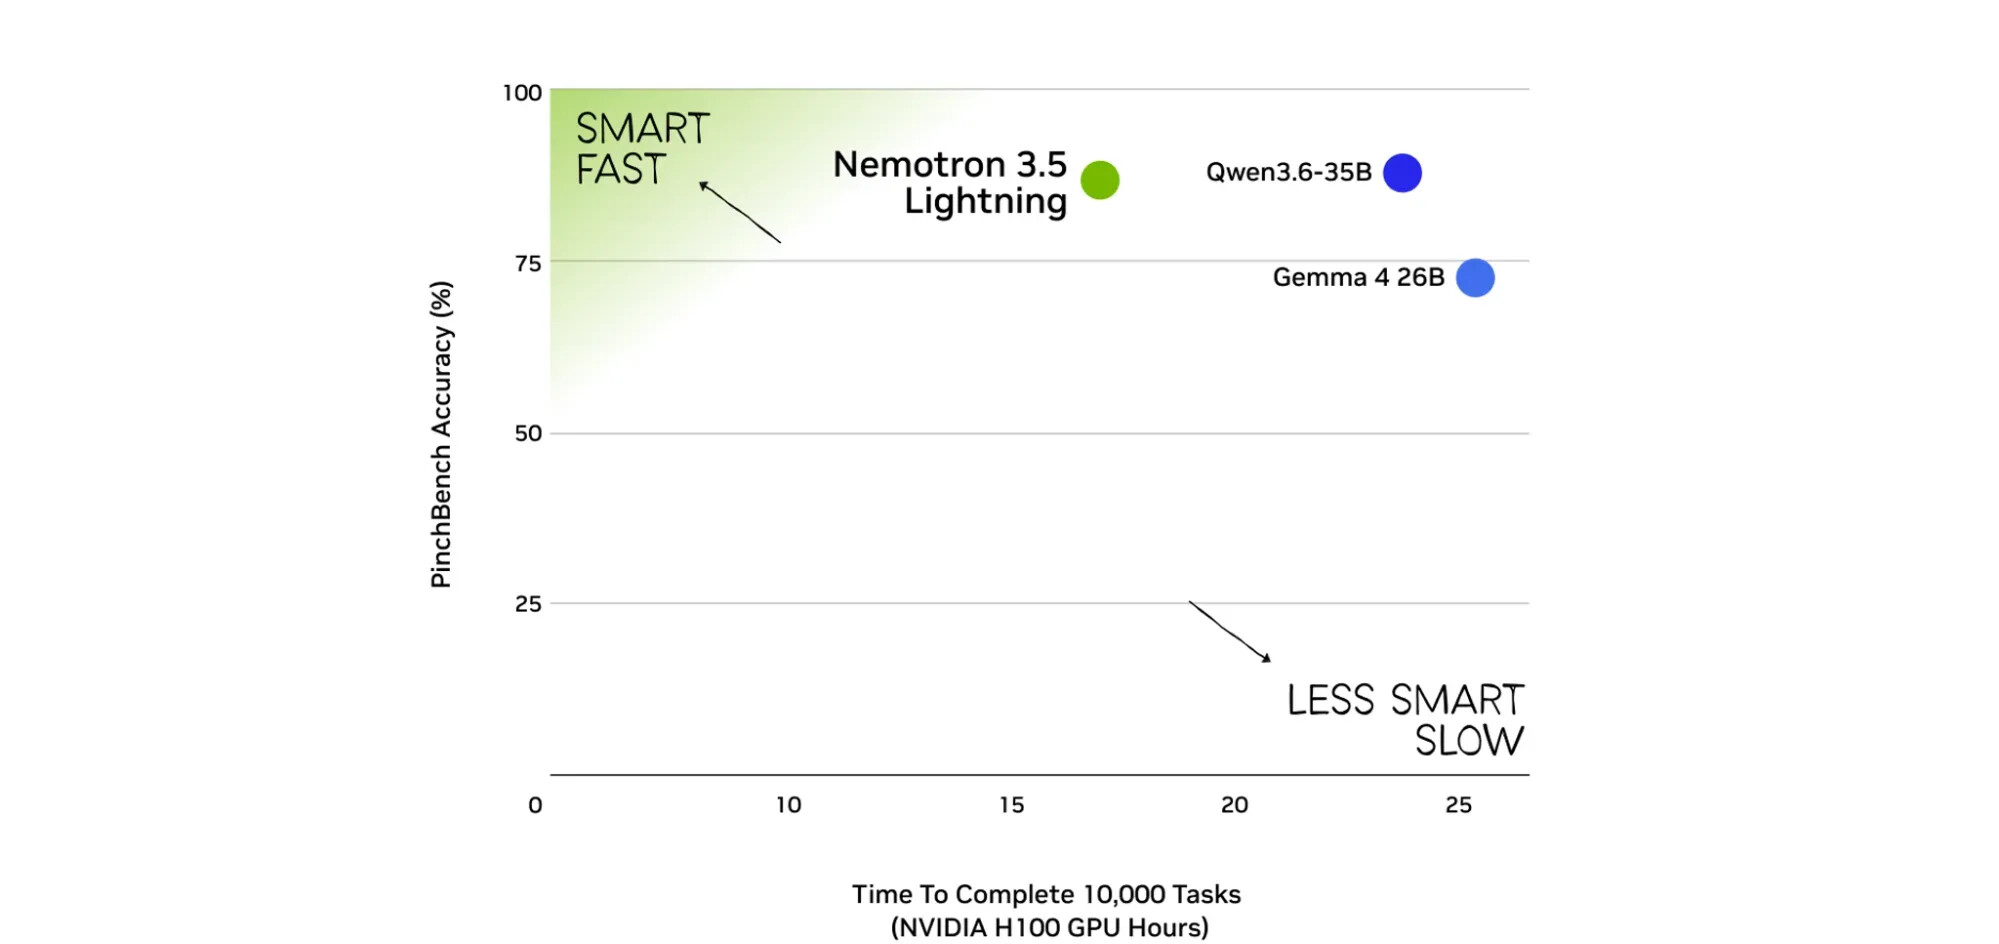
이 그림은 두 가지를 동시에 말합니다. 가로축에서 Nemotron 3.5 Lightning은 Qwen3.6-35B보다 H100 GPU 시간 기준으로 약 7시간 왼쪽(약 17시간 대 약 24시간)에 놓여 있고, 이 차이가 30% 빠르다 는 주장의 근거입니다. 그런데 세로축을 보면 Qwen3.6-35B의 점이 Nemotron 3.5 Lightning보다 미세하게 위 에 찍혀 있습니다. NVIDIA 스스로도 이 지점을 comparable accuracy 라고 표현했으니, 이 그래프에서 NVIDIA가 이긴 축은 정확도가 아니라 시간입니다. 참고로 NVIDIA가 이 그림에 붙인 대체 텍스트는 각각 10 GPU 시간과 20 GPU 시간이라고 적고 있는데, 그 값으로는 30%가 아니라 50% 단축이 되므로 본문의 주장과 어긋납니다. 그래프에 찍힌 위치 쪽이 본문 주장과 일치합니다.
원문이 이름만 적고 지나간 벤치마크들의 실제 점수는 모델 카드에 이미 공개되어 있습니다. NVIDIA가 NeMo Gym과 NeMo Evaluator라는 동일한 하네스로 측정했다고 밝혀 둔 표에서, 이 글이 다룬 항목만 옮기면 다음과 같습니다.
벤치마크 BF16 체크포인트 NVFP4 체크포인트 PinchBench 85.37 83.43 SWE-bench Verified 51.56 52.80 Terminal-Bench 2.1 24.58 23.46 τ³-bench (Banking) 9.28 9.48 GDPval-AA-V2 (Elo) 832 865원문 본문의 86% 는 이 표의 85.37(BF16)보다 조금 높고, 원문이 가중치 내려받기 대상으로 안내하는 NVFP4 체크포인트 기준으로는 83.43입니다. 그리고 원문이 과업 완수를 보는 렌즈 로 소개한 Banking은 정작 9.28에서 9.48 사이로, 이 모델이 표에서 가장 낮은 점수를 받은 항목입니다. GDPval-AA v2의 832에서 865 Elo도 앞서 본 인간 전문가 기준선 1,000 아래입니다. 원문이 이 숫자들을 숨긴 것은 아니지만, 벤치마크 이름만 읽고 넘어가면 과업 완수로 읽으라 는 그 권고를 적용한 결과가 무엇이었는지는 알 수 없습니다.
같은 모델 카드에는 하네스를 바꿔 가며 측정한 결과도 함께 실려 있습니다. 방법론이 왜 점수를 비교 불가능하게 만드는지를 이보다 분명하게 보여주는 자료를 찾기는 어렵습니다.
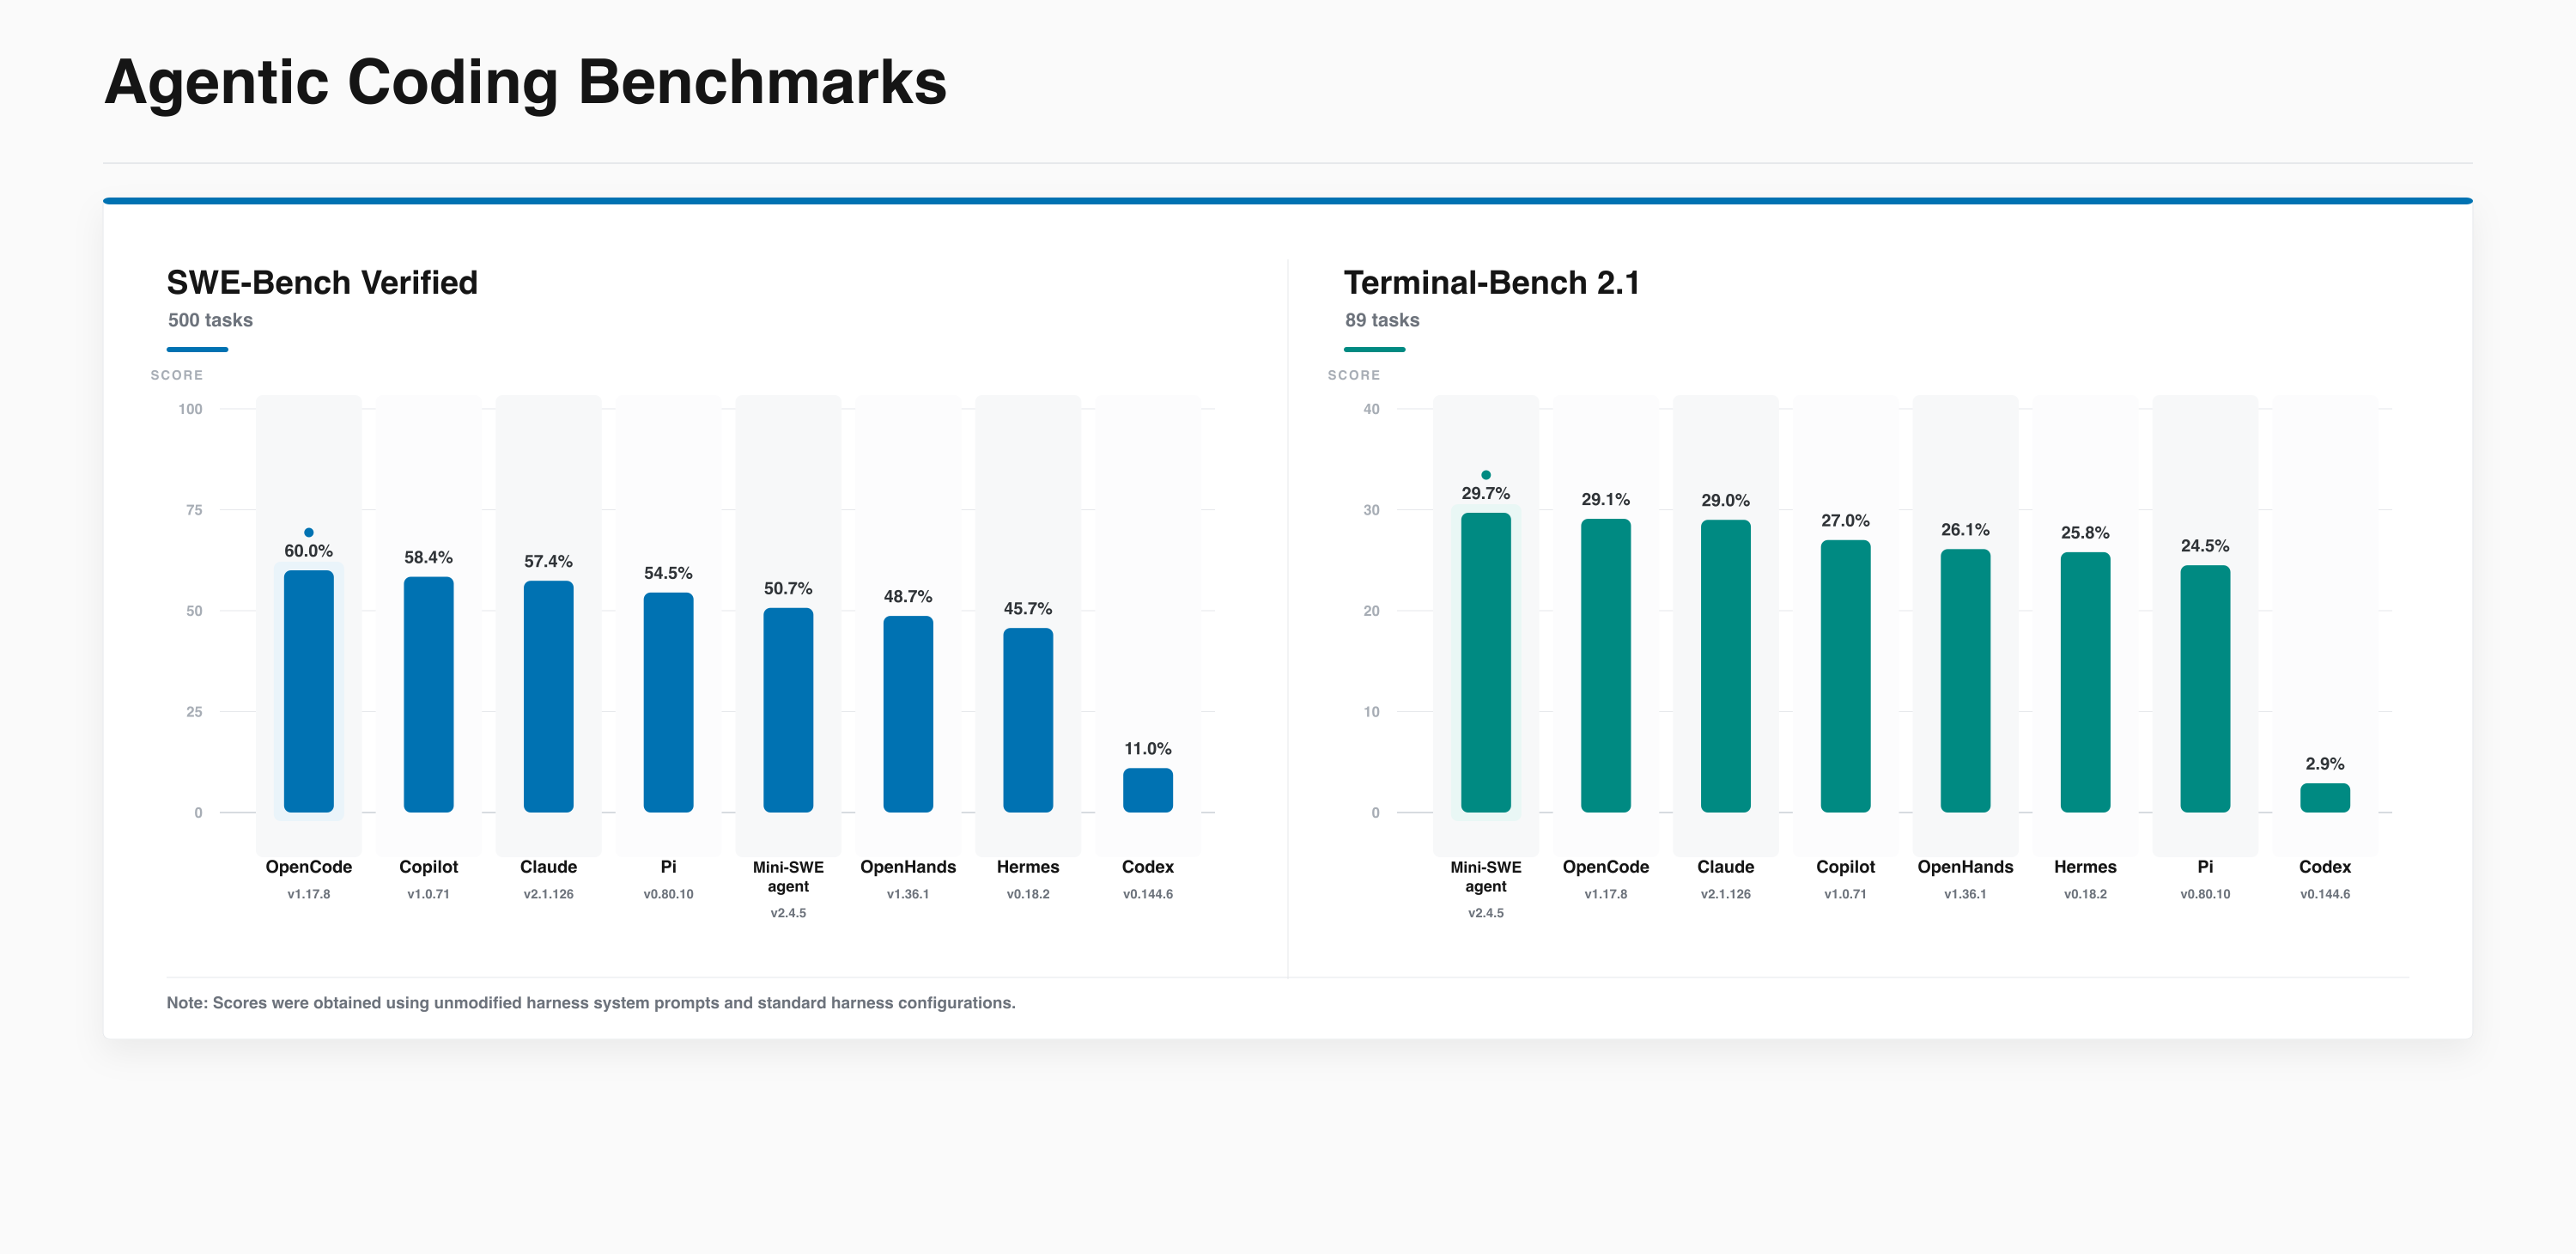
모델도 벤치마크도 고정한 채 하네스만 바꿨는데 SWE-bench Verified 점수가 60.0%(OpenCode)에서 11.0%(Codex)까지 벌어집니다. Terminal-Bench 2.1도 29.7%(Mini-SWE-agent)에서 2.9%(Codex)까지 갈립니다. 그림 아래 주석은 이 점수들이 하네스의 시스템 프롬프트를 수정하지 않은 표준 설정에서 나온 값이라고 밝히고 있으니, 튜닝 차이가 아니라 하네스 자체의 차이입니다. 위 표의 SWE-bench Verified 51.56도 이 분포 안의 한 점이며, 어느 하네스에서 잰 값인지를 빼면 다른 모델의 점수와 나란히 놓을 수 없습니다.
남는 아쉬움은 일관성입니다. 원문은 확률적인 시스템을 점 추정 하나로 보고하지 말고 3~5회 시행의 범위로 보고하라고 권했는데, 정작 자사 모델의 점수는 모델 카드에서도 단일 값으로 제시됩니다. 재현성 문서는 이 벤치마크들이 temperature > 0 에서 표본을 뽑고 반복 실행을 평균하므로 같은 레시피를 두 번 돌려도 마지막 자리까지 일치하지 않는다고 적으면서, 차이를 그 편차에 견주어 판단하라고 안내합니다. 편차가 있다는 사실은 밝혔지만 그 편차가 얼마인지는 공개되지 않았습니다. 원문도 공개 점수는 좋은 신호이지만 릴리즈 게이트로 삼아서는 안 된다 는 단서를 바로 다음 문단에 달아 두었습니다.
Nemotron 3.5 Lightning 더 알아보기
NVIDIA Nemotron 3.5 Lightning 소개 블로그 - 모델 설계와 추론 최적화를 다룬 원문
NVIDIA Technical Blog – 11 Aug 26NVIDIA Nemotron 3.5 Lightning Delivers Fast, Accurate Specialized Task...
Long-running AI agents spend most of their time on high-volume execution: tool calls, result validation, and subagent delegation. Using a frontier reasoning model for every execution step adds cost…
Nemotron 3.5 Lightning 재현성 문서 - 공개 점수를 재현하기 위한 설정 모음
github.com/NVIDIA-NeMo/Gymnemotron_recipes/lightning-3.5/reproducibility.md
main
# Reproducing the published evaluation results

This tutorial demonstrates how to reproduce the evaluation results for the NVIDIA
Nemotron 3.5 Lightning 30B A3B model using NeMo Gym.

The recipes are split by model:

- **[`instruct/`](./instruct/README.md)** — the instruct model. Most benchmarks are Gym
  recipes in [`instruct/gym/`](./instruct/gym/); Terminal-Bench and the two SWE-bench
  suites are NeMo Evaluator configs in
  [`instruct/nemo-evaluator/`](./instruct/nemo-evaluator/).
- **[`base/`](./base/README.md)** — the base (pretraining) model:
  `nvidia/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-Base-BF16`, 21 short-context benchmarks
  plus RULER. These are `nemo-evaluator-launcher` configs rather than Gym recipes, and
  their prerequisites differ.

## What you can reproduce

### Instruct model
NVIDIA NeMo Gym - 에이전트 환경 기반 평가와 롤아웃을 실행하는 오픈소스 라이브러리
github.comGitHub - NVIDIA-NeMo/Gym: Evaluate and improve models and agents using...
Evaluate and improve models and agents using environments
PinchBench 리더보드 - 53개 실제 업무 과업에서의 에이전트 완수 능력 순위
pinchbench.comBest Models by Success Rate | PinchBench
Find the best AI model for your OpenClaw agent. Compare success rates, speed, and cost across 100+ LLMs on real coding tasks.
자체 워크로드 벤치마킹 4단계
원문이 제안하는 실행 절차는 네 단계입니다. 공개 점수에서 출발하되 거기서 멈추지 말라는 것이 핵심입니다.
-
공개 기준선을 정합니다. 발표된 에이전트 스위트를 직접 실행해 성공률과 3~5회 시행에 걸친 범위를 기록합니다.
-
도메인 평가를 만듭니다. 실제 티켓과 트레이스, 사내 API에서 과업을 선별해 평가 집합을 구성합니다. 이때 게이트는 심판 모델이 최종 메시지를 보고 내리는 의견이 아니라 환경의 상태 에 걸어야 합니다. 데이터베이스의 한 행, 병합된 PR, 닫힌 티켓 같은 것들입니다.
-
모델과 하네스를 그 분포에 맞춥니다. 프롬프트와 도구 정의, 재시도 정책까지 포함한 적응 과정입니다.
-
다시 측정합니다. 성공률, 일관성, 성공당 단계 수, 성공당 비용을 재측정하고, 디버깅을 위해 단계별 트레이스를 계속 남겨 둡니다.
원문은 이 절차를 한 문장으로 압축해 둡니다. 결과는 환경에서 확인하고, 심판 모델은 언어를 채점하는 데 쓰고, 사슬이 어디서 끊어지는지는 도구 호출 정밀도와 인자 정확도로 찾으라는 것입니다.
이 평가 프레임을 실무에 적용할 때의 시사점
이 글의 기여는 새로운 벤치마크를 제안한 데 있지 않고, 이미 쏟아지는 에이전트 점수들을 어느 계층에서 읽어야 하는지 를 정리한 데 있습니다. 모델 선택 회의에서 흔히 벌어지는 논쟁, 그러니까 A 모델이 벤치마크 두 개에서 앞서는데 왜 우리 파이프라인에서는 B가 낫냐는 질문은 대부분 계층이 어긋나 있어서 생깁니다. 한쪽은 호출 정확도를 이야기하고 다른 쪽은 과업 완수를 이야기하는 것입니다.
실무에서 바로 쓸 수 있는 부분을 추리면 세 가지입니다. 첫째, 성공률을 점 추정으로 기록하는 습관을 범위 기록으로 바꾸는 것만으로도 모델 교체 판단의 근거가 달라집니다. 둘째, 성공당 비용은 총 토큰 소비가 아니라 성공한 과업 수로 나눈 값이어야 하며, 병렬 도구 호출을 켰다고 호출 수가 줄지는 않는다는 점을 계산에 반영해야 합니다. 셋째, 도메인 평가의 게이트를 최종 메시지가 아니라 데이터베이스 행과 병합된 PR 같은 환경 상태에 거는 것은 구현 난이도에 비해 얻는 신뢰도가 큽니다.
이 프레임은 모델을 처음 고를 때보다 모델을 교체할 때 더 쓸모가 있습니다. 교체 여부를 판단할 때 확인할 것은 두 가지입니다. 우리 과업 집합에서 두 모델의 성공률 범위가 겹치는지, 그리고 성공당 비용이 실제로 내려가는지입니다. 이 두 값을 상시 측정할 수 있게 해 두면 모델이 몇 달마다 바뀌어도 매번 같은 논쟁을 처음부터 반복하지 않아도 됩니다.
반대로 이 글이 다루지 않은 것도 분명합니다. 안전성과 권한 경계를 어떻게 평가할지, 사람이 개입하는 지점을 어떻게 채점에 반영할지는 여기서 다뤄지지 않습니다. 원문의 트레이스 예시도 저장소 하나를 상대로 한 단일 에이전트 실행이라, 여러 에이전트가 같은 환경을 공유할 때 생기는 상태 충돌은 시야 밖에 있습니다. 도구 호출을 경유한 공격 표면 쪽은 AgentDojo 같은 별도 평가 축이 따로 필요합니다.
How to Evaluate AI Agents From Tool Calls to Task Completion 소개 블로그
NVIDIA Technical Blog – 21 Sep 26How to Evaluate AI Agents From Tool Calls to Task Completion | NVIDIA...
When you ship an AI agent, the key question is whether it can execute a chain of work across dozens of sequential tool calls against a live environment, and recover when a step fails.
NVIDIA Nemotron 3.5 Lightning 소개 블로그
NVIDIA Technical Blog – 11 Aug 26NVIDIA Nemotron 3.5 Lightning Delivers Fast, Accurate Specialized Task...
Long-running AI agents spend most of their time on high-volume execution: tool calls, result validation, and subagent delegation. Using a frontier reasoning model for every execution step adds cost…
NVIDIA NeMo Gym GitHub 저장소
github.comGitHub - NVIDIA-NeMo/Gym: Evaluate and improve models and agents using...
Evaluate and improve models and agents using environments
NVIDIA Nemotron 3.5 Lightning (Hugging Face)
huggingface.convidia/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-NVFP4 · Hugging Face
We’re on a journey to advance and democratize artificial intelligence through open source and open science.
build.nvidia.com Nemotron 3.5 Lightning 체험 페이지
NVIDIA NIMnemotron-3.5-lightning-30b-a3b Model by NVIDIA | NVIDIA NIM
Fastest 30B A3B MoE model with leading domain accuracy for specialized agentic tasks
더 읽어보기
-
The LLM Evaluation Guidebook: Hugging Face가 공개한 LLM 평가를 위한 종합적이고 실질적인 안내서
-
HarnessTax: 7가지 모델 x 3가지 하네스로 실험한, 모델과 하네스에 따른 성능과 비용에 대한 연구 (feat. UC Berkeley)
-
Artificial Analysis가 공개한 코딩 에이전트 벤치마크: 모델 + 하네스의 조합으로 평가한 벤치마크 결과
-
PandaProbe: 에이전트의 실패를 추적/평가하여 스스로 고치는 자기 치유 하네스를 구현한 오픈소스 플랫폼
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
파이토치 한국 사용자 모임은 이런 글들을 한국어로 정리해 나누고 있습니다. 회원으로 가입하시면 주요 글들을 이메일로 보내드리고, 텔레그램(Telegram)과 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.
아래쪽에 좋아요를 눌러주시면 다음 글을 정리하는 데 힘이 됩니다~
1개의 게시물 - 1명의 참여자