
pgjev 소개
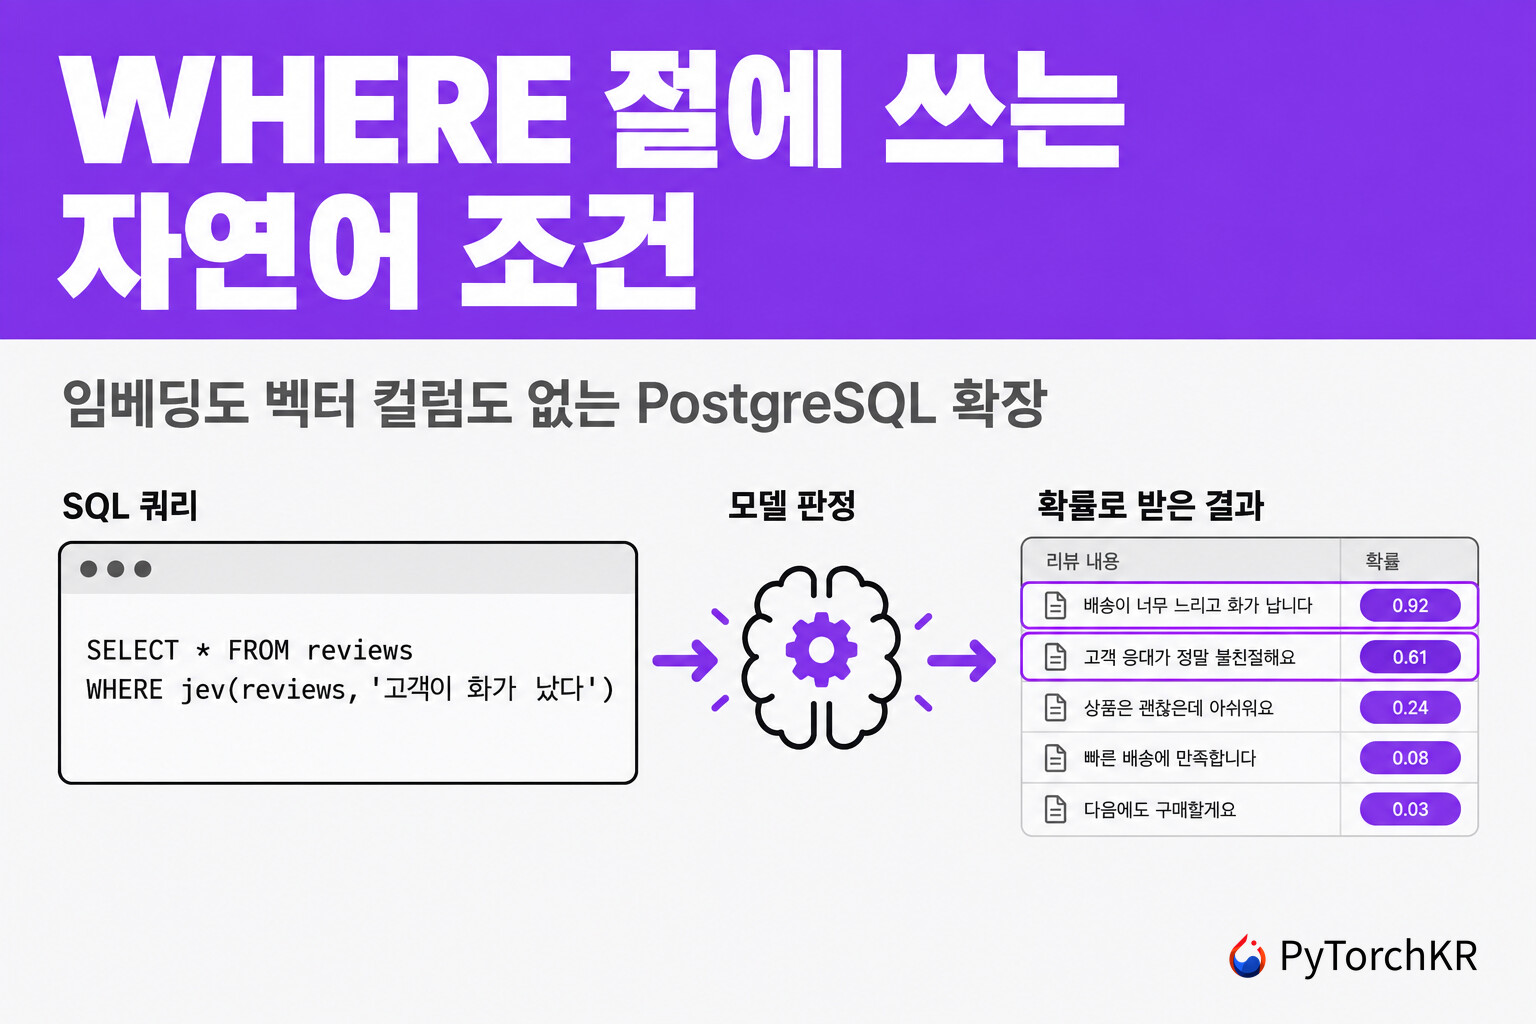
고객 문의 테이블에서 화가 난 고객이 보낸 문의만 골라내는 작업을 생각해 보면, PostgreSQL 안에서 쓸 수 있는 수단이 생각보다 좁습니다. 전문 검색(Full Text Search)은 키워드가 들어 있는지를 볼 뿐이라 환불을 요구하지는 않았는데 화가 난 문의를 가려내지 못합니다. pgvector로 임베딩(Embedding) 컬럼을 두는 방법은 의미를 다루긴 하지만 돌려받는 값이 유사도 순위라서 조건을 만족하는지 아닌지를 판정해 주지 않고, 임베딩을 만들고 갱신하는 파이프라인을 따로 운영해야 합니다. 남는 선택지는 행을 애플리케이션으로 꺼내 생성형 LLM에 보내고 결과를 파싱해 다시 테이블에 기록하는 방식인데, 이렇게 하면 판정 로직이 SQL 밖으로 나가서 JOIN이나 GROUP BY와 함께 쓸 수 없게 됩니다. 이번에 소개하는 pgjev는 이 판정을 WHERE 절 안에 그대로 두는 PostgreSQL 확장(Extension)입니다.
pgjev가 추가하는 jev(테이블, '조건')은 평범한 boolean 함수입니다. 조건 자리에는 사람이 말하듯 쓴 문장이 들어가고, 테이블의 각 행은 TypeSafe의 Jev 모델이 판정합니다. Jev는 텍스트를 생성하는 대신 보정된 확률(Calibrated Probability)을 돌려주는 System One 모델이라, 결과가 파싱해야 하는 문자열이 아니라 SQL이 곧바로 쓸 수 있는 boolean과 실수입니다. 그래서 AND age > 40을 덧붙이거나 ORDER BY jev_prob(...)로 정렬하거나 GROUP BY로 집계하는 일이 다른 SQL 함수와 똑같이 동작합니다. 인덱스도 임베딩도 벡터 컬럼도 만들지 않는다는 점이 pgjev가 내세우는 차별점입니다.
pgjev를 만든 사람은 Zachi이고, 확장은 PL/Python(plpython3u)으로 구현되어 있어 C 컴파일 과정 없이 jev.control과 SQL 파일만 복사하면 설치가 끝납니다. 한 가지 짚고 갈 것은 이름이 자리마다 다르다는 점입니다. 프로젝트가 자신을 부르는 이름은 pgjev이지만, GitHub 저장소는 pg-jev이고 PostgreSQL 확장과 SQL 함수의 이름은 jev입니다. 아래 설치 명령과 쿼리에서는 이 식별자들을 그대로 써야 동작하므로 바꿔 적지 않았습니다. 또한 pgjev는 TypeSafe의 모델을 호출하지만 TypeSafe가 만든 확장은 아닙니다. Zachi는 Jev와 TypeSafe가 각 소유자의 상표이며 이 프로젝트가 TypeSafe와 제휴 관계가 아니라고 명시하고 있습니다.
pgjev와 기존 PostgreSQL 검색 방식 비교
같은 질문을 PostgreSQL 안에서 푸는 네 가지 방식을, 무엇이 판정을 내리고 무엇을 사전에 준비해야 하는지로 갈라 보면 다음과 같습니다:
방식 판정하는 주체 사전에 준비하는 것 돌려받는 값 전문 검색 PostgreSQL 자체tsvector 컬럼과 GIN 인덱스
키워드 일치 여부
임베딩 기반 벡터 검색
임베딩 모델과 거리 함수
임베딩 컬럼과 갱신 파이프라인, 규모가 커지면 벡터 인덱스
유사도 순위
애플리케이션에서 생성형 LLM 호출
생성형 LLM
호출과 파싱, 결과를 다시 쓰는 코드
텍스트(직접 파싱)
pgjev
Jev(System One 모델)
확장 설치와 API 키
boolean, 확률, 등급 점수, 분류
위 표에서 가장 큰 차이는 마지막 열입니다. 앞의 세 방식은 순위나 텍스트를 돌려주기 때문에 이 행이 조건을 만족하는지를 판정하는 일을 사람이 한 번 더 해야 하지만, pgjev는 그 판정 자체를 값으로 돌려줍니다. jev_prob()이 돌려주는 0에서 1 사이의 확률은 순위 정렬에도 쓰이고 임계값(Threshold) 조정에도 쓰이므로, 결과가 마음에 들지 않을 때 조건 문구부터 고칠지 임계값부터 낮출지를 숫자를 보고 정할 수 있습니다.
PostgreSQL 안에 AI 기능을 넣으려는 시도 자체는 새롭지 않습니다. Tiger Data(옛 Timescale)가 공개한 pgai ( pgAI: PostgreSQL의 인공지능 기능을 위한 확장 (feat. Timescale))가 같은 계열인데, pgai는 임베딩을 자동으로 만들고 동기화하는 쪽에 무게가 실려 있어 pgjev와 겨냥하는 목표가 다릅니다. 다만 Tiger Data는 2026년 2월부터 pgai를 유지보수하거나 지원하지 않는다고 밝혔고 저장소도 보관(Archived) 상태로 바뀌었으므로, 지금 새로 도입할 대상은 아닙니다.
한 가지 더 구분할 것은 pgjev가 text-to-SQL이 아니라는 점입니다. feyn의 SQRL처럼 자연어 질문을 SQL 쿼리로 바꾸는 접근은 쿼리 작성 자체를 모델에 맡기지만, pgjev에서 SQL은 사람이 씁니다. 모델이 맡는 것은 WHERE 절에 들어간 조건 하나를 행마다 판정하는 일뿐이고, 산술과 날짜 비교와 정확한 일치는 SQL에 그대로 남겨 두라고 Zachi는 권합니다.
pgjev를 사용하면 좋을 사용자
pgjev를 도입하기 좋은 팀은 자체 운영(Self-hosted) PostgreSQL에 superuser 권한이 있고, 수천에서 수만 행 규모의 텍스트 컬럼을 의미 기준으로 분류하거나 걸러내야 하는 팀입니다. 임베딩 파이프라인을 새로 세우지 않고 CREATE EXTENSION 한 번으로 시작할 수 있어서, 조건 문구를 바꿔 가며 결과를 살펴보는 탐색 단계에서 특히 비용이 적게 듭니다.
반대로 pgjev가 맞지 않는 경우도 분명합니다. Supabase/Neon/Cloud SQL/RDS/Aurora/Azure Database처럼 superuser 권한과 plpython3u를 열어 주지 않는 관리형 PostgreSQL을 쓰는 팀에게는 pgjev가 선택지가 아닙니다. plpython3u는 신뢰할 수 없는(Untrusted) 언어라 서버 프로세스의 OS 권한으로 실행되고, 그래서 관리형 호스트 대부분이 이 언어를 막아 두었기 때문입니다.
행 내용이 외부로 나가면 안 되는 데이터를 다루는 팀에게도 pgjev는 적절하지 않습니다. 판정 대상이 되는 행은 통째로 직렬화되어 TypeSafe의 API로 전송되며, 이 점은 pgjev 문서의 주의 사항에도 그대로 명시되어 있습니다. 필요한 컬럼만 담은 뷰를 만들어 그 뷰에 jev()를 거는 방법으로 전송 범위를 줄일 수는 있지만, 어느 컬럼도 내보낼 수 없는 데이터라면 이 방법도 답이 되지 못합니다.
규모에 대한 판단도 필요합니다. pgjev는 인덱스로 건너뛸 수 있는 구조가 아니라 jev()에 도달한 행을 전부 API로 보내는 전수 스캔입니다. Zachi는 이 점을 "That is the product, not a bug"라고 밝히고 있습니다. 따라서 수십만 행짜리 테이블에 조건 없이 거는 사용법은 맞지 않고, 인덱스가 걸린 값싼 조건으로 대상을 먼저 줄인 뒤 남은 행에만 거는 사용법이 맞습니다.
pgjev의 동작 원리
pgjev 0.2.0이 한 행을 판정하기까지의 경로는 세 계층을 지납니다. 아래 그림은 SQL 실행기가 넘긴 행이 캐시 계층, 읽기 선행 계층, 배치 전송 계층을 거쳐 TypeSafe의 API까지 갔다가 확률로 돌아오는 흐름을 정리한 것입니다.
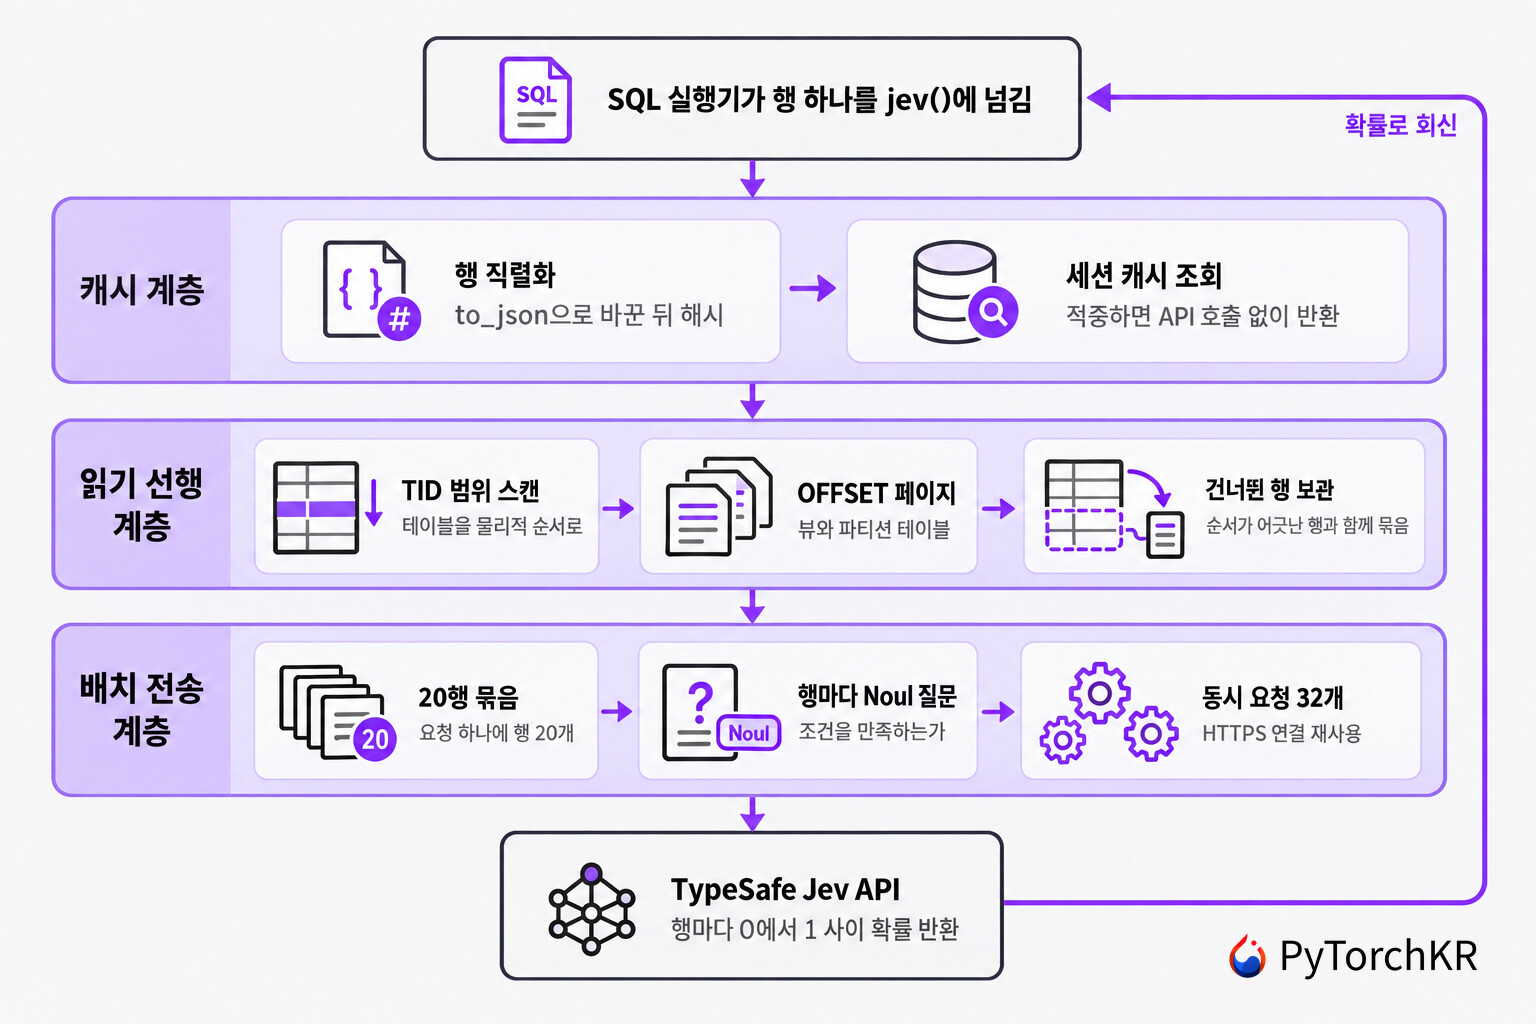
각 단계를 순서대로 보겠습니다:
-
행 수신과 캐시 조회:
jev(tickets, '…')는 행을 복합 타입(Composite Type) 값으로 받아to_json으로 직렬화한 뒤 해시합니다. 캐시 키는 테이블 이름이 아니라 관계 타입과 질문, 그리고 행 내용으로 만들어지며, 세 가지가 모두 같은 행이 이미 판정되어 있으면 API도 SPI도 건드리지 않고 즉시 돌려줍니다. -
읽기 선행(Read-ahead): 캐시에 없는 첫 행이 나오면 테이블을 물리적 순서로 훑는 작업이 시작됩니다. 일반 테이블과 구체화 뷰(Materialized View)는 TID(Tuple ID) 범위 스캔으로, 일반 뷰와 파티션 테이블과 외부 테이블은
OFFSET과LIMIT페이지로 읽습니다. 한 번에 1,000행씩 가져오기 때문에 테이블이 아무리 커도 메모리 사용량은 일정합니다. -
배치 구성: 읽어 온 행은
jev.batch_size(기본 20)개씩 묶여 하나의 상태(State)로 포장됩니다. 요청 본문은{"condition": …, "rows": […]}형태이고, 행마다 하나씩 Noul 질문이 붙어 배열의 i번째 레코드가 조건을 만족하는지를 묻습니다. 요청 하나가 20개 질문을 한꺼번에 처리하므로 요청마다 드는 약 270토큰의 고정 비용이 분산되고, 행당 입력 토큰이 혼자 보낼 때의 약 435개에서 약 175개로 줄어듭니다. -
병렬 요청: 요청은
jev.concurrency(기본 16)개가 병렬로 나가고 그 두 배인 32건까지 실행기 앞의 대기열에 올라가며, 연결은 세션마다 유지되는 HTTPS 연결을 재사용합니다. 각 행은 자기가 속한 배치가 돌아오는 즉시 답을 받으므로 실행기가 테이블 전체를 기다리지 않고,LIMIT이 붙으면 진행 중인 요청만 마친 뒤 읽기 선행이 멈춥니다. 같은WHERE절의 값싼 조건에서 이미 탈락한 행은 판정 대상에서 빠집니다. 다만ORDER BY jev_prob(...)로 정렬하면서LIMIT을 거는 경우에는 정렬에 모든 행의 확률이 필요하므로 요청 수가 줄지 않습니다. -
순서가 어긋난 행: 인덱스 역방향 스캔이나 조인 때문에 실행기가 물리적 순서와 다르게 행을 요구하면, 그 행은 혼자 보내지지 않고 건너뛴 이웃 행들과 함께 묶입니다.
jev.max_prefetch_rows(기본 5,000)가 읽기 선행이 얼마나 멀리까지 찾아볼지와 건너뛴 행을 얼마나 기억할지를 제한합니다. -
세션 캐시: 판정 결과는 PL/Python의
GD딕셔너리에 행 내용 기준으로 저장됩니다. 같은 조건으로 임계값을 바꾸거나 정렬 기준을 바꾸거나 집계를 다시 실행하는 일은 추가 비용이 들지 않고, 조건 문구를 한 단어라도 바꾸면 새 스캔이 됩니다. 캐시가 백엔드 세션에 묶여 있다는 점은 운영에서 걸리는 지점인데, 연결 풀(Connection Pool)을 쓰면 백엔드마다 캐시를 따로 채우게 되고jev_cache_clear()도 현재 세션만 비웁니다.
여기서 걸리기 쉬운 함정이 하나 있습니다. 서브쿼리나 CTE가 만들어 내는 익명 record 타입 행은 어느 테이블에서 왔는지 알 수 없어 읽기 선행이 불가능하고, 결국 행마다 요청 한 건씩 나갑니다. Zachi는 이것을 pgjev 쿼리가 느려지는 가장 흔한 이유로 꼽으면서 필요한 컬럼만 담은 뷰를 만들어 그 뷰에 jev()를 걸라고 권합니다. 뷰는 테이블과 똑같이 읽기 선행과 배치 처리의 대상이 됩니다.
pgjev가 요청당 20행을 묶는 이유
jev.batch_size 기본값은 0.1.0의 40에서 0.2.0의 20으로 내려갔습니다. 모델이 배열 안에서 rows[i]를 위치로 찾아야 하는데 배열이 길어질수록 그 대응이 흔들리기 때문입니다. Zachi가 직무 명칭, EU 회원국 여부, 자유 서술 필드의 특정 문구라는 세 가지 구조화된 컬럼을 정답(Ground Truth)으로 삼아 각 400행으로 측정한 결과는 다음과 같습니다:
행 하나가 1,000자까지 길어져도 20행 묶음에서는 차이가 없었고, 행에 번호 대신 이름을 붙이는 방법도 도움이 되지 않았습니다. 20행 묶음은 40행 묶음보다 입력 토큰을 4% 더 쓰지만 속도는 같은데, 요청 하나의 지연 시간이 요청 크기에 거의 좌우되지 않기 때문입니다.
pgjev가 제공하는 SQL 함수
pgjev가 추가하는 함수는 판정 결과의 모양에 따라 나뉩니다:
함수 반환 타입 용도jev(row, condition [, threshold])
boolean
WHERE 절 조건. 임계값은 인자, jev.threshold, 0.5 순으로 적용
jev_prob(row, condition)
float8
행이 조건을 만족할 확률 0에서 1
jev_score(row, question, levels text[])
float8
순서가 있는 등급 목록에서의 확률 가중 위치(0에서 n-1)
jev_score_norm(row, question, levels)
float8
같은 값을 0에서 1로 정규화
jev_choice(row, question, options text[])
text
행에 가장 그럴듯한 선택지 하나
jev_confidence(row, question, kind, options)
float8
score와 choice 답의 신뢰도
jev_eval(row, question, kind, options)
jsonb
확률, 범례, 신뢰도가 담긴 원본 응답
jev_stats()
jsonb
이 세션의 요청 수, 토큰, 추정 비용, 캐시 적중, 진행 중 요청, 연결 수
jev_cache_clear()
void
캐시된 판정 결과 삭제
jev_version()
text
확장 버전
첫 번째 인자 row에는 테이블 별칭(Alias) 자체를 넣습니다. Zachi가 README에 실은 사용 예시는 다음과 같습니다:
CREATE EXTENSION jev CASCADE;

SELECT * FROM people WHERE jev(people, 'the name is European');

SELECT subject, jev_prob(tickets, 'the customer is angry') AS p
FROM tickets ORDER BY p DESC LIMIT 20;

SELECT jev_choice(tickets, 'which team should handle this?',
                  ARRAY['billing', 'technical', 'security', 'sales']) AS team, count(*)
FROM tickets GROUP BY 1;

SELECT name, jev_score(products, 'how luxurious is this product?',
                       ARRAY['budget', 'mid-range', 'premium', 'luxury']) AS luxury
FROM products ORDER BY luxury DESC;
조건 문구를 어떻게 쓰느냐가 결과를 크게 가르기 때문에, Zachi는 라벨이 아니라 관찰 가능한 행동을 적으라고 권합니다. 'churn risk'보다 'the customer threatens to leave, dispute a charge, or take legal action'이 낫다는 식입니다. 임계값을 정하기 전에 확률 분포부터 보는 방법도 함께 안내하는데, 애매한 행은 실제로 0.5 근처에 모입니다:
SELECT width_bucket(jev_prob(reviews, 'the customer sounds frustrated'), 0, 1, 10) AS bucket,
       count(*)
FROM reviews
GROUP BY 1 ORDER BY 1;
같은 테이블과 같은 조건이면 두 번째 쿼리는 캐시에서 답하므로, 임계값을 바꿔 가며 다시 실행하는 데는 추가 비용이 들지 않습니다.
pgjev의 측정된 성능과 비용
아래 수치는 Zachi가 유럽에서(API까지 왕복 약 190밀리초) 2,000행 테이블로 직접 측정해 공개한 값입니다:
상황 결과 새 조건으로 2,000행 판정 약 3.5초, 요청 100건, 입력 토큰 약 296,000개 같은 세션에서 같은 쿼리 재실행 약 50밀리초(캐시) 새 조건에LIMIT 3
약 0.6초
연결이 살아 있는 세션의 새 조건
약 2.3초
0.1.0 버전의 같은 전체 쿼리
8.5초, 입력 토큰 338,000개
0.1.0에서 0.2.0으로 오면서 전체 쿼리가 8.5초에서 3.5초로, LIMIT 3이 8.4초에서 0.6초로 줄었습니다. 바뀐 것은 모델이 아니라 호출 방식으로, 테이블 전체를 먼저 읽던 방식을 스트리밍 읽기 선행으로 바꾸고 요청마다 맺던 TLS 연결을 재사용하도록 바꾼 결과입니다. Zachi는 요청당 TLS 핸드셰이크를 없애면서 유럽 기준 요청 시간이 880밀리초에서 300밀리초로 줄었다고 적고 있습니다.
비용은 입력 토큰에만 부과됩니다. jev-1.13 기준 100만 토큰당 0.042달러이고 출력 토큰은 무료라, 20행 묶음에서 행당 약 175토큰을 쓴다고 보면 행당 대략 0.0000074달러입니다. 위의 2,000행 쿼리가 약 0.012달러이고 같은 계산으로 1,000행은 약 0.007달러, 10만 행은 약 0.7달러가 됩니다. 실행 중에는 jev.notices가 켜져 있으면 요청이 끝날 때마다 진행 상황이 NOTICE로 나오고, 세션 누적치는 jev_stats()가 돌려줍니다.
pgjev 설치와 사용
pgjev를 설치하려면 PostgreSQL 14에서 17 사이의 자체 운영 서버, plpython3u, superuser 권한, TypeSafe 콘솔에서 발급한 API 키, 그리고 데이터베이스 서버에서 api.typesafe.ai:443으로 나가는 아웃바운드 HTTPS가 필요합니다. API를 호출하는 주체가 클라이언트가 아니라 서버 프로세스이므로, 데이터베이스 서버의 이그레스(Egress)가 막혀 있으면 설치는 끝나도 쿼리가 타임아웃으로 떨어집니다. Debian과 Ubuntu에서는 postgresql-plpython3-NN 패키지가 그 언어를 제공하고, EDB(EnterpriseDB) 빌드와 Postgres.app에는 이미 포함되어 있습니다. 설치 전에 서버 상태부터 확인하는 쿼리는 다음과 같습니다:
SHOW server_version;
SELECT * FROM pg_available_extensions WHERE name = 'plpython3u';
가장 간단한 경로는 PostgreSQL 확장 배포 저장소인 PGXN(PostgreSQL Extension Network)에 올라간 배포판을 pgxn 클라이언트로 받는 방법입니다. 마지막 줄의 CASCADE는 plpython3u까지 함께 생성하라는 뜻이므로 빼지 않습니다:
pip install pgxnclient
pgxn install jev
psql -c "CREATE EXTENSION jev CASCADE"
컴파일 과정이 없어 make install은 jev.control과 sql/jev--*.sql을 확장 디렉토리로 복사하는 일만 하지만, make와 대상 서버의 pg_config는 있어야 합니다(Debian과 Ubuntu에서는 postgresql-server-dev-NN 패키지). 저장소를 직접 받아 PostgreSQL의 확장 빌드 도구인 PGXS로 설치하는 명령은 다음과 같습니다:
git clone https://github.com/realZachi/pg-jev.git && cd pg-jev
make install
psql -c "CREATE EXTENSION jev CASCADE"
이미 0.1.0을 설치해 둔 서버라면 확장 파일을 같은 방법으로 새로 설치한 뒤 ALTER EXTENSION jev UPDATE;로 올립니다.
API 키는 서버 프로세스의 환경 변수 TYPESAFE_API_KEY로 두거나, 세션이나 역할(Role) 단위로 지정합니다:
SET jev.api_key = 'your-key';
ALTER ROLE analyst SET jev.api_key = 'your-key';
호스트에 설치하지 않고 먼저 써 보고 싶다면 저장소의 Dockerfile이 postgres:<major> 이미지에 plpython3u와 확장 파일을 얹어 줍니다. 설치 과정 자체를 에이전트에 맡기는 경로도 있는데, 저장소가 skills.sh에 에이전트 스킬을 함께 배포하고 있어서 npx skills add realZachi/pg-jev로 프로젝트에 설치하면 Claude Code나 Codex 같은 스킬 인식 에이전트가 사전 점검부터 스모크 테스트까지 이어서 수행합니다.
운영 중 지출을 묶어 두는 설정도 준비되어 있습니다. jev.max_rows_per_statement는 한 문장이 API로 보낼 행 수가 이 값을 넘으면 문장을 중단시키고, jev.max_chars_per_statement는 같은 일을 문자 수 기준으로 합니다. 둘 다 기본값이 0(끔)이므로 여러 사람이 함께 쓰는 환경이라면 다음과 같이 켜 두는 편이 안전합니다:
SET jev.max_rows_per_statement = 2000;
실행 중인 문장을 중간에 끊어야 할 때는 statement_timeout과 취소 요청이 250밀리초 안에 적용되므로, 응답을 기다리는 요청 때문에 쿼리가 묶이지는 않습니다.
모델을 고정해야 하는 경우도 있습니다. jev.model의 기본값은 jev-latest인데, 판정 결과가 보고서로 들어가는 상황이라면 jev-1.13.0처럼 버전을 지정해 두라고 Zachi는 권합니다. 저장소의 회귀 테스트는 결정적인 모의 API를 상대로 돌기 때문에 실제 API 호출 없이 PostgreSQL 14에서 17까지 검증합니다.
pgjev의 라이선스
pgjev는 PostgreSQL 라이선스로 공개되어 있어 개인 및 상업적 목적으로 자유롭게 사용할 수 있습니다. MIT와 BSD 계열에 가까운 허용적(Permissive) 라이선스이고, 저작권 고지와 면책 조항을 사본에 포함하는 것 외의 의무는 없습니다.
pgjev 공식 홈페이지
pgjevpgjev - ask your Postgres tables questions in plain language
Ask your Postgres tables questions in plain language. jev() returns a boolean, a probability, a rubric score or a class per row. No embeddings, no index.
pgjev 문서 사이트
pgjevIntroduction · pgjev
Filter, rank, and classify Postgres rows in plain language.
pgjev 프로젝트 GitHub 저장소
github.comGitHub - realZachi/pg-jev: Ask your Postgres tables questions in plain...
Ask your Postgres tables questions in plain language. A PostgreSQL extension powered by TypeSafe's Jev.
pgjev의 PGXN 배포 페이지
PGXN: PostgreSQL Extension Networkjev: Ask your Postgres tables questions in plain language: filter, rank and...
jev(table, 'condition') judges every row of a table with TypeSafe's System One model and returns a boolean, a probability, a rubric score or a class. The table is streamed in physical order and judged in small parallel API requests over persistent...
더 읽어보기
-
Hugging Face가 Papers with Code 논문 11만 편의 하이브리드 검색을 만든 방법 (feat. pgvector, RRF)
-
하루 15,000개 질문에 답하는 Cerebras의 사내 지식 베이스 설계 노하우 (feat. pgvector, RRF, MCP)
-
Postgres Pro: 인덱스 튜닝, 상태 점검, 안전한 SQL 실행 기능을 갖춘 Postgres MCP 서버
-
Distil-Text2SQL(SQirreL): 자연어 질문을 SQL 쿼리로 변환하는, 로컬에서 실행 가능한 경량 모델(0.6B/4B)
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
파이토치 한국 사용자 모임에서 이런 글들을 계속 정리하고 있습니다. 회원 가입으로 주요 글들을 이메일로, 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 새 글 알림을 받아보세요!
아래쪽에 좋아요를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
1개의 게시물 - 1명의 참여자