
Jev Search: 사용자의 질의에 대해, 어디를 검색해야 하는지 URL과 순위만 제공하는 웹 검색 프로젝트
Jev Search 소개
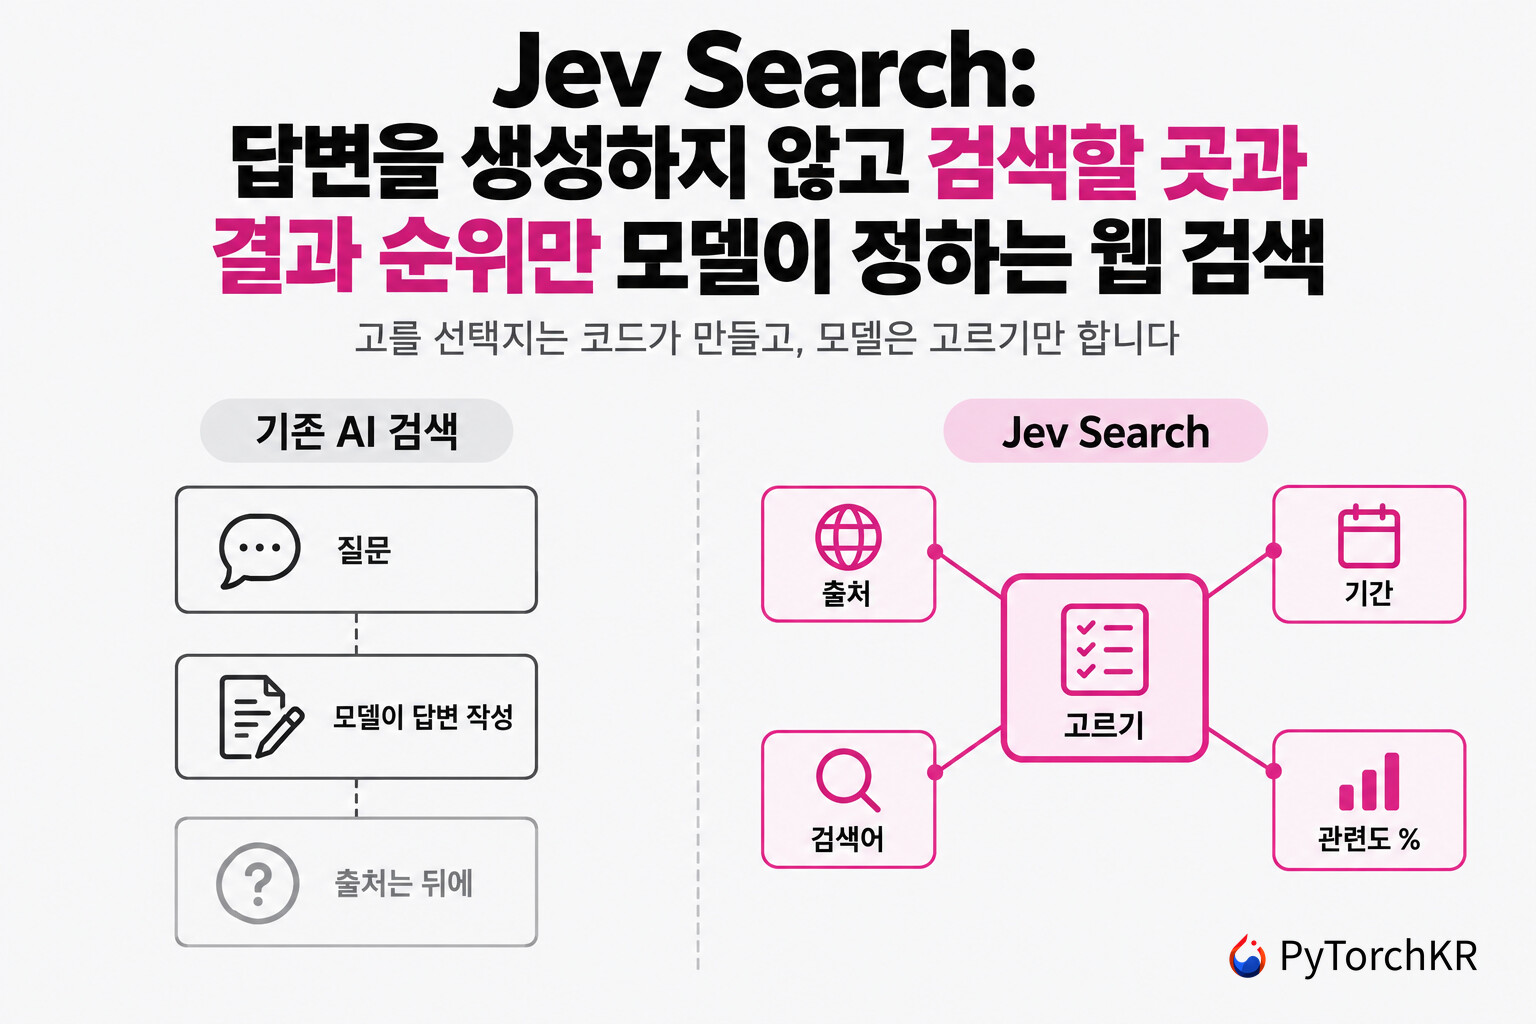
웹 검색에 언어 모델을 결합하는 방식은 지금 거의 하나로 수렴해 있습니다. 사용자의 질문을 모델이 읽고, 검색어를 새로 써서 엔진에 던지고, 돌아온 문서를 다시 읽어 답변 문장을 만들어 냅니다. 편리한 대신 대가가 따릅니다. 검색어를 모델이 매번 새로 쓰기 때문에 같은 질문이 같은 검색으로 이어진다는 보장이 없고, 화면에 남는 것이 링크가 아니라 문장이라 그 문장이 원문을 정확히 옮겼는지는 사용자가 따로 확인해야 합니다. 이번에 소개하는 Jev Search는 반대쪽에서 출발한 웹 검색 애플리케이션으로, 모델에게 문장을 쓰게 하지 않고 어디를 찾을지 고르는 일과 돌아온 결과가 질문에 맞는지 채점하는 일만 맡깁니다.
Jev Search가 판단에 쓰는 모델은 TypeSafe의 Jev ( Jev, 토큰 대신 확률적 결정을 내놓는 새로운 형태의 System One 모델 (feat. TypeSafe AI))인데, 이 모델은 애초에 문자열을 만들어 내지 못합니다. Jev는 타입이 정해진 질문에 확률로 답하는 System One 모델이라, 주어진 선택지 중 하나를 고르거나 어떤 진술이 참일 확률을 돌려주는 일만 합니다. 그래서 Jev Search는 보통과 반대 방향으로 설계되어 있습니다. 검색어 후보, 출처 목록, 기간 구간을 전부 코드가 미리 만들어 두고, Jev는 그중에서 고르기만 합니다. 저장소의 src/lib/candidates.ts 주석은 이 설계를 "The judge selects, it does not generate" 라고 한 줄로 적어 두었습니다.
Jev Search를 만든 곳은 TypeSafe가 아니라 웹 검색 API 업체인 Search1API입니다. 저장소는 이 회사의 GitHub 조직인 SuperAgents Lab에 있고, 개발사인 Search1API는 이 프로젝트가 독립 프로젝트이며 TypeSafe의 공식 제품이 아니라는 점을 명시하고 있습니다. 실제 검색은 Search1API의 상용 검색 API가 처리하므로 직접 배포하려면 이 회사의 API 키가 필요하고, 신규 계정에는 1회성 무료 크레딧 100건이 주어지며 기본 검색 한 건이 1크레딧을 씁니다. 애플리케이션 자체는 TanStack Start와 React로 작성되어 Cloudflare Workers 위에서 돌아가고, 개발사가 운영하는 공개 데모는 가입 없이 바로 쓸 수 있습니다. 브라우저에서 앱으로 설치하는 것도 되지만 오프라인에 저장되는 것은 안내 페이지 한 장뿐이라, 검색 자체는 네트워크가 있어야 동작합니다.
Jev Search와 모델이 문장을 만들어 주는 방식의 차이
Jev Search는 자신이 무엇을 하지 않는지로 스스로를 설명합니다. 화면 아래쪽 크레딧 줄에 "No generated answers" 라고 적어 둔 것이 그 선언입니다. 모델이 문장을 만들어 주는 방식과 견주면 다른 점은 다음과 같습니다:
항목 모델이 문장을 만들어 주는 방식 Jev Search 모델의 출력 문장 선택지 중 하나, 또는 0에서 1 사이의 확률 검색어를 정하는 주체 모델이 새로 작성 코드가 후보를 만들고 모델이 그중 하나를 선택 검색할 출처를 정하는 방법 모델의 판단을 문장으로 받아 해석 출처 12곳에 예/아니오 질문을 하나씩 화면에 남는 것 생성된 답변 링크와 요약, 결과마다 관련도 백분율오른쪽 열이 이렇게 된 것은 Jev Search가 고른 제품 전략이라기보다 모델의 제약에서 따라온 결과입니다. Jev가 문자열을 생성하지 못하니 검색어를 지어낼 수 없고, 그래서 규칙으로 후보를 만들어 고르게 하는 방법 외에 다른 선택지가 없습니다. 이 제약에서 두 가지가 따라옵니다. 검색어가 규칙으로 만들어지므로 같은 요청은 같은 후보 집합을 낳고, 화면에 남는 것이 링크라 사용자가 원문을 직접 엽니다. 잃는 것도 분명합니다. 여러 문서를 읽고 결론을 정리해 주는 일은 Jev Search가 하지 않습니다.
Jev Search를 사용하면 좋을 사용자
질문을 던진 뒤 그 결과가 왜 올라왔는지 확인하고 싶은 사람에게 Jev Search가 맞습니다. 어느 출처를 어떤 기간으로 뒤졌는지가 칩으로 드러나 있고 결과마다 관련도 숫자가 붙어 있어서, 검색이 빗나갔을 때 무엇을 바꿔야 하는지가 화면에서 읽힙니다. 반대로 여러 문서를 읽고 결론을 요약해 주는 도구를 찾고 있다면 Jev Search가 적절한 선택지가 아닙니다. 자체 호스팅을 검토하는 팀이라면 Search1API 키와 Jev 제공자 자격 증명이 둘 다 필요하고 검색 한 번이 여러 번의 유료 호출로 이어진다는 점을 먼저 계산해 봐야 합니다.
Jev Search가 요청을 해석하는 방식
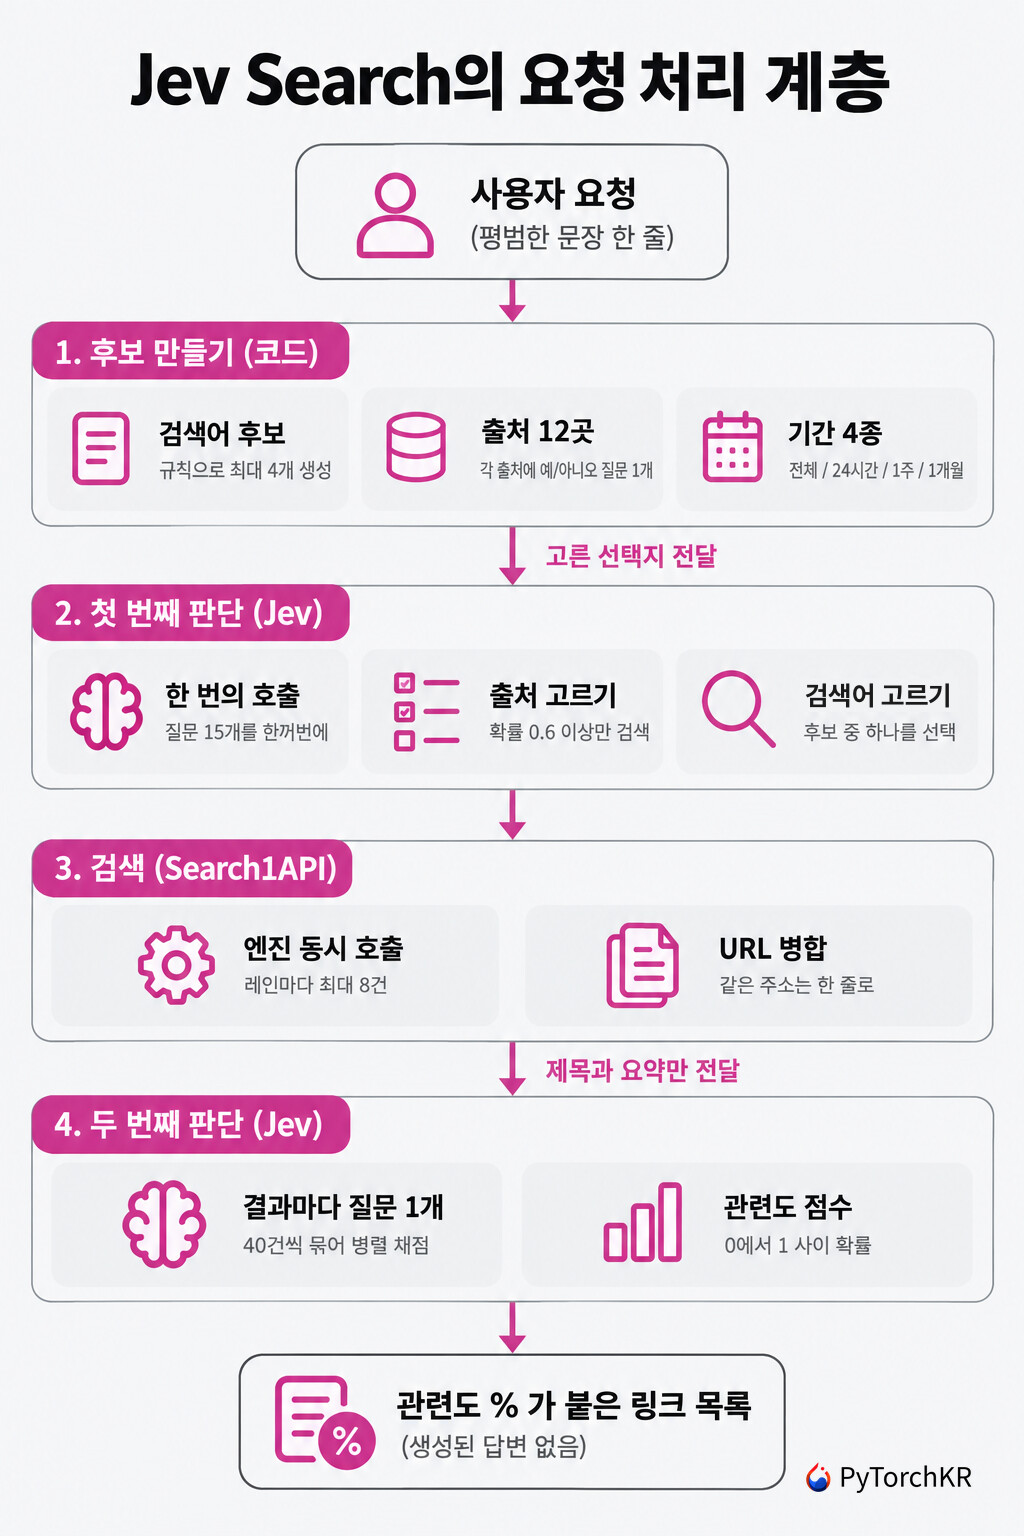
Jev Search는 사용자가 입력한 문장 하나를 받습니다. src/lib/validate.ts가 이 문장을 300자까지만 받아들이고, 그다음부터는 코드가 선택지를 만드는 단계입니다. src/lib/candidates.ts는 정규식으로 검색어 후보를 최대 4개까지 만듭니다. 첫 번째는 사용자가 입력한 문장 그대로이고, 두 번째는 시간 표현과 출처 표현을 제거한 것, 세 번째는 거기서 의문사와 조동사 같은 기능어까지 뺀 내용어만 남긴 것, 네 번째는 대문자로 시작하는 낱말과 숫자가 든 토큰만 모은 고유명사 후보입니다. 네 번째 후보는 IMDb처럼 문장이 아니라 작품 이름을 받아야 하는 카탈로그 엔진을 위한 것입니다.
후보가 준비되면 Jev를 한 번 호출하면서 질문 15개를 함께 보냅니다. 기간을 고르는 질문 1개(전체, 24시간, 1주, 1개월), 출처 12곳에 하나씩 붙는 예/아니오 질문 12개, 검색어 후보 중 하나를 고르는 질문 1개, 카탈로그 엔진용 이름 후보를 고르는 질문 1개입니다. 뒤의 두 질문은 후보가 둘 이상일 때만 실리므로, 고를 것이 없는 짧은 요청에서는 질문이 13개로 줄어듭니다. 출처 질문의 문구는 src/lib/sources.ts에 출처별로 박혀 있고, 질문만 있는 것이 아니라 예라고 볼 조건과 아니오라고 볼 조건이 함께 적혀 있습니다. GitHub 출처를 예로 들면 사용자가 코드를 찾고 있는지 묻고, 저장소, 릴리즈, 이슈, 오픈소스 도구를 찾는 요청이면 예, 코드가 아니라 토론이나 뉴스, 의견을 찾는 요청이면 아니오라고 판단 기준을 적어 둡니다.
돌아온 확률이 0.6 이상인 출처만 실제로 검색합니다. 12곳 모두 같은 기준을 적용받고, 어느 곳도 이 기준을 넘지 못했을 때만 기본값인 Google, DuckDuckGo, Yandex 세 곳으로 대신 검색합니다. Hacker News, Reddit, GitHub은 각각 두 갈래(lane)로 검색하는데, 한쪽은 Google을 해당 사이트로 제한해 검색하고 다른 한쪽은 그 플랫폼 전용 엔진을 씁니다. 두 갈래는 병렬로 돌아가고 나중에 합쳐지므로, 한쪽 엔진이 죽어도 다른 쪽 결과가 남습니다.
Jev의 판단은 사용자가 덮어쓸 수 있습니다. 화면 위쪽의 출처 칩과 기간 칩을 직접 바꾸면 src/lib/pipeline.ts가 모델이 고른 값 대신 사용자가 지정한 값을 씁니다. 여기까지가 첫 번째 판단이고, 결과가 돌아온 뒤에 두 번째 판단이 한 번 더 있습니다:
Jev Search의 관련도 점수와 결과 정렬
두 번째 판단은 채점입니다. 엔진이 돌려준 결과 하나하나에 대해 Jev에게 예/아니오 질문을 하나씩 던지는데, 질문의 내용은 이 결과가 사용자가 물은 주제에 관한 것인지입니다. 이때도 판단 기준이 함께 갑니다. 제목이나 요약이 같은 주제를 다루면 짧게 스쳐도 예, 같은 낱말을 공유할 뿐 다른 뜻이거나 동명이인이면 아니오입니다. 결과가 많으면 40건씩 묶어 여러 호출로 나누고, 묶음들은 병렬로 돌립니다. Cloudflare와 Vercel의 모델 목록에 적힌 Jev의 컨텍스트 창이 32,000 토큰이라, 한 호출에 넣을 수 있는 결과 수에는 상한이 있습니다. 모델에게 넘어가는 것은 각 결과의 출처, 제목, 요약뿐이고 본문은 가져가지 않습니다.
이렇게 돌아온 0에서 1 사이의 확률이 화면에 백분율로 표시됩니다. 기본 정렬인 Best match 의 규칙은 src/lib/rank.ts에 있는데, 관련도가 높은 순서가 1순위이고, 같으면 같은 URL을 돌려준 엔진이 많은 쪽이 앞이며, 그것도 같으면 엔진이 매긴 원래 순위를 따릅니다. 두 번째 기준이 있는 이유는 서로 다른 엔진이 같은 문서를 올렸다는 사실 자체를 신호로 쓰기 위해서입니다. 관련도가 0.3 미만인 결과는 목록에서 지우지 않고 접어 둔 뒤, 몇 건이 접혀 있는지를 적은 버튼 아래로 옮깁니다. 관련도 앞의 점 색깔은 0.7 이상이면 초록, 0.4 이상이면 주황, 그 아래면 회색입니다. 오른쪽 위의 Newest 로 바꾸면 최근에 발행된 순서가 앞에 오고 발행 시각을 모르는 결과가 맨 뒤로 갑니다. 이 전환은 이미 받아 둔 결과를 다시 늘어놓을 뿐이라 검색을 새로 돌리지 않습니다.
같은 내용이 여러 줄을 차지하지 않도록 병합도 두 겹으로 합니다. 먼저 URL을 정규화해서 utm_으로 시작하는 추적 파라미터와 fbclid, gclid 같은 값을 떼어내고 twitter.com은 x.com으로 맞춘 뒤 같은 주소를 한 줄로 합칩니다. 그러고 나서 제목에서 | Hacker News, : r/서브레딧 같은 꼬리표를 제거하고 앞쪽 여덟 낱말이 같으면 같은 이야기로 묶습니다.
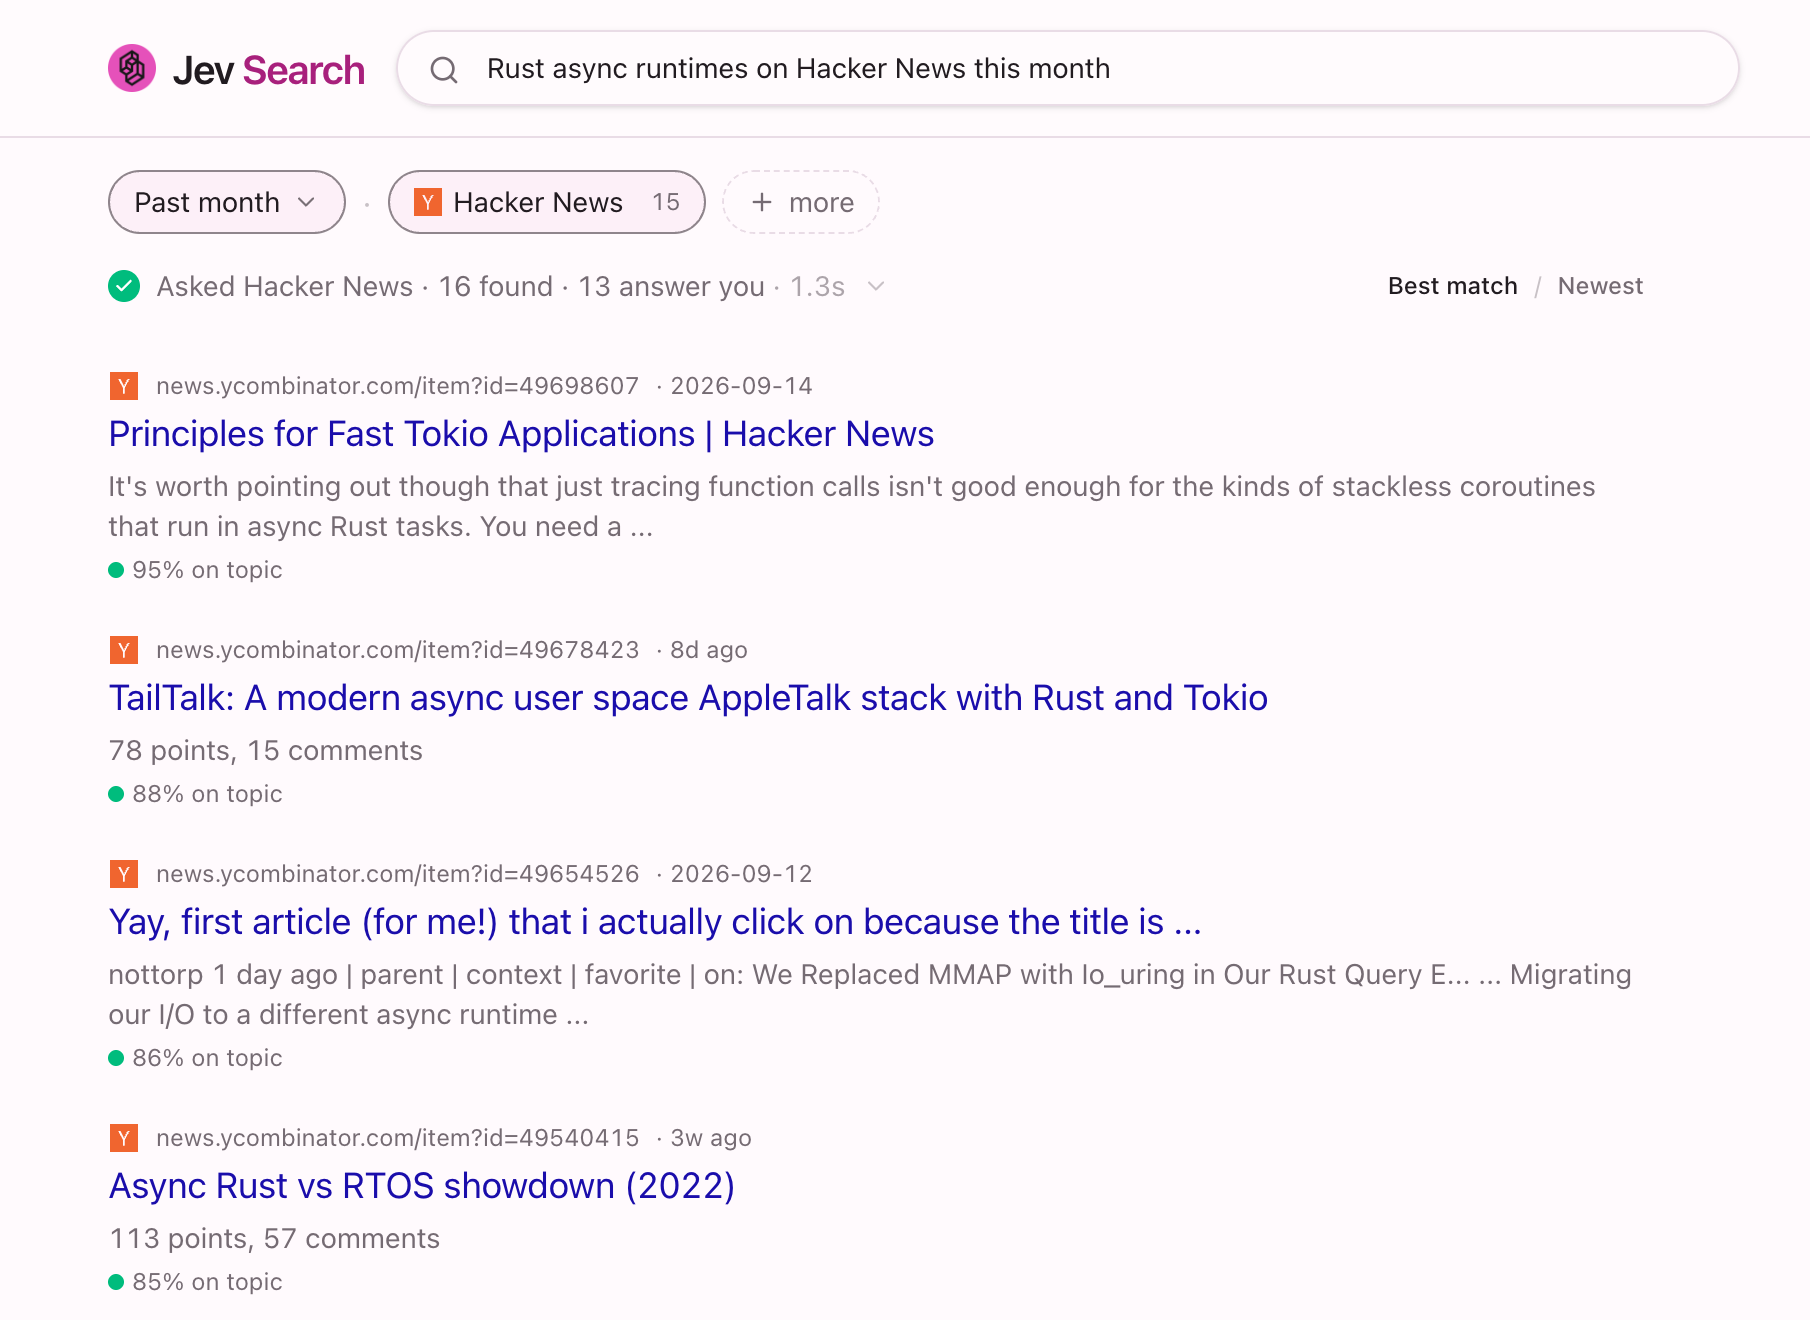
아래 화면은 Rust async runtimes on Hacker News this month 를 그대로 입력했을 때의 결과입니다. 위쪽 칩 두 개가 Jev가 고른 기간(Past month)과 출처(Hacker News)이고, 그 아래 줄의 16 found · 13 answer you는 엔진이 16건을 돌려줬고 그중 13건이 질문에 답한다고 채점됐다는 뜻이며, 각 결과 밑의 95% on topic이 관련도입니다:
이 숫자를 정확도로 읽으면 안 된다는 점은 Jev Search가 직접 적어 두었습니다. 관련도는 모델의 판단이지 검증된 정확도가 아니고, 검색 요약문은 틀렸거나 불완전하거나 낡았을 수 있으며, 기존 결과를 고르고 순위를 매기는 일이 그 결과의 주장을 검증해 주지는 않는다는 것이 한계 항목의 내용입니다.
Jev Search의 스트리밍 파이프라인과 장애 처리
Jev Search의 검색 엔드포인트는 src/routes/api/ask.ts의 POST /api/ask 하나이고, 응답은 줄 단위 JSON을 흘려보내는 방식입니다. 흐르는 이벤트는 네 종류로, 요청을 어떻게 해석했는지 알리는 intent, 엔진이 몇 건을 찾았는지 알리는 found, 채점이 끝난 결과 묶음을 보내는 lane, 끝났다고 알리는 done 순서입니다. intent 이벤트에는 어느 Jev 제공자가 답했는지도 judge 필드로 함께 실립니다. 마감 시간은 엔진 하나당 15초, 요청 전체가 30초입니다.
첫 응답을 앞당기려고 투기적 검색(speculative search)도 한 갈래 미리 던져 둡니다. Jev가 질문을 해석하는 동안 사용자가 입력한 문장을 그대로 Google에 던져 두고, 나중에 Jev가 마침 그 문장을 검색어로 고르고 기간 제한도 두지 않았다면 미리 받아 둔 결과를 그대로 씁니다. 조건이 어긋나면 그 결과는 버립니다. 성공한 응답은 Cloudflare KV에 캐시되는데, 보존 시간은 사용자가 원한 기간에 따라 다릅니다. 24시간 범위는 10분, 1주는 1시간, 1개월은 2시간, 기간 제한이 없으면 6시간입니다.
장애가 나는 경로마다 처리 방식이 정해져 있습니다. 엔진 한 갈래가 실패하면 결과 0건으로 세지 않고 경고를 띄우며, 다른 갈래의 결과는 그대로 남습니다. Jev 제공자는 체인으로 묶여 있어서 앞의 제공자가 실패하면 다음으로 넘어가는데, 넘어가는 조건은 크레딧이 없는 HTTP 402와 요청이 몰린 429, 그리고 5xx뿐입니다. 400이나 401 같은 클라이언트 오류는 재시도하지 않고, 요청이 취소된 뒤에도 재시도하지 않습니다. 공개 데모에는 IP당 분당 10회의 요청 제한(rate limit)이 걸려 있고, Jev Search는 이것이 Cloudflare 위치별로 적용되는 값이라 전역 지출 상한이 아니라는 점을 함께 적어 두었습니다. 출처나 기간 칩을 바꿔 다시 도는 검색도 같은 한도에 들어갑니다.
Jev Search가 다루는 검색 데이터
검색 도구를 고를 때 남는 질문은 입력한 문장이 어디까지 흘러가느냐입니다. Jev Search에서 검색 요청은 두 곳으로 갑니다. 엔진을 호출하는 Search1API, 그리고 요청을 해석하는 Jev 제공자입니다. 채점 단계에서는 결과의 제목과 요약도 Jev 제공자에게 넘어갑니다. Jev Search 자체는 검색 문구와 해석된 검색어, 결과 클릭을 자기 분석 데이터로 기록하지 않고, Cloudflare KV에는 질의에서 파생된 캐시 키와 결과 요약이 앞서 적은 보존 시간만큼 남습니다.
공개 데모에는 Cloudflare Web Analytics 스크립트가 하나 더 들어 있습니다. 쿠키를 쓰지 않고 URL 질의 문자열을 기록하지 않으므로 /search?q= 에 실린 검색어는 그쪽에 남지 않습니다. 다만 Workers 요청 로그는 별도로 켜져 있고, 이 로그의 요청 URL에는 검색어가 들어갈 수 있습니다. 요청 제한은 클라이언트 IP를 기준으로 셉니다. 자체 호스팅에서는 분석 스크립트를 지우고 캐시 바인딩을 떼어낼 수 있으며, 그렇게 하면 결과 캐시도 함께 꺼집니다.
Jev Search 설치와 사용
로컬 실행에는 Node.js 22.12 이상과 pnpm 10.8.0이 필요하고, Search1API 키와 Jev 제공자 자격 증명이 최소 하나 있어야 합니다. 저장소 이름과 Worker 이름은 프로젝트 이름과 달리 jev-search 이므로, 아래 명령에서는 그 이름을 그대로 씁니다:
git clone https://github.com/superagents-lab/jev-search.git
cd jev-search
corepack enable
pnpm install --frozen-lockfile
cp .dev.vars.example .dev.vars
# .dev.vars 에 SEARCH1API_API_KEY 와 Jev 제공자 키를 하나 이상 설정합니다.
pnpm dev
실행하면 http://localhost:3030 에서 열립니다. 테스트는 제공자를 모의로 대체하므로 API 키 없이도 돌릴 수 있고, 빌드 역시 어떤 제공자도 호출하지 않습니다.
Jev를 받아올 수 있는 경로는 세 가지이고, 하나만 있어도 동작하며 나머지는 장애 시 넘어갈 대비책입니다:
제공자 호출 경로 필요한 것typesafe
TypeSafe 자체 API, api.typesafe.ai/v1/systemone
TYPESAFE_API_KEY 시크릿
vercel
Vercel AI Gateway, 모델 typesafe-ai/jev
AI_GATEWAY_API_KEY 시크릿
cloudflare
Workers AI 바인딩 AI, 모델 typesafe/jev
키 없이 동작, Cloudflare AI Gateway 크레딧으로 과금
다만 세 경로의 조건이 같지는 않습니다. Vercel 무료 등급 팀은 모델별 요청 제한에 걸려 몇 번 만에 429를 받고, 키가 필요 없는 Cloudflare 경로도 AI Gateway 선불 크레딧이 없으면 바인딩이 실패합니다. Vercel은 모델 목록에 Jev의 입출력 토큰을 무료로 올려 두었고, 데이터 미보존(Zero Data Retention)과 프롬프트 데이터 미학습도 함께 표시하고 있습니다. 이 무료 표시가 2026년 9월 25일에 끝나는 프로모션 가격이라는 단서도 같은 자리에 달려 있으므로, 이 경로를 고르기 전에 현재 단가를 확인해야 합니다. 어느 제공자를 어떤 순서로 쓸지는 JEV_PROVIDERS 환경 변수가 정하고, 기본값은 typesafe 하나입니다. 목록에 없는 제공자는 자격 증명이 있어도 켜지지 않고, 목록에 있는데 자격 증명이 없으면 건너뜁니다. 배포는 Cloudflare Workers로 합니다:
pnpm exec wrangler secret put SEARCH1API_API_KEY
pnpm exec wrangler secret put TYPESAFE_API_KEY
pnpm cf-typegen
pnpm test
pnpm run deploy
직접 배포할 때 손봐야 하는 값이 몇 개 있습니다. wrangler.jsonc의 routes에서 jev.s1.dev를 지워 workers.dev 주소를 쓰거나 자기 도메인으로 바꾸고, src/lib/seo.ts와 public/robots.txt와 public/sitemap.xml의 origin을 같은 주소로 맞춥니다. 커밋되어 있는 KV 네임스페이스 ID와 요청 제한 네임스페이스 ID는 공개 데모의 것이므로 자기 계정에서 새로 만들어 교체하고, src/routes/__root.tsx에 들어 있는 Cloudflare Web Analytics 스니펫도 지우거나 자기 토큰으로 바꿉니다. 검색 한 번이 여러 번의 유료 제공자 호출을 일으키므로, 공개된 주소로 띄울 생각이라면 제공자 쪽에 지출 한도를 먼저 걸어 두는 편이 안전합니다.
Jev Search의 라이선스
Jev Search는 MIT 라이선스로 공개되어 있어 개인 및 상업적 목적으로 자유롭게 사용할 수 있습니다.
단, TypeSafe와 Jev라는 이름과 브랜드 자산은 각 권리자의 것이고 이 MIT 라이선스에 포함되지 않습니다. 파비콘과 Apple Touch Icon은 typesafe.ai의 아이콘을 그대로 가져온 것이고 public/ 의 설치형 웹 앱(PWA) 아이콘도 Apple Touch Icon의 크기를 줄인 것이므로, 자기 서비스로 배포하려면 이 아이콘들과 src/components/wordmark.tsx, public/manifest.webmanifest, 페이지 메타데이터를 자기 브랜드로 교체해야 합니다.
Jev Search 공개 데모 (개발사가 운영하는 호스팅 인스턴스)
Jev SearchJev Search — Picks where to search. Ranks what comes back.
TypeSafe's Jev reads your question, selects sources, time ranges and search terms, and ranks the results. No generated answers.
TypeSafe System One API 문서 (Jev Search가 호출하는 판단 API)
TypeSafe AIAPI reference - TypeSafe AI
Full HTTP API reference for the TypeSafe evaluation endpoint.
Jev Search 프로젝트 GitHub 저장소
github.comGitHub - superagents-lab/jev-search: Search the web with TypeSafe's Jev: source...
Search the web with TypeSafe's Jev: source selection, query understanding and relevance ranking. Built with Search1API.
더 읽어보기
-
Jev, 토큰 대신 확률적 결정을 내놓는 새로운 형태의 System One 모델 (feat. TypeSafe AI)
-
SURF, LLM을 위한 웹 검색/읽기 API (Search Utility & Reading Framework)
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
파이토치 한국 사용자 모임에서 이런 글들을 계속 정리하고 있습니다. 회원 가입으로 주요 글들을 이메일로, 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 새 글 알림을 받아보세요!
아래쪽에 좋아요를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
1개의 게시물 - 1명의 참여자