
Bend 2: 프로그램이 지켜야 할 규칙을 명시하고, 코딩 에이전트가 규칙을 위반하면 컴파일이 실패하는 언어 (feat. C 수준 속도 & GPU 실행)
Bend 2 소개
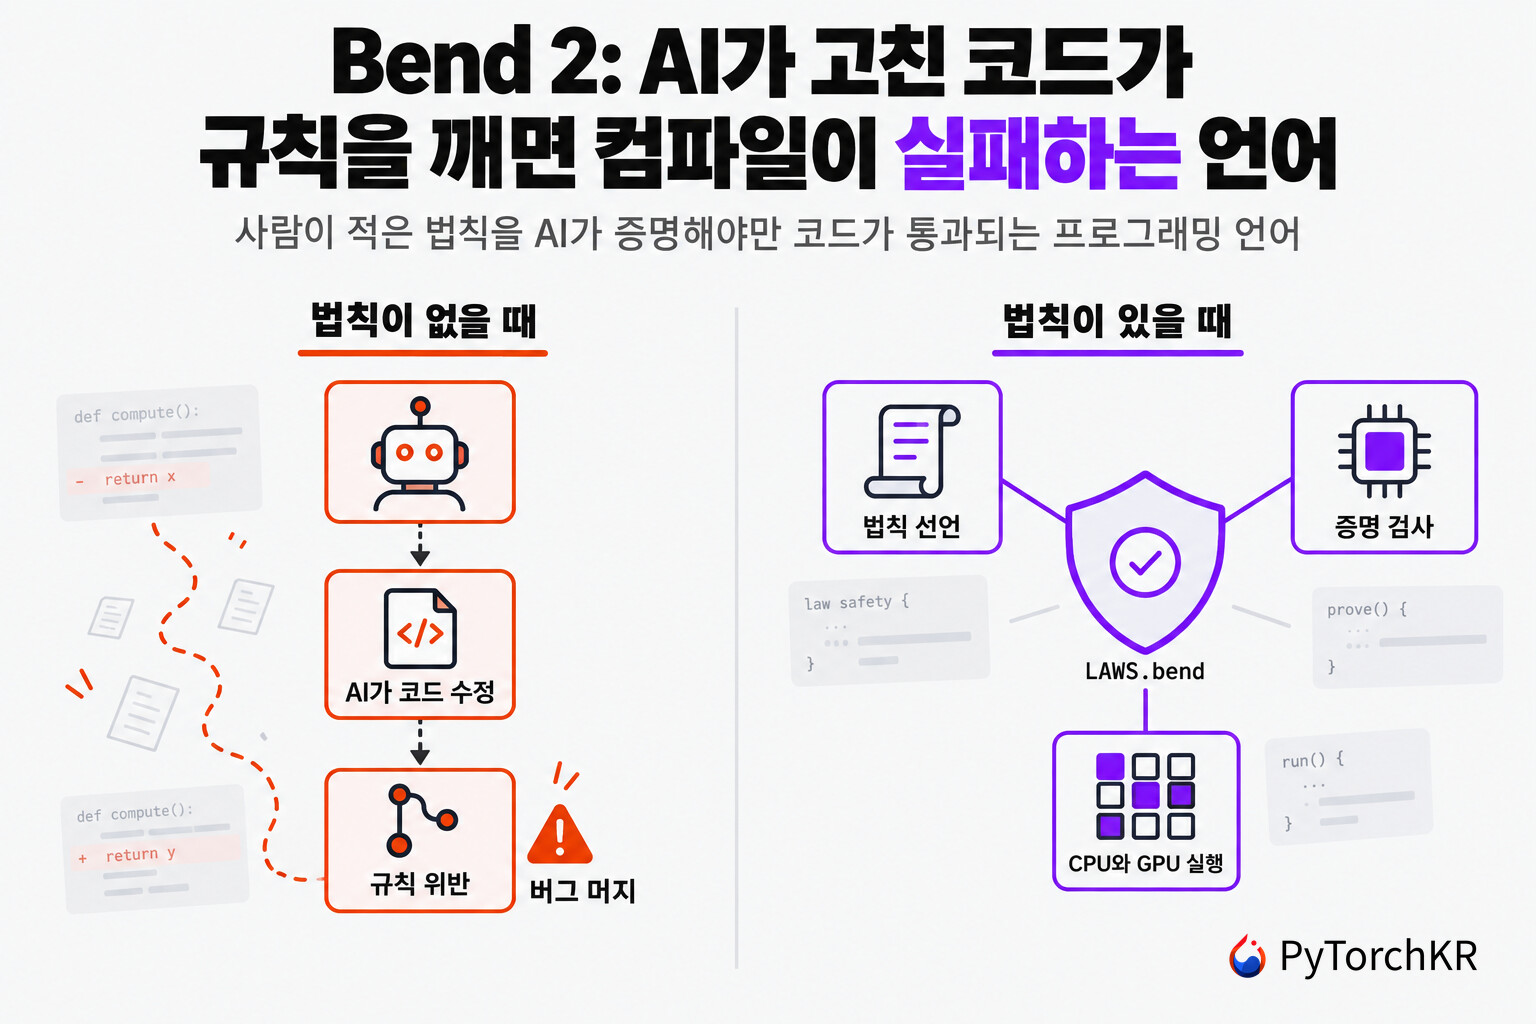
Bend 2는 프로그램이 지켜야 할 규칙을 사람이 LAWS.bend라는 파일에 적어 두면, 코드가 바뀔 때마다 컴파일러가 그 규칙의 수학적 증명(Proof) 을 요구하는 프로그래밍 언어입니다. 증명이 없으면 bend PROOF.bend 검증이 실패하므로, 이 명령을 커밋 게이트로 걸어 두면 규칙을 깨는 코드는 사람이 일일이 검토하지 않아도 걸러집니다. Bend 2는 2026년 9월에 GitHub 저장소를 통해 공개되었고, 라이선스는 Apache License 2.0입니다.
이 설계가 나온 배경에는 지난 2년간 코딩 도구가 놓인 자리 변화가 있습니다. 에이전트가 수백 줄짜리 변경을 몇 분 만에 만들어 내면서, 사람이 모든 diff를 읽는 전제가 무너졌습니다. 그 공백을 메우려고 등장한 것이 AGENTS.md 같은 지침 파일이고, PyTorchKR에도 AGENTS.md 표준을 소개한 글이 올라와 있습니다. 다만 이런 파일에 적히는 것은 결국 자연어 문장이라, 모델이 따르지 않았을 때 그것을 잡아내는 장치가 파일 자체에는 없습니다. Higher Order Company에서 Bend를 만든 Victor Taelin은 저장소 첫 문단에서 이 문제를 문제와 해법 두 줄로 제시합니다. 읽지 않은 AI 코드를 어떻게 신뢰할 것인가가 문제이고, AI에게 정확성 증명을 쓰도록 강제하는 것이 해법이라는 것입니다.
Bend는 여기에 두 번째 조건을 답니다. 증명 검사가 느리면 에이전트가 수정할 때마다 실행할 수 없으니 실제로는 쓰이지 않는다는 것입니다. 그래서 Bend는 정리 증명기의 검사 속도를 끌어올리는 쪽으로 타입 시스템을 설계했고, 같은 컴파일러가 만든 실행 파일이 CPU 한 코어에서 C에 가까운 속도로, 그리고 수정 없이 GPU에서도 실행되도록 런타임(Runtime)을 붙였습니다. 프로젝트가 스스로를 소개하는 네 마디가 C 수준 속도, CUDA 수준 병렬성, Lean 수준 증명, Python 문법입니다.
Bend라는 이름은 처음 나온 것이 아닙니다. 2024년 공개된 Bend 1은 같은 저자의 HVM2 위에서 상호작용 조합자(Interaction Combinators)로 평가를 수행하는 언어였습니다. Bend 2는 그 메커니즘을 완전히 제거했습니다. 저장소의 제약 목록 첫 줄이 "Bend 2는 새로운 언어입니다. Bend 1 프로그램과 HVM은 이어지지 않습니다" 이고, 런타임 논문도 관련 연구 절에서 목표는 유지하고 메커니즘은 버렸다고 명시합니다. 최적 공유(optimal sharing)를 포기하는 대신 네이티브 속도의 순차 코드, 평평한 메모리, 프로그래머가 읽을 수 있는 비용 모델을 얻었다는 설명입니다.
자연어 지침, 테스트, 법칙은 무엇이 다른가
Bend가 무엇을 새로 제공하는지 보려면, 코드가 규칙을 지키는지 확인하는 기존 수단들과 나란히 놓고 보는 편이 빠릅니다.
수단 검증 범위 확인 시점 우회 가능성AGENTS.md 같은 자연어 지침
검증 장치 없음
없음
모델이 따르지 않아도 아무 일도 일어나지 않음
단위 테스트
테스트에 적은 입력에 한정
CI 실행 시점
테스트를 수정하거나 지우면 통과
타입 시그니처
값의 모양(shape)
컴파일 시점
어려움, 다만 표현할 수 있는 성질이 제한적
LAWS.bend의 법칙
해당 타입의 모든 입력
컴파일 시점
증명을 제시하지 않으면 통과 불가
위 표에서 갈라지는 지점은 세 번째 열과 네 번째 열입니다. 테스트가 보장하는 것은 작성자가 떠올린 입력들에서 통과했다는 사실이고, 법칙이 보장하는 것은 그 타입의 값 전부에 대해 참이라는 사실입니다. Bend 데모 저장소의 설명이 이 차이를 짧게 정리합니다. "많이 테스트했다가 아니라, 모든 길이의 모든 입력 시퀀스에 대한 기계 검증된 정리입니다."
물론 법칙 자체를 사람이 잘못 적으면 보장은 그만큼만 유효합니다. 이 점은 뒤의 제약 절에서 다시 다루겠습니다.
LAWS.bend와 PROOF.bend: 사람이 쓰는 파일과 AI가 쓰는 파일
Bend 프로젝트는 저장소 루트에 파일 두 개를 두는 관례를 제시합니다. LAWS.bend는 코드를 import한 뒤 지켜야 할 성질을 선언만 합니다. 사람이 쓰고 AI는 건드리지 않습니다. PROOF.bend는 LAWS.bend를 import해 같은 이름의 정의로 각 법칙을 채웁니다(law sorted는 def Laws.sorted가 채웁니다). 이쪽은 AI가 코드와 함께 씁니다. 검증 명령은 bend PROOF.bend 하나이고, 법칙이 하나라도 비어 있거나 거짓이면 실패하며, 전부 채워졌을 때만 All terms check. 를 출력합니다.
데모의 README는 이 분업을 한 문장으로 요약합니다. "사람은 벽을 유지하고, 기계는 벽 반대편에서 거짓말하는 것만 빼고 무엇이든 합니다."
여기서 자연스럽게 나오는 반론이 있습니다. AI가 LAWS.bend를 지우거나 PROOF.bend에서 그 import를 빼 버리면 되지 않느냐는 것입니다. 가이드는 이 구멍 하나를 도구 차원에서 막아 둡니다. bend는 LAWS.bend 옆에 있으면서 그것을 import하지 않는 PROOF.bend를 거부합니다. 나머지는 관례의 영역입니다. LAWS.bend는 사람의 파일이고, 그 파일의 변경은 diff에서 몇 줄에 불과해 사람이 실제로 읽을 수 있는 분량이라는 점이 이 분업의 전제입니다.
저장소는 법칙으로 옮길 만한 규칙의 예시를 다음과 같이 듭니다. 도메인을 가리지 않고 "무엇이 절대 일어나면 안 되는가" 로 쓸 수 있는 것이면 법칙이 됩니다.
- 모든 잔고의 합은 0이어야 한다
- 플레이어는 단단한 벽을 통과할 수 없다
list_sort()는 언제나 오름차순 숫자를 반환해야 한다array_set()은 범위 밖으로 호출될 수 없다- 승리는 불가능하다
승리가 불가능하다는 것을 증명한 게임
공식 데모 app_win_is_bug_2d는 깃발을 밟으면 이기는 아주 작은 게임에, "승리는 불가능하다" 는 법칙 하나를 붙여 둔 것입니다. 출발 상태에서는 깃발이 좌상단 방 안에 있고 벽이 그 방을 막고 있어, 플레이어가 아무리 움직여도 벽에 부딪힐 뿐입니다.
여기에 새 기능을 요청합니다. "Claude, 보드가 가장자리에서 반대편으로 이어지게 해 줘." LAWS.bend가 없다면 AI는 요청대로 랩어라운드를 구현하고, 그 결과 플레이어가 가장자리를 돌아 깃발에 도달합니다. 규칙은 깨졌고 버그는 병합됩니다.
LAWS.bend가 있으면 같은 수정이 컴파일을 통과하지 못합니다. AI는 법칙이 다시 성립할 때까지 재시도해야 하고, 이 데모에서는 먼 쪽 가장자리에 벽을 세우는 것으로 해결했습니다. 보드가 토러스(torus)가 되었으므로 화면 반대편 가장자리가 곧 그 방의 나머지 두 벽입니다. 저장소에 실린 최종 지도는 다음과 같고, F가 깃발, P가 플레이어입니다.
...#.......#
.F.#.......#
...#.......#
####.......#
............
........P...
............
####........
깃발을 옮기든, 방을 즉사 지역으로 만들든 방법은 자유이고, 할 수 없는 것은 오직 버그를 커밋하는 일입니다.
법칙과 증명은 다음과 같은 모양입니다. for는 전칭 한정(for all)이고, 중괄호로 감싼 {a == b : T} 가 명제적 동등성입니다.
# LAWS.bend
law you_cant_win:
  for moves: List<Game.Move>                # any sequence of moves
  board = Game.replay(Game.start(), moves)  # replayed from the start
  {Game.is_won(board) == False{} : Bool}    # never leads to victory
# PROOF.bend
def Laws.you_cant_win(moves):
# ... written by the AI
그런데 이 데모의 LAWS.bend에는 법칙이 하나 더 있습니다. never_on_flag는 어떤 이동 시퀀스도 플레이어를 화면에 그려진 깃발 칸 위에 놓지 못한다는 것을 요구합니다. 왜 두 개가 필요한지는 첫 법칙만 두었을 때를 생각해 보면 됩니다. AI가 is_won을 언제나 거짓으로 만들어 버리는 것만으로도 you_cant_win은 통과하는데, 그러면 플레이어가 깃발 위에 서 있는데 승리 판정만 나지 않는 상태가 됩니다. 두 번째 법칙은 판정 함수가 아니라 페이지가 실제로 그리는 보드를 기준으로 삼아 그 구멍을 막습니다. 파일의 주석도 "두 법칙 모두 페이지가 보여 주는 것에 정확히 결부된다" 고 밝히고 있습니다. 앞서 정렬 예시에서 법칙 두 개가 한 쌍이어야 했던 것과 같은 구조입니다.
데모 README에 적힌 증명 전략도 읽어 볼 만합니다. "플레이어는 안전한 칸 위에 있다" 는 불변식(invariant)을 세우고, 시작 상태에서 성립하며 모든 이동을 견딘다는 것을 보이는 방식입니다. 지도의 기하학적 성질은 유한하므로 논증하지 않고 chk_all이 지도 전체를 열거해 검사기가 True로 계산해 버립니다. 공리도, ?TODO도, @unsafe도 쓰지 않은 증명이라고 밝히고 있습니다. 이 게임은 공식 홈페이지의 실험실 섹션에서 직접 해 볼 수 있고, 코드를 고쳐 법칙을 깨뜨려 보라는 안내도 함께 적혀 있습니다.
정렬 함수로 보는 법칙의 실제 모습
게임보다 실무에 가까운 예시는 proof_insertion_sort 데모입니다. 정렬 함수에 붙은 법칙이 두 개인데, 이 둘이 한 쌍이어야 하는 이유가 법칙 기반 명세의 핵심을 보여 줍니다.
# LAW: the output of sort is sorted: it ascends, starting at 0n
law sort_sorted:
  for +xs: List<&2, Nat>
  Sort.Sorted(Sort.sort(xs))

# LAW: sort permutes its input: every value x occurs in sort(xs) as
# often as it occurs in xs
law sort_perm:
  for +x  : Nat
  for +xs : List<&2, Nat>
  {Sort.count(x, Sort.sort(xs)) == Sort.count(x, xs) : Nat}
첫 번째 법칙만 있으면 언제나 빈 리스트를 반환하는 구현이 통과합니다. 빈 리스트는 정렬되어 있기 때문입니다. 두 번째 법칙이 값별 등장 횟수가 보존된다는 조건을 걸어 그 빠져나갈 구멍을 막습니다. 가이드는 이 방식을 법칙 주도 개발(Law-Driven Development) 이라 부르며, 자연어 프롬프트로 리스트를 정렬하는 함수를 구현해 달라고 말하는 대신 "모든 수 리스트에 대해 F(list)가 같은 수들을 오름차순으로 반환하는 함수 F를 구현하라" 처럼 정확한 법칙을 쓰게 하는 것이 목표라고 밝힙니다.
가이드에 실린 전망은 다음과 같습니다.
"법칙 주도 개발이 결국 사람이 AI를 써서 대규모 코드베이스를 작성하고 유지하는 방식이 될 것이라고 봅니다. 전부 수동으로 코딩하는 것(고되다)과, 한 줄도 감사하지 않고 프롬프트로 AI에게 전부 맡기는 것(오류와 모호함에 취약하고 안전하지 않다) 사이의 완벽한 중간 지점이기 때문입니다."
"We envision that law-driven development will eventually become the way humans use AI to write and maintain large codebases, as it is the perfect middle point between having to code everything manually (laborious) and letting AI do it all via prompts without auditing a line of code (error/ambiguity-prone, unsecure)."
법칙 주도 개발의 비용도 같은 데모들에서 숫자로 확인됩니다. 게임 데모는 게임 코드가 194줄인데 두 법칙을 증명하는 PROOF.bend가 484줄로, 증명이 코드의 2.5배 입니다. 법칙 선언 자체는 68줄입니다. 정렬 데모는 코드 92줄에 법칙 17줄, 증명 83줄로 비슷한 규모입니다. 그 484줄은 앞서 본 대로 @unsafe 나 목표를 열어 두는 ?TODO 같은 예외 장치 없이 채워진 것입니다. 예외 없는 보장에는 현재 이 정도 분량이 따라옵니다.
명세를 먼저 고정하고 구현을 뒤에 두는 흐름 자체는 Spec Kit으로 알아보는 명세 주도 개발(SDD)에서 다룬 적이 있습니다. 차이는 명세가 문서인가 타입인가입니다. Bend에서 명세는 컴파일러가 읽는 타입이고, 채워지지 않으면 빌드가 멈춥니다.
법칙과 증명 더 알아보기
Bend 공식 가이드 (GUIDE.md) - bend guide 명령으로도 같은 내용을 출력합니다
guide/GUIDE.md
main
# Bend

Bend is a new programming language that combines Lean-like formal proofs with
C-like speeds and CUDA-like parallelism. It gives humans an ambiguity-free
language to communicate their intents to AIs, a compiler capable of mechanically
checking that the AI implemented these intents to unquestionable mathematical
correctness, and a compiler that runs that code fast on CPUs and GPUs.

## Hello, World!

Bend's syntax is Python-shaped, but its semantics are closer to Haskell / Lean,
while being resource-aware like Rust (if less annoyingly). A hello world is just
a typed definition returning an IO block:

```python
import Base

def main() -> IO(Unit):
  do IO<Unit>:
    IO.print("Hello, world!")
Winning Is Impossible - 게임과 그 증명 전체가 담긴 데모
github.combend/demos/app_win_is_bug_2d at main · bendlang/bend
Bend 2: a fast language that blocks AI mistakes via proof. Install: curl -fsSL https://bend-lang.com/install.sh | sh - bendlang/bend
Bend 데모 모음 - 앱, 서버, 증명 예제마다 각자의 LAWS.bend를 포함하고 있습니다
bend/demos at main · bendlang/bend
Bend 2: a fast language that blocks AI mistakes via proof. Install: curl -fsSL https://bend-lang.com/install.sh | sh - bendlang/bend
Python 문법에 Lean의 의미론: 언어의 뼈대
Bend의 문법은 Python 모양이지만 의미론은 Haskell이나 Lean에 가깝고, 자원 관리 방식은 Rust를 닮았습니다. 순수 함수형 언어이며 부수 효과는 Haskell식 IO 모나드에 담깁니다.
import Base

type Shape is Data:
  Circle{r: U32}
  Square{s: U32}

def area(x: Shape) -> U32:
  match x:
    case Circle{+r}:
      (3 * r * r : U32)
    case Square{+s}:
      (s * s : U32)

def main() -> U32:
  area(Square{5})
여기서 낯선 부분은 is Data와 +r입니다. Bend는 기본적으로 아핀(Affine) 이어서, 변수는 많아야 한 번만 사용할 수 있습니다. is Data는 해당 타입의 값이 복사 가능하다고 선언하는 것이고, 변수 이름 앞의 +는 그 변수를 여러 번 써도 된다는 표시입니다. 이 표시는 타입의 종류(Kind)가 Data일 때만 붙을 수 있습니다.
Bend는 타입 추론(Type Inference) 을 거의 하지 않습니다. 타입을 결정하지 못하는 표현식은 {3 : U32}처럼 그 자리에서 주석을 달아야 합니다. 가이드는 이것이 의도된 교환이라고 설명합니다. 코드와 증명이 장황해지는 대신, 검사기가 다른 증명기보다 훨씬 빠르고 오류 메시지가 정확해진다는 것입니다.
수량과 종류: 값을 몇 번 쓸 수 있는가
변수마다 붙는 수량(Quantity) 은 그 변수를 몇 번 소비할 수 있는지를 정합니다. 세 가지뿐입니다.
-A소거(Erased): 타입과 증명에만 등장할 수 있고 컴파일러가 삭제합니다. 런타임에는 존재하지 않습니다.n아핀(Affine): 기본값입니다. 많아야 한 번 사용하며, 쓰지 않고 버리는 데에는 비용이 들지 않습니다.+x재사용 가능(Reusable): 여러 번 쓸 수 있지만 타입의 종류가Data여야 합니다.
import Base

# -A: erased (gone at runtime)
#  n: affine (used at most once)
# +x: reusable (requires A to be Data)
def replicate(-A: Data, n: Nat, +x: A) -> List<A>:
  match n:
    case 0n:
      Nil{}
    case 1n+p:
      x <> replicate(A, p, x)
제네릭 코드는 수량 자체를 소거된 파라미터로 받습니다(for -a: Quant). 이때 Kind(a) 는 Data 로 줄어들지 않으므로 + 가 거부되고, 복사 허가는 구체 타입으로 인스턴스화된 뒤에야 생깁니다.
함수, 배열, IO 핸들의 종류는 Type이므로 절대 복사할 수 없습니다. 클로저도 마찬가지여서 많아야 한 번 호출됩니다. 반면 최상위 정의는 자유롭게 몇 번이든 호출할 수 있습니다. 가이드의 설명대로 코드 자체에는 비용이 없기 때문입니다.
종료성 검사와 재귀
Bend는 반복 대신 재귀를 씁니다. 꼬리 호출은 루프로 컴파일됩니다. 다만 재귀 호출은 패턴 매칭으로 얻은 인자의 더 작은 부분을 써야 하고, 이를 어기면 컴파일이 실패합니다. 검사기는 재귀 호출의 인자를 왼쪽부터 읽어 하나가 줄어들 때까지 나머지는 그대로 넘겨졌는지 확인하므로, 줄어드는 인자를 앞쪽에 두는 것이 관례입니다.
종료성이 필수인 이유는 건전성입니다. 반환하지 않는 함수가 허용되면 그것으로 아무 명제나 증명할 수 있기 때문입니다. 같은 이유로 상호 재귀도 금지되어 있고, 서버 루프처럼 외부에 의해 끝나는 반복은 Nat 연료 인자를 감소시키는 형태로 씁니다. 탈출구로 @unsafe 표시가 있지만, 그 정의는 Bend의 증명 보장 밖으로 나갑니다.
if 문법은 아직 없어서 True{}와 False{}에 대한 match로 대신합니다. 계산된 값에 대한 match(match f(x):)도 거부되므로, 그 값을 파라미터로 받는 보조 함수를 따로 만들어야 합니다.
배열, 템플릿, 모나드
Array<T>는 소스 상으로는 인덱스 비트로 탐색하는 완전 이진 트리이고, 백엔드는 평평한 블록 하나로 실행합니다. Array<T>의 종류는 Type이라 항상 소유자가 하나뿐이고, 그래서 a[5] <- 42가 복사 없이 슬롯을 덮어쓰고 같은 배열을 돌려줍니다.
템플릿(Template) 은 인자를 구문(syntax)으로 받아 컴파일 시점에 인라인합니다. ~f로 표시한 파라미터는 런타임 비용이 없고, 클로저와 달리 원하는 만큼 호출할 수 있습니다. Base 라이브러리의 List.map이 이 방식으로 작성되어 있습니다. 클로저를 복사할 수 없는 언어에서 고차 함수를 쓰는 우회로인 셈입니다.
do 표기는 IO뿐 아니라 bind와 pure가 정의된 모든 모나드에서 동작합니다. Maybe, Result는 물론 직접 정의한 타입도 같은 문법으로 쓸 수 있습니다.
효과와 동시성: 이벤트 루프 하나, 위조할 수 없는 핸들
부수 효과는 IO 타입 안에 있고 do 블록으로 순서를 매깁니다. 동시성도 같은 블록 안에서 표현됩니다.
import Base

def greet(name: String) -> IO(String):
  do IO<String>:
    IO.sleep(1000)             # a step
    return "Hello, " ++ name   # return: wraps a pure value

def main() -> IO(Unit):
  do IO<Unit>:
    name : String <- IO.try(String, IO.get_env("USER")) # <-: binds a result
    chan : Chan(String) <- IO.fork(String, greet(name)) # runs concurrently
    IO.print("Waiting...")
    text : String <- IO.join(String, chan)
    IO.print(text)
BendRT 논문이 강조하는 것은 IO(A) 가 언어의 원시 요소가 아니라 Base 라이브러리의 정의 라는 점입니다. 생성자 둘(Emit, Halt)을 가진 데이터 타입 위의 연속(continuation)일 뿐입니다. 이벤트 루프는 스레드 하나에서 돌면서 main을 순수 기계로 평가해 요청 하나를 얻고, 그 효과의 C 핸들러를 실행한 뒤, 답을 연속에 적용해 다시 평가합니다. 그래서 효과는 평가기 안에서 실행되지 않고, 기계 자체는 어떤 IO도 수행하지 않습니다. 증명과 종료성 검사와 GPU가 호스트 코드에 닿을 경로가 구조적으로 없습니다.
프로그램은 이벤트 루프 하나가 번갈아 실행하는 계산들의 집합이고, 이 모양은 Node.js와 같습니다. 각 계산은 다음 효과를 만날 때까지 순수 코드를 모든 코어에서 병렬로 실행하고, 소켓이나 sleep이나 채널을 기다리게 되면 다른 계산에 자리를 내줍니다. IO.fork는 계산을 시작하고 결과가 도착할 채널을 돌려주며 IO.join이 그것을 기다립니다. 아래에는 IO.spawn, Chan.new, Chan.send, Chan.recv, Chan.close가 있습니다. 모든 계산이 끝나면 프로그램이 종료되고, 남은 계산이 전부 대기 상태이면 교착(deadlock)을 보고합니다.
핸들의 취급 방식도 아핀성의 결과입니다. File, Socket, Window는 아핀이면서 내부가 감춰진 값이라, 그 핸들에 대한 모든 효과가 결과와 함께 핸들을 되돌려 줍니다. 어떤 프로그램도 핸들을 위조하거나 재사용할 수 없습니다. 실패할 수 있는 연산은 errno를 담은 Result를 돌려주는데, 핸들은 그 Result 바깥으로 빠져나오므로 실패해도 핸들을 잃지 않습니다.
효과를 직접 추가할 수도 있습니다. Base의 모든 효과는 본문이 import "./x.c" 와 import "./x.js" 두 줄인 정의이고, 호스트 쪽에 같은 이름의 함수를 두면 자기 효과가 됩니다. 반대 방향으로 JavaScript 파일이 import Game from "./game.bend" 로 Bend의 비 IO 정의를 전부 불러 쓰는 것도 됩니다. 이때 값은 복사 없이 건너가므로, Array 인자는 호출한 쪽의 배열 그대로이고 제자리에서 갱신됩니다.
모듈과 해시로 식별되는 패키지
모듈은 파일 하나이고, import가 그 파일에 지역 이름을 붙입니다. 법칙 쪽에서 눈여겨볼 점은 한 파일에서 열어 둔 법칙을 다른 파일에서 def M.name(..) 으로 채울 수 있다는 것 입니다. 증명이 주장과 별도로 배포될 수 있다는 뜻이고, LAWS.bend와 PROOF.bend의 분업이 파일 경계에서 성립하는 근거이기도 합니다.
패키지는 내용 해시로 식별됩니다. import 0x<hash>/main.bend as P 는 허브에서 받아 온 뒤 해시와 대조해 검증하고, bend main.bend --publish 는 파일과 그것이 import하는 모든 것을 올린 다음 그 import 줄을 출력합니다. 다만 허브에는 아직 이름도 버전도 계정도 검색도 없어서, 실무에서 쓰기에는 이른 단계입니다.
Base 라이브러리와 순수 함수로 그리는 화면
Base는 작지만 이름 규칙이 일정해서 대부분을 추측할 수 있습니다. 모든 정의가 타입.동사 꼴이고, 같은 동사가 Nat, U32, F32에 반복됩니다. 산술은 add sub mul div mod, 비트 연산은 and or xor not shl shr(U32 전용), 비교는 cmp와 is_eq 계열, 문자열 변환은 show와 read입니다. 연산자는 이 정의들의 문법 설탕이고, bend base 가 전체를 출력합니다.
그래픽도 순수 함수입니다. 한 프레임이 Image 값이고, App이 상태를 이미지로 옮깁니다. Image는 쿼드트리(quadtree)여서 Pix{color} 는 정사각형을 칠하고 Qua{tl, tr, bl, br} 는 그것을 넷으로 나눕니다. 화면 하나가 다른 모든 것과 똑같이 재귀로 그려지고, 원하면 그 재귀가 병렬이 됩니다. App.run 이 창을 열어 프레임마다 view 와 tick 을 부르고 tick 이 None 을 돌려주면 끝납니다. 이벤트는 Key, Mouse, Move, Close 네 가지이고, 완성된 예제가 app_pong_game_2d 데모입니다.
증명은 전술이 아니라 def로 씁니다
Bend에는 전술(tactic)이 없습니다. 명제가 타입이고 증명은 그 타입을 가진 정의입니다. {==} 는 양변이 같은 항으로 계산될 때 동등성을 증명하고, match가 각 분기에서 목표를 좁히며, 재귀 호출이 귀납 가설이 됩니다. %e : P 는 e : {a == b : T} 로 목표를 다시 씁니다.
import Base

# LAW: "for every x, x plus 0 equals x"
law add_zero:
  for x: Nat
  {Nat.add(x, 0n) == x : Nat}

# PROOF: case analysis:
# - base case: reflexivity
# - step case: induction, rewrite, reflexivity
def add_zero(x):
  match x:
    case 0n:
      {==}
    case 1n+p:
      %add_zero(p) : {1n+Nat.add(p, 0n) == 1n+_ : Nat}
      {==}
BendTT 논문은 덧셈의 교환법칙 증명을 예시로 들며, 후속 분기에서 p와 b를 각각 두 번씩 쓴다는 점을 짚습니다. Nat의 종류가 Data이므로 +a와 +b가 이 재사용을 허가하고, + 표시가 붙은 대상을 매칭하면 필드도 +로 나옵니다. 아핀성만으로는 금지되는 관용구를 타입의 종류가 되살려 주는 자리입니다.
법칙 문법에는 전칭 한정인 for 말고도 두 가지가 더 있습니다. for y: B where P(y) 는 가설을 바인더에 얹어 y 를 (y, P(y) 증명) 쌍으로 만들고, exs y: T 는 증인(witness)을 요구해 증명이 (y, 증명) 을 돌려주게 합니다. "이런 값이 존재한다" 는 형태의 명세가 필요할 때 쓰는 자리입니다.
실패한 단계는 기대한 항과 관측된 항을 함께 출력합니다. ?name은 목표를 인쇄하고, ?TODO는 목표를 열어 둔 채로 남기며, 정의가 없는 법칙은 미증명 주장으로 취급됩니다.
Lean 생태계에서 증명 자동화를 다룬 글로는 PyTorchKR에 Claude가 11일 만에 페르마의 마지막 정리를 Lean으로 검증한 사례와 LLM 피드백 증류로 Lean 정리 증명을 학습시킨 연구가 있고, 신경망 자체를 Lean 4 안에서 검증하려는 TorchLean도 소개된 적이 있습니다. Bend가 그 계보와 다른 점은 증명을 수학 정리가 아니라 애플리케이션의 빌드 게이트에 두었다는 것입니다.
BendTT: 유니버스 계층 대신 아핀성으로 무모순성을 삽니다
BendTT 논문은 Bend 검사기가 구현하는 타입 이론을 5쪽으로 정리한 문서입니다. 두 편 모두 상단에 AI 공개 문구가 있는데, 언어와 이론은 사람이 설계했고 논문 원고는 Claude Fable 5.1이 저자의 코드와 설계 노트로부터 작성한 뒤 저자가 검토했다고 밝히고 있습니다.
핵심 주장은 이렇습니다. BendTT는 Type : Type 을 유지하고, 유니버스 계층이 없으며, 데이터 타입에 양성성 검사(positivity check)를 걸지 않습니다. 보통 이 셋 중 하나만 있어도 이론이 모순에 빠지는데, BendTT는 무모순이라고 주장합니다. 이를 떠받치는 것은 사용 규율(usage discipline) 하나입니다. 값은 타입의 종류가 허락하지 않는 한 많아야 한 번 소비됩니다.
역설이 죽는 지점
논문의 3절은 알려진 역설들이 어디서 걸리는지를 하나씩 보여 줍니다. 논지는 간단합니다. 고전적 역설의 엔진은 전부 함수를 복사한다는 것입니다.
- 자기 적용:
Ω = (λx. x x)(λx. x x)는 바인더를 두 번 씁니다. 사용량 측정값이ω로 포화되므로 평범한 바인더는 이를 거부합니다. 두 번 사용을 허락하는 바인더는+x뿐인데,+x는 종류가Data인 타입 위에서만 만들어집니다. 그리고 함수 타입은 결코Data가 아닙니다. - Girard 역설의 Hurkens 형태: Bend로 옮기면 정의 스무 개 분량이고, 함수 타입 변수가 두 번째로 사용되는 첫 지점인
tauinner까지 타입 검사를 통과한 뒤 거기서f (consumed more than once)오류로 실패합니다. 논문의 결론은 "비서술성(impredicativity)과Type : Type은 그 자체로는 해롭지 않다" 는 것입니다. - 음성 데이터 타입을 통한 Curry 역설: 양성성 검사가 없으므로 고차 추상 구문(Higher-Order Abstract Syntax, HOAS) 스타일의 항 타입 선언 자체는 합법입니다. 하지만 Curry의 엔진인
omega(Lam{f}) = f(Lam{f})는 필드f를 두 번 필요로 해 같은 카운터에서 죽습니다. 그 필드를Data선언 안에 넣으려 해도 함수 타입이Data가 될 수 없어 실패합니다.
복사 허가가 타입이 획득하는 속성이지 항이 들고 다니는 증거가 아니라는 점이 이 설계의 요점입니다. 복사 모달리티도, 복사 클래스도, clone 함수도 없습니다. 논문은 이것이 정량적 타입 이론(Quantitative Type Theory)을 뒤집은 것이라고 설명합니다. QTT에서는 ω가 평범한 바인더이고 무모순성은 유니버스 계층이 담당하는데, 여기서는 1이 평범한 바인더이고 ω가 타입이 벌어야 하는 허가입니다.
하강 규칙과 살아 있는 코드, 죽은 코드
재귀는 하강(Descent) 이라는 단일 검사를 통과해야 합니다. 정의의 본문을 걸으며 좌변을 재구성하고, 살아 있는 자기 참조 지점에서 남은 인자들을 왼쪽부터 컬럼과 비교합니다. 각 인자는 자기 컬럼과 같아야 하며, 하나가 엄밀한 부분항(strict subterm)이 되면 그 뒤는 자유입니다. 크기를 계산하지 않기 때문에 한 번의 패스로 끝나고, 논문은 이를 "감사자가 하루 오후에 읽을 수 있는 규칙" 으로 고른 이유라고 적습니다. 애커만 함수가 이 규칙을 통과합니다.
또 하나의 축은 살아 있는(live) 검사와 죽은(dead) 검사 의 분리입니다. 실행되는 코드는 live로, 타입과 소거된 인자와 등식은 dead로 검사합니다. dead 코드는 영원히 순환해도 되고 Empty를 증명해도 되지만, dead인 것이 live 증거로 승격되는 규칙은 존재하지 않습니다. 소거에는 비용이 없고, 명제는 demand 0에서 검사되므로 정리는 함수를 양화하고 변수를 마음껏 반복해도 됩니다. 논문의 문장으로는 "아핀성은 실행되는 것을 제약하지, 말해지는 것을 제약하지 않습니다."
형식화와 저자가 밝힌 한계
핵심 이론은 bend.lean에서 Lean 4로 형식화되어 있습니다. 약 2만 줄이고 sorry도 공리 선언도 없으며, 합류성(church_rosser_holds), 약한 축약에 대한 주체 축약(subject_reduction_holds), live demand에서의 진행성, 약한 정규화, 무모순성(consistency_holds)을 증명합니다.
다만 저자가 직접 적은 한계도 분명합니다. 형식화 모델이 실제 출시된 검사기와 아직 완전히 일치하지 않고, 파일이 bend.ts와 모델이 어긋나는 지점을 나열한 채 재동기화 중이라고 밝힙니다. 무모순성 결과는 구문적이며 Lean 자체의 기초에 상대적이고, 의미론적 모델은 없습니다. 변환(conversion) 절차, 따라서 검사기는 준결정 절차여서 멈추지 않으면 결론 없음(inconclusive)으로 처리되지 승인(accepted)으로 처리되지 않습니다. 그리고 정리들은 계산법(calculus)에 대한 것이지 코드에 대한 것이 아닙니다.
BendTT 더 알아보기
BendTT: An Affine Dependent Type Theory - Victor Taelin, Higher Order Company
github.comBendTT.pdf
bend.lean - Lean 4로 작성된 Bend 핵심 이론의 형식화
github.com/bendlang/bendbend2/bend.lean
main
-- NOTE: this file has two parts:
-- 1. the specification, which is what humans must read and audit
-- 2. the proofs, which were written by AI, and checked by Lean
-- Even though we've reviewed the spec carefully, it doesn't fully match the
-- implementation (bend.ts) yet. Bugs in the implementation COULD result in
-- inconsistencies. Independent audits are needed to increase our confidence on
-- bend.ts even further, and will be done over time.
--
-- ============================================================================
-- BEND-CORE — the bend2 calculus, as bend.ts implements it
-- ============================================================================
--
-- A model of the Bend core: the language (bend.ts's Types through Valid),
-- its reduction, typing, descent and validation, and the five claims the
-- bend.ts header trusts. PART I is the SPEC — the part a human must read.
-- PART II is the metatheory proving the claims.
--
-- THE HEADLINE. A dependent calculus with Type : Type, impredicativity and
-- negative recursive types, made consistent not by a universe hierarchy or a
-- positivity check but by a usage wall. Two checking demands, None (dead)
Lean 4 - 논문이 형식화 도구로 사용한 정리 증명기이자 프로그래밍 언어
github.comGitHub - leanprover/lean4: Lean 4 programming language and theorem prover
Lean 4 programming language and theorem prover
BendRT: GC도 워크 스틸링도 없는 런타임
BendRT 논문은 같은 아핀성이 언어를 빠르게 만든다는 주장을 펼칩니다. 컴파일러는 프로그램당 C 파일 하나를 내보내고, 그 파일이 CPU 프로그램이면서 동시에 GPU 커널입니다. clang이 CPU용으로 컴파일하고, Apple에서는 Metal이, NVIDIA에서는 CUDA가 같은 파일을 GPU용으로 컴파일합니다.
설계를 지탱하는 생각은 세 가지입니다.
소유권은 검사기에서 옵니다. 함수형 언어 런타임이 지불하는 비용 대부분은 값의 소유자가 누구인지 모르는 데서 나옵니다. 아핀성이 그 질문을 컴파일 시점에 끝냅니다. 값의 소유자는 그것을 소비하는 match이므로 해제는 컴파일된 코드가 되고, 가비지 컬렉터가 필요 없습니다. 공유는 컴파일러가 배치한 카운트 공유나 대여(borrow)가 있는 자리에만 존재합니다.
런타임이 값을 옮길 때 쓰는 연산은 셋뿐입니다. Take는 match 지점에서 값을 소비하며 필드를 읽고 노드를 해제합니다. Keep은 어떤 바인더의 두 번째 사용 지점에서 정확히 한 번 방출되어, 노드 주소와 카운트를 담은 리다이렉트 워드 하나를 만들고 지역 변수를 그 워드를 가리키게 바꿉니다. 카운트가 노드가 아니라 리다이렉트에 살기 때문에, 공유되지 않은 값은 어디에도 카운트를 지니지 않습니다. Drop은 소유권을 놓는 연산이자 이 런타임의 유일한 수집기인데, 해제되는 노드들을 따라가는 반복 순회여서 스스로는 메모리를 할당하지 않고 CPU든 GPU든 어느 쪽 코드에서도 실행됩니다. 추적(tracing)도, 에포크도, 깊은 복사도 없습니다.
어떤 타입이 카운트를 달지는 전역 분석이 정합니다. 공유 추론(share inference)은 어떤 바인더가 한 번 넘게 쓰이는 타입만 뜨겁다(hot)고 표시하고, 나머지는 평범한 저장과 적재로 만들고 소비합니다. 대여 추론(borrow inference)은 호출된 쪽이 읽기만 하는 인자를 찾아 원본 그대로 빌려 줍니다. 그래서 재사용되는 트리를 접는 코드에는 카운트 트래픽이 아예 생기지 않습니다. 참조 카운팅을 쓰는 Koka의 Perceus나 Lean과 갈라지는 지점이 여기라고 논문은 설명합니다. 카운트가 존재하는 자리 자체를 전역 분석이 좁혀 둔다는 것입니다.
평가기가 평평합니다. 모든 함수는 하나의 워크리스트 함수 안에 들어 있는 케이스 트리이고, 사용자 코드를 위한 C 콜 스택이 없습니다. 호출은 점프이고, 정의 하나가 평평한 상태 기계의 세그먼트 하나로 컴파일됩니다. 모든 호출 지점은 순차와 병렬 두 가지로 읽히므로 하나의 텍스트가 모든 실행기를 담당합니다.
태스크는 큐브 안에 놓입니다. 프론티어는 128 x 128 격자로 배치된 2^{14} 개의 링에 담깁니다. 성장(grow) 단계에서는 행을 따라 분기하고, 작업(work) 단계에서는 열을 따라 배출됩니다. 공유 큐도, 락도, 워크 스틸링도 없습니다. 큐브를 뒤집는 것은 인덱서를 교체하는 O(1) 연산이라 태스크가 실제로 이동하지 않습니다. 논문은 이 리듬을 벌크 동기 병렬(Bulk-Synchronous Parallel) 모델로 설명합니다. 지수적으로 분기하는 파동, 깊은 순차 집중, 그리고 다음 파동의 반복입니다.
항(term)은 64비트 워드 하나입니다. 태그, 16비트 보조값, 40비트 힙 위치로 구성되고, 머신 워드나 필드가 하나뿐인 생성자는 워드 안에 그대로 담겨 힙을 건드리지 않습니다. 호스트가 8TB를 예약하고 접근 시점에 페이지가 폴트로 들어옵니다.
GPU 쪽에는 별도의 규약이 있습니다. 힙 크기는 첫 디스패치 전에 한 번 정해지는데, Metal에서는 커널이 도는 중에 버퍼를 키울 수 없어 기본값이 2GB이고, CUDA에서는 관리 페이지가 필요할 때 들어오므로 카드 전체를 씁니다. 장치는 중단(abort)할 수 없으므로 실패도 규약으로 처리합니다. 가장 먼저 실패한 레인이 헤더 워드에 오류를 비교 교환(compare-and-swap)으로 써 넣고, 긴 루프마다 그 워드를 확인해 빠져나오며, 호스트가 디스패치가 끝난 뒤 그것을 읽어 한 줄을 출력하고 종료합니다. 그리고 CPU와 GPU는 동시에 계산하지 않습니다. ! 표시는 이벤트 루프가 순차 지점에서만 받아들이고, 그 밖의 자리에서는 표시가 강등되어 병렬 세계에서는 중첩 대신 태스크를 하나 생성하는 데 그치고, 순차 세계에서는 아무 효과가 없습니다.
병렬성 문법은 두 가지가 전부입니다
Bend에서 병렬성을 만드는 문법은 병렬 let과 ! 두 가지뿐입니다.
import Base

# Computes 2^d in parallel: a tree of d levels, one leaf per unit.
def pow2(+d: Nat) -> U32:
  match d:
    case 0n:
      1
    case 1n+p:
      a b = pow2(p) pow2(p)   # parallel call
      (a + b : U32)

# Runs pow2 on the GPU, via `!`.
def main() -> IO(Unit):
  result = pow2!(20n)
  IO.print(U32.show(result))
a b = f(x) g(y) 형태의 병렬 호출은 컴파일러에 두 가지를 약속합니다. 호출들이 서로 독립적이라는 것과, 대략 같은 시간 안에 끝난다는 것입니다. Bend가 순수하고 아핀이므로 첫 번째는 언제나 성립하지만, 두 번째는 프로그래머의 몫입니다. 한쪽이 먼저 끝나면 그만큼 가속이 나오지 않습니다.
아래 그림은 pow2(20) 이 태스크 하나가 각 코어에 하나씩 놓일 때까지 분기했다가 다시 합쳐지는 과정입니다. 4,096개 GPU 코어로 퍼집니다.
함수 이름 뒤의 !는 그 호출과 그 안의 모든 병렬 호출을 GPU로 넘깁니다. 힙이 완전히 통합되어 있어서, Apple M 시리즈처럼 통합 메모리를 가진 칩에서는 CPU에서 GPU로 데이터를 옮기는 것이 비용 0입니다. GPU가 없는 기계에서는 !가 CPU에서 병렬로 실행됩니다.
논문이 명시한 대가는 계약입니다. 워크 스틸링은 불균등한 분할을 런타임에 고쳐 주지만 큐브는 그러지 않습니다. 프로그램이 불균등하게 분기하면 작업 턴이 끝날 때까지 일부 레인이 대기하게 되고, 런타임은 그것을 교정하지 않습니다. 균형은 프로그램의 책임이라는 것입니다. GPU 프로그래밍의 추상화 계층을 다룬 논의로는 PyTorchKR의 CUDA Tile 소개 글도 함께 읽어 볼 만합니다.
Futhark나 Accelerate 같은 함수형 GPU 컴파일러는 배열 결합자를 커널로 평탄화하는 방식을 씁니다. Bend의 GPU 실행 단위는 그보다 넓어서, 재귀와 할당과 대수적 자료형을 포함한 언어 전체 가 장치 위에서 돌고 스케줄러도 장치에 있습니다. 그 대가가 더 어리고 덜 특화된 장치 코드이며, 아래 벤치마크 표의 손실 항목이 바로 그 대가라고 논문은 적습니다.
JavaScript 백엔드
같은 정의들이 평범한 JavaScript로도 출력됩니다. 살아 있는 정의 하나당 함수 하나, 생성자는 태그된 객체이고, 꼬리 호출은 트램펄린으로 처리하며 포크는 순차 실행됩니다. Node.js와 Bun에서 로더가 .bend 파일을 모듈로 만들어 주므로, Bend 프로그램이 곧 JavaScript 라이브러리가 됩니다. 네이티브 컴파일이 느린 편이라 빠른 개발에는 JavaScript 타깃을 쓰라고 가이드가 권합니다.
BendRT 더 알아보기
BendRT: A Parallel Runtime for CPUs and GPUs - Victor Taelin, Higher Order Company
github.comBendRT.pdf
base.bend - Bend의 Base 라이브러리, bend base 명령으로도 출력됩니다
bend2/base.bend
main
# Types
# =====

# Data
# ----

type Empty is Data:

type Unit is Data:
  Unit{}

type Bool is Data:
  False{}
  True{}

type Cmp is Data:
  LT{}
  EQ{}
  GT{}
HVM2: A Parallel Evaluator for Interaction Combinators - Bend 2가 대체한 이전 세대 런타임
github.comGitHub - HigherOrderCO/HVM2: HVM2 (2024): a massively parallel, optimal...
HVM2 (2024): a massively parallel, optimal functional runtime in Rust
벤치마크: 어디서 이기고 어디서 지는가
아래 수치는 모두 프로젝트가 직접 공개한 벤치마크이고, 측정 환경은 Apple M4 Max 한 대입니다. 낮을수록 좋습니다. 저장소의 bench 디렉터리에는 측정 스크립트뿐 아니라 차트의 막대 하나하나에 해당하는 원본 수치 파일 이 커밋에 고정된 채로 들어 있어서(bench/runtime/_pin_/apple_m4_max.txt), 그림을 눈으로 읽지 않고 텍스트로 대조할 수 있습니다. 아래 표는 2026년 9월 17일 커밋에 고정된 값입니다.
저장소가 이 수치를 어떻게 제시하는지도 함께 볼 필요가 있습니다. README는 "CPU에서는 C만큼, GPU에서는 CUDA만큼 빠를 것" 을 목표(Target) 로 적고 차트를 그 아래 현재 상태(Status) 로 배치합니다. 달성 선언이 아니라 현재 위치의 보고입니다.
벤치마크 TypeScript Lean C Bend 1코어 Bend 16코어 Bend GPU game of life 18.8s 13.8s 6.78s 7.80s 0.65s (12x) 0.06s (124x) n-body 5.33s 5.39s 5.13s 5.76s 0.52s (11x) 0.06s (98x) mandelbrot 3.84s 4.58s 3.75s 4.47s 0.40s (11x) 0.06s (78x) merkle tree 7.23s 5.99s 3.42s 4.22s 0.42s (10x) 0.07s (59x) ray tracer 23.0s 10.8s 3.65s 4.62s 0.40s (12x) 0.15s (31x) tree bitonic sort 33.9s 38.1s 5.72s 6.04s 0.80s (7.6x) 0.45s (13x) n-queens 6.98s 7.70s 3.60s 5.41s 0.46s (12x) 0.93s (5.8x) symbolic regression 5.92s 2.46s 2.21s 3.01s 0.27s (11x) 0.53s (5.7x) hashmap 0.89s 1.53s 0.62s 2.74s 0.24s (12x) 0.52s (5.3x) lexer 3.54s 4.49s 1.04s 2.14s 0.20s (11x) 1.07s (2.0x)위 표를 통해 3가지를 알아볼 수 있습니다. 첫째, 한 코어에서 Bend는 손으로 쓴 C와 같은 급에 있습니다. 논문은 고정된 12종 스위트에서, C로 직접 작성한 같은 프로그램이 걸리는 시간의 0.8배에서 1.5배 사이라고 보고합니다. 더 빠른 경우와 더 느린 경우가 함께 있습니다. 둘째, 16스레드에서 단일 코어 대비 7.6배에서 12.1배가 나옵니다(위 고정 수치로 계산한 값입니다. 논문의 8월 스냅샷에서는 하한이 8.8배였습니다). 스위트가 균등하게 분기하도록 작성되어 각 파동이 함께 끝나기 때문입니다. 셋째, GPU는 양극단입니다. 균일한 수치 연산(game of life, n-body, mandelbrot, merkle)에서는 크게 앞서고, 분기가 많거나 작업량이 치우친 경우(n-queens, symbolic regression)에는 16스레드보다 느립니다.
불리한 결과도 같은 차트에 함께 공개되어 있습니다. hashmap에서 Bend의 단일 코어는 2.74초로 C의 0.62초보다 4배 넘게 느리고, lexer에서도 GPU가 단일 코어 대비 2.0배에 그칩니다. 논문은 이를 두고 "설계상의 입장은 스케줄러를 그쪽으로 튜닝하기보다 손실을 보고하는 것" 이라고 적습니다.
이 범위가 어떤 스위트에서 나온 것인지도 함께 봐야 합니다. 방금 인용한 "C의 0.8배에서 1.5배" 는 논문의 12종 스위트에서 나온 범위인데, 그 스위트에는 hashmap, lexer, breadth-first search, edit distance가 들어 있지 않습니다. 고정 수치로 16종 전체를 계산하면 단일 코어의 C 대비 배수 상한이 1.5배가 아니라 4.41배(hashmap) 가 되고, 그다음이 2.07배(lexer)입니다. 해시맵과 문자열처럼 자료구조를 반복해서 갱신하고 훑는 작업에서 격차가 벌어집니다. "C 수준" 이라는 한 줄을 자기 워크로드에 그대로 적용하기 전에 어떤 종류의 작업인지부터 보는 편이 좋습니다.
수치를 인용할 때 주의할 점이 세 가지 있습니다.
첫째, 위 차트와 BendRT 논문의 Table 1은 서로 다른 시점의 측정 입니다. 논문은 2026년 8월 31일 커밋(64fc4b7)을 고정해 12종을 쟀고 차트는 9월 17일 커밋의 16종이라, 같은 벤치마크라도 숫자가 다릅니다.
둘째, 여기의 GPU 수치는 전부 Apple의 Metal로 잰 것 입니다. 논문은 한계 절에서 "CUDA 레인은 소스에 들어 있으나 여기서 측정하지 않았다" 고 명시합니다. NVIDIA GPU에서 어떤 성능이 나오는지는 아직 공개된 수치가 없습니다.
셋째, GPU 우위는 같은 Apple 칩 안에서도 등급에 크게 좌우됩니다. 저장소는 M4 Max 말고 기본 M4의 수치도 함께 고정해 두는데, 같은 16종에서 GPU가 병렬 CPU보다 빨랐던 항목이 M4 Max에서는 11종인 반면 기본 M4에서는 7종으로 줄어듭니다. 특히 lexer는 기본 M4에서 GPU가 3.891초로 단일 코어(2.323초)보다도 느리고, n-queens도 GPU 2.683초 대 병렬 CPU 0.762초로 3배 넘게 뒤집니다. 두 파일의 고정 시점이 9월 11일과 9월 17일로 달라 엄밀한 일대일 대조는 아니지만, 통합 GPU가 작아지면 ! 하나로 얻는 이득이 사라지는 구간이 넓어진다는 경향은 분명합니다. 도입을 검토한다면 자기 하드웨어에서 직접 재 보는 편이 안전합니다.
기본 M4 파일에는 실행기마다 반드시 같아야 하는 출력 체크섬 열이 함께 들어 있습니다. 논문이 "C 런타임의 정확성 근거는 체크섬 규율과 타입 시스템의 보장" 이라고 적은 것이 실제로 어떻게 운용되는지 이 열에서 확인할 수 있습니다.
증명 검사 쪽은 격차가 더 큽니다.
작업 Isabelle Agda Lean Rocq Bend 정의 12,800개 5분 초과 5분 초과 36.2s 5.99s 0.29s 제네릭 인스턴스화 3,200개 5분 초과 5분 초과 19.2s 6.04s 0.38s 증명 3,200개 5분 초과 5분 초과 5분 초과 9.53s 0.83s smalltt 트리 400개 8.47s 3.27s 1.33s 1.34s 0.61s검사기 수치는 2026년 9월 9일 커밋에 고정된 것인데, pin 파일에 Isabelle 열만은 9월 2일 측정값을 그대로 옮긴 것이고 이번에 다시 재지 않았다고 적혀 있습니다. 비교에서 가장 느린 열이 가장 오래된 값이라는 점은 감안하고 읽는 편이 좋습니다.
이 숫자가 중요한 이유는 사용 시나리오에 있습니다. 증명 검사가 수십 초에서 수 분 걸리면 에이전트가 한 줄 고칠 때마다 실행하는 것이 불가능합니다. 1초 안쪽이면 에이전트 루프 안에 들어갑니다. Bend가 타입 추론을 거의 하지 않고 모든 것을 명시적으로 표기하게 만든 대가가 여기서 회수되는 셈입니다. 다만 저자 본인이 "원하는 만큼 벤치마크가 많지 않고, 특히 검사기 쪽이 그렇다" 고 제약 목록에 적어 둔 점도 함께 봐야 합니다.
지금 쓸 수 있는가: 프로젝트가 공개한 제약 목록
Bend 저장소는 README 하단에 제약 조건을 30줄 넘게 나열하고 "BEND IS YOUNG. EXPECT BUGS AND REPORT THEM." 으로 끝맺습니다. 도입을 검토한다면 이 목록이 실질적으로 가장 중요한 부분입니다. 성격별로 묶으면 다음과 같습니다.
언어 표현력
- 타입 클래스, 트레이트가 없고, 컴파일 시점 템플릿을 넘어서는 매크로가 없습니다.
- 모든 것을 명시하고 아무것도 추론하지 않으므로 코드가 장황합니다.
- 값이 아핀이라 클로저와 배열을 공유할 수 없습니다.
- 재귀는 반드시 종료해야 하고 상호 재귀가 금지됩니다. 서로를 부르는 두 함수는 어느 쪽을 실행할지 고르는 인자를 가진 정의 하나로 합쳐야 합니다.
if-then-else문법이 없고, 계산된 값에 대한match도 지원되지 않습니다.
수치와 문자열
- 숫자는
Nat,U32,F32뿐입니다.U64,I64,F64가 없습니다(Metal에 f64가 없기 때문). F32는 공리적(axiomatic)이어서 부동소수점에 관해서는 아무것도 증명할 수 없습니다.- 문자열이 문자의 연결 리스트라 텍스트 처리가 느립니다.
생태계와 도구
- Base 라이브러리가 작아서 다른 언어가 기본 제공하는 헬퍼를 직접 써야 합니다.
- 효과가 print, env, time, sleep, spawn, 채널, 파일, TCP, UDP 정도이고 TLS, HTTP 라이브러리, JSON, 정규표현식이 없습니다.
- 에디터 지원, 테스트 프레임워크가 없고 디버거, 프로파일러, 포매터, REPL, LSP도 없습니다. 오류 메시지는 간결합니다.
- 패키지 허브에 이름, 버전, 계정, 검색이 아직 없습니다. 패키지는 해시로 식별됩니다.
- 컴파일 타깃은 C, Metal, CUDA, JavaScript이고 Lua, Luau, Python이 예정되어 있습니다. JavaScript 타깃은 한 코어에서만 돌고 그래픽과 오디오를 지원하지 않습니다.
- Windows를 지원하지 않습니다(WSL은 동작). 백엔드 개발에서 Linux와 macOS 조합이 가장 잘 맞습니다.
증명 보장의 경계
- 증명 탐색이나 전술이 없어 정리를 증명하려면 추가 노력이 듭니다. 공식 게임 데모 기준으로 코드 194줄에 증명 484줄입니다.
- 컴파일러(커널 제외)는 99%가 AI가 작성했고 아직 전면 감사되지 않았습니다.
- Lean 형식화와
bend.ts가 일치하지 않아 초기 무모순성 버그가 발생할 수 있습니다. - 병렬성은 균형 잡힌 호출을 전제하며, 그 계약은 검증되지 않습니다. 불균등한 프로그램은 조용히 병렬성을 잃습니다.
- C 런타임 자체는 검증되지 않았습니다. 논문은 정확성의 근거가 체크섬 규율과 타입 시스템의 보장이며, 동반 논문의 정리는 계산법 수준에서 멈춘다고 적습니다.
- 한 프로그램에 GPU 하나, 이벤트 루프 하나이고 다중 머신 실행은 아직 없습니다. CPU와 GPU가 동시에 계산하지도 않습니다.
- 링 하나에 태스크 1024개, 카운트는 2^{24}, 자연수는 2^{48}, 블록은 깊이 31에서 포화하며 각 오버플로는 번호가 붙은 즉시 정지이지 폴백이 아닙니다.
- 스레드 간 원자적 배열 공유는 실험적이고
@unsafe가 필요합니다.
마지막 묶음은 특히 신중하게 읽어야 합니다. Bend의 핵심 주장은 "법칙을 깨는 것이 수학적으로 불가능하다" 는 것인데, 그 보장은 검사기 구현이 이론을 정확히 따를 때 성립합니다. 프로젝트 스스로 형식화 모델과 실제 검사기가 어긋나 있다고 밝히고 있으므로, 현 시점에서는 이론상 불가능하다는 것과 이 구현에서 불가능하다는 것 사이에 아직 간격이 있습니다. 저자는 이 간격을 숨기지 않고 문서화했고, 대부분의 제약이 개선 중이라고 덧붙입니다.
한 가지 더 짚자면, 법칙 자체를 사람이 정확하게 쓰지 못하면 보장의 내용도 그만큼입니다. 앞의 정렬 예시에서 sort_sorted 하나만 적었다면 빈 리스트를 반환하는 구현이 합법적으로 통과했을 것입니다. 명세를 쓰는 능력이 코드를 읽는 능력을 대체하는 것이 아니라 다른 형태로 요구되는 것에 가깝습니다.
설치와 에이전트 연결
설치는 한 줄이고, 에이전트에게 Bend를 쓰라고 알려 주는 것은 AGENTS.md에 네 줄을 추가하는 것으로 끝납니다.
curl -fsSL https://bend-lang.com/install.sh | sh
When using Bend:
- run `bend guide` to learn it
- use `LAWS.bend` to keep important rules
- run `bend PROOF.bend` before committing
- parallelize the code whenever possible
명령 체계는 bend 하나로 통일되어 있습니다.
bend file.bend            # check; run main (IO compiled; a value normalized)
bend file.bend -o file    # compile to a native binary (clang 14+; 19+ with `!`)
bend file.bend -o file.c  # emit the C source instead
bend file.bend -o file.js # emit the JS source instead
bend page.html -o dist    # bundle a web page that imports .bend files
./file --threads 8        # run a native binary on 8 CPU threads
./file --gpu off          # run ! calls on the CPU (the GPU is on by default)
bend guide는 언어 전체 문서를 출력하고, bend base는 Base 라이브러리를, bend guide shaders는 AI가 AI를 위해 쓴 셰이더 작성 튜토리얼을 출력합니다. 마지막 문서는 순수 Bend로 120 FPS를 낸 demos/app_slash_boss_3d를 만들며 얻은 내용을 정리한 것으로, 그래픽이나 병렬 앱을 쓰기 전에 읽으라고 권합니다.
정리하며: 명세를 타입으로 옮기려는 시도
Bend 2가 던지는 질문은 AI가 쓴 코드를 어떻게 믿을 것인가이고, 답은 믿는 대신 증명을 받으라는 것입니다. 이 답 자체는 새롭지 않습니다. 형식 검증은 수십 년 된 분야이고 Idris 2, Agda, Lean 모두 같은 도구를 제공해 왔습니다. Bend가 바꾼 것은 사용 지점 입니다. 증명을 수학 정리를 검증하는 자리가 아니라 에이전트가 커밋하기 직전 단계에 배치하고, 그 자리에서 실행할 수 있도록 검사 속도를 1초 아래로 내렸습니다. 언어가 AI 오케스트레이션을 일급 개념으로 다루려는 시도는 Weft 같은 사례도 있었지만, Bend는 같은 문제에 타입 시스템 쪽에서 접근합니다.
그 대가로 포기한 것도 분명합니다. 표준적인 map은 타입이 맞지 않습니다. f가 원소마다 한 번씩 적용되므로 +가 필요한데 어떤 함수 타입도 Data가 아니기 때문입니다. BendTT 논문은 이를 "Haskell의 클로저 중심 스타일은 이식되지 않는다" 고 적고, 런타임이 어차피 같은 제약을 원하기 때문에 의도적으로 받아들였다고 밝힙니다. 고차 함수를 많이 쓰는 코드베이스는 그대로 이식하기 어렵습니다.
실무 관점에서 지금 당장의 쓸모는 제한적입니다. HTTP 라이브러리도 JSON도 없고, 에디터 지원과 디버거가 없으며, 컴파일러의 대부분이 감사되지 않은 AI 작성 코드입니다. 다만 Stripe가 주당 1,300개 PR을 무인 코딩 에이전트로 만드는 사례처럼 사람이 diff를 전부 읽지 않는 파이프라인이 늘어나는 상황에서, 사람이 무엇은 깨지면 안 되는지만 적고 나머지는 기계가 증명하는 분업 모델은 언어의 성숙도와 별개로 검토할 가치가 있습니다. 재무 불변식, 접근 제어, 자료구조 불변식처럼 위반 시 손실이 큰 성질부터 법칙으로 옮겨 보는 것이 현실적인 출발점일 것입니다.
Bend 공식 가이드
github.com/bendlang/bendguide/GUIDE.md
main
# Bend

Bend is a new programming language that combines Lean-like formal proofs with
C-like speeds and CUDA-like parallelism. It gives humans an ambiguity-free
language to communicate their intents to AIs, a compiler capable of mechanically
checking that the AI implemented these intents to unquestionable mathematical
correctness, and a compiler that runs that code fast on CPUs and GPUs.

## Hello, World!

Bend's syntax is Python-shaped, but its semantics are closer to Haskell / Lean,
while being resource-aware like Rust (if less annoyingly). A hello world is just
a typed definition returning an IO block:

```python
import Base

def main() -> IO(Unit):
  do IO<Unit>:
    IO.print("Hello, world!")
Bend GitHub 저장소
github.comGitHub - bendlang/bend: Bend 2: a fast language that blocks AI mistakes...
Bend 2: a fast language that blocks AI mistakes via proof. Install: curl -fsSL https://bend-lang.com/install.sh | sh
Bend 공식 홈페이지
bend-lang.comBend
Bend: a fast language that blocks AI mistakes via proof.
BendTT: An Affine Dependent Type Theory 논문
github.comBendTT.pdf
BendRT: A Parallel Runtime for CPUs and GPUs 논문
github.comBendRT.pdf
라이선스
Bend는 Apache License 2.0으로 배포되고 있어, 연구 목적은 물론 상업적 용도로도 자유롭게 사용 및 수정이 가능합니다.
커뮤니티 참여
Bend 팀에서는 함께할 개발자들의 참여를 기다리고 있습니다. 언어가 초기 단계인 만큼 버그 제보와 기능 요청을 적극적으로 받고 있습니다.
Discord 참여
DiscordJoin the Bend-Lang Discord Server!
Community Server for the HVM and related technologies. | 6676 members
더 읽어보기
-
페르마의 마지막 정리, Claude가 11일 만에 Lean으로 작성한 첫 컴퓨터 검증 증명 (≠ 새로운 증명 발견)
-
Feedback Distillation: LLM 피드백 증류로 Lean 정리 증명 학습하기 (feat. Meta FAIR)
-
[Deep Research] GitHub의 Spec Kit으로 알아보는 Spec-Driven Development(SDD)의 개념 및 활용 (feat. Vibe Coding)
-
CUDA Tile: NVIDIA가 제시하는 차세대 타일(Tile) 기반 GPU 프로그래밍 (feat. cuTile Python, Tile IR, TileGym)
-
Stripe의 무인 코딩 에이전트 Minions, 매주 1,300개 PR을 사람 코드 없이 만드는 방법 (feat. goose, MCP)
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
이 글은 파이토치 한국 사용자 모임이 직접 정리한 글입니다. 새 글을 놓치지 않으시려면 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 알림을 받으시고, 회원으로 가입하시면 주요 글들을 이메일로도 보내드립니다!
아래쪽에 좋아요를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
1개의 게시물 - 1명의 참여자