

GravityOCR 소개
GravityOCR은 문서 이미지를 텍스트, HTML 표, LaTeX 수식으로 옮기는 OCR 모델로, 하나의 가중치가 확산(Diffusion) 방식으로 여러 토큰의 초안을 한 번에 쓰고 같은 모델의 자기회귀(AR) 경로가 그 초안을 검증하는 방식으로 디코딩 속도를 높였습니다. 기반 모델인 GLM-OCR ( GLM-OCR: 0.9B 파라미터로 SOTA 성능을 달성한 초경량 오픈소스 OCR 모델 (feat. Z.ai))과 거의 같은 인식 정확도(OmniDocBench v1.6 Overall 95.16 vs. 95.48)를 유지하면서, 모델 forward 한 번에 평균 9.7개의 토큰을 확정합니다.
요즘 문서 OCR은 대부분 생성형 시각-언어 모델(Vision-Language Model, VLM)이 담당합니다. 문서 이미지를 입력하면 모델이 본문, 표, 수식을 하나의 토큰 시퀀스로 직렬화해 출력하는 방식이고, 공개 모델들의 정확도도 90%를 넘어 실무에서 믿고 쓸 수 있는 수준이 되었습니다. 그러나 이 모델들은 대부분 자기회귀(Autoregressive, AR) 방식으로 토큰을 하나씩 생성하므로, 출력이 N개의 토큰이면 순차적인 forward도 N번 필요합니다. 한 페이지에 수백~수천 개의 토큰을 출력하는 OCR에서는 이 순차 디코딩이 곧 서빙 비용입니다. 그래서 최근 OCR 모델들은 여러 토큰을 한 번에 예측하는 헤드를 붙이거나(GLM-OCR의 MTP), 별도의 초안 모델을 두거나(HunyuanOCR-1.5의 DFlash), 아예 확산 모델로 병렬 생성하는(DODO, MinerU-Diffusion) 방식으로 디코딩을 가속하고 있습니다.
이번에 소개하는 GravityOCR은 한국의 AI 연구 스타트업 Trillion Labs ( 한국 초지능 연구 스타트업 Trillion Labs, 한국어로 처음부터 학습한 Tri Series의 중간 체크포인트 공개)가 공개한 모델로, 앞의 방식들과 달리 초안 작성과 검증을 같은 파라미터가 모두 담당합니다. 초안 전용 네트워크나 보조 예측 헤드 없이, 마스크 토큰의 임베딩 한 줄만 추가해 GLM-OCR을 AR 디코딩과 블록 확산 디코딩이 모두 가능한 모델로 변환했습니다. 검증을 통과한 토큰만 확정하므로 출력은 이론상 같은 체크포인트의 AR 그리디(greedy) 디코딩 결과와 동일하고, 초안이 틀리면 출력이 나빠지는 대신 그 라운드에 확정되는 토큰 수만 줄어듭니다. 기술 보고서는 Trillion Labs의 Sungjun Han, Hyungguk Kim, Yusik Kim, Jamin Shin, Hongjoon Ahn(서울대학교 소속 겸)과 고려대학교의 Paul Hongsuck Seo가 함께 작성했고, 소개 블로그는 김형국 님이 작성했습니다.
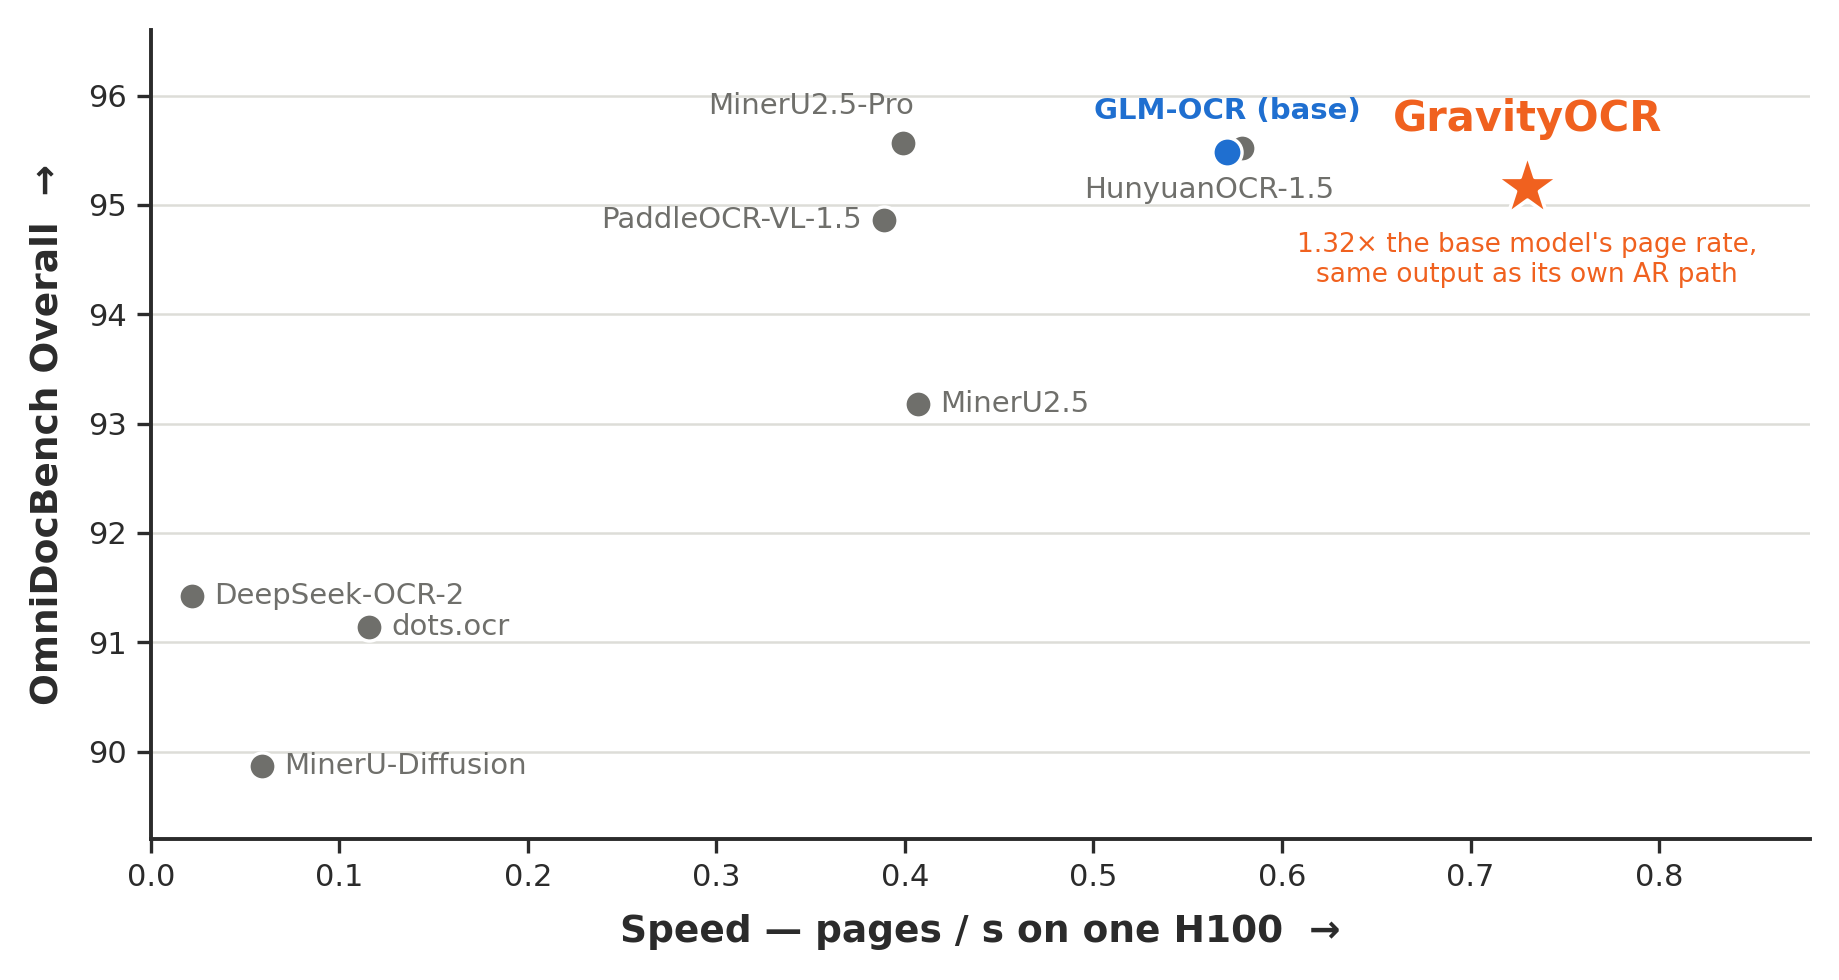
위 그림은 주요 문서 OCR 모델을 OmniDocBench Overall 점수(세로축)와 H100 GPU 한 장에서 단건 요청으로 처리한 초당 페이지 수(가로축)로 배치한 것입니다. GravityOCR은 95점대 정확도를 유지하는 모델 가운데 가장 오른쪽(초당 0.730페이지)에 위치하며, 같은 체크포인트의 AR 경로(초당 0.554페이지) 대비 1.32배 빠릅니다. 모델 가중치는 MIT 라이선스로 Hugging Face에, 서빙 패치와 추론(Inference) 코드는 GitHub에 공개되어 있습니다.
자기회귀 디코딩과 확산 언어 모델의 병렬 생성 방식 비교
이미지 확산 모델은 노이즈로 가득 찬 캔버스에서 시작해 여러 단계에 걸쳐 노이즈를 걷어내며 그림을 완성합니다. 이 아이디어를 언어 모델에 가져오는 방법은 크게 두 가지입니다. 토큰을 연속 벡터로 바꾼 뒤 그 위에 가우시안 노이즈를 더했다가 제거하는 잠재(연속) 확산(Latent Diffusion) 과, 노이즈 대신 마스크를 사용하는 이산 확산(Discrete Diffusion) 입니다. GravityOCR이 사용하는 것은 후자, 그중에서도 토큰을 마스크로 가렸다가 복원하는 마스크 이산 확산(Masked Discrete Diffusion)이며, LLaDA와 같은 확산 언어 모델(Diffusion Language Model, dLLM) 이 이 계열에 속합니다.
마스크 확산 모델의 디코딩은 빈칸이 뚫린 시험지를 채우는 과정으로 생각하면 됩니다. 모든 위치가 마스크인 상태에서 시작해, 매 단계마다 모델이 모든 빈칸의 답을 동시에 예측하고 그중 확신이 높은 칸부터 채웁니다. 채운 칸은 다음 단계의 문맥이 되고, 빈칸이 없어질 때까지 이를 반복합니다. AR 디코딩과 다른 점은 두 가지로, AR은 왼쪽에서 오른쪽으로 한 칸씩만 채우는 반면 확산 디코딩은 순서에 관계없이 여러 칸을 한 단계에 채울 수 있습니다. 따라서 적은 수의 forward로 전체 출력을 완성할 수 있습니다.
뒤에서 반복해 등장하는 두 가지 개념은 다음과 같습니다.
-
신뢰도 임계값(Confidence Threshold, \tau_c): 한 단계에서 어느 칸을 확정할지 고르는 규칙입니다. 모델이 예측한 확률이 임계값을 넘는 칸만 확정하고, 넘는 칸이 하나도 없으면 가장 확신이 큰 한 칸만 채웁니다. 임계값을 낮추면 한 번에 많이 채워 빨라지고, 높이면 조금씩 채워 안전해집니다.
-
블록 확산(Block Diffusion): 출력 전체를 한 번에 채우려 하면 멀리 떨어진 칸끼리 서로를 보지 못한 채 확정되기 쉽습니다. Block Diffusion 논문이 제안한 이 방식은 출력을 앞에서부터 일정 크기(B)의 블록으로 나누고, 한 번에 한 블록씩만 병렬로 채웁니다.
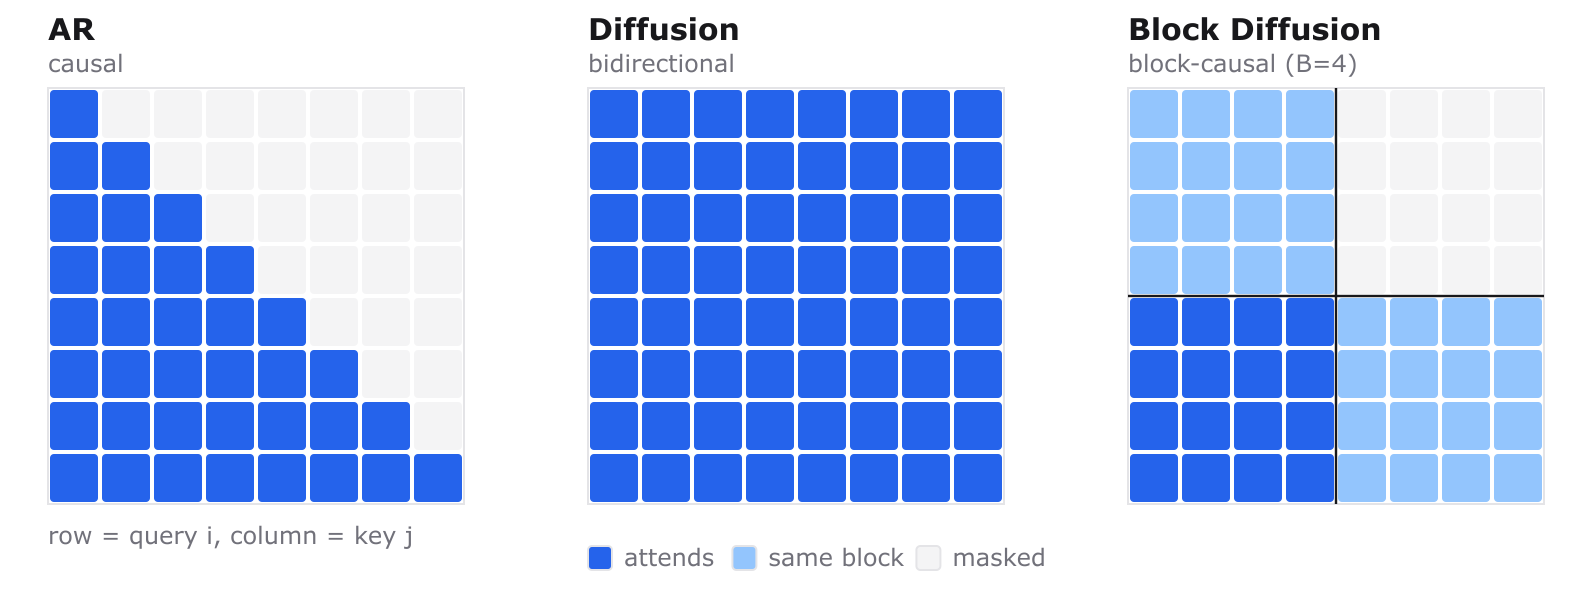
위 그림은 세 방식의 어텐션 마스크(Attention Mask) 를 토큰 8개, 블록 크기 4 기준으로 비교한 것입니다. AR은 자기보다 앞선 토큰만 볼 수 있어 행렬이 하삼각 모양이며, 한 칸씩밖에 채우지 못하지만 앞부분의 계산 결과(KV 캐시)를 그대로 재사용할 수 있습니다. 확산은 아직 채워지지 않은 자리끼리도 서로를 보므로 행렬 전체가 열려 있고, 병렬로 채울 수 있는 대신 한 칸이 채워질 때마다 나머지 칸이 보는 문맥이 바뀌어 이전 계산을 재활용하기 어렵습니다. 블록 확산은 그 중간으로, 블록 사이는 인과적(Causal) 이라 끝난 블록의 KV 캐시를 재사용하고 현재 블록 안에서만 양방향(Bidirectional) 어텐션으로 병렬 생성합니다.
확산 언어 모델 더 알아보기
확산 언어 모델(Diffusion LLM)의 개념과 동작에 대한 연구 정리: LLaDA에서 DiffusionGemma까지
확산 언어 모델(Diffusion LLM)의 개념과 동작에 대한 연구 정리: LLaDA에서 DiffusionGemma까지 읽을거리&정보공유[자기회귀 방식의 왼쪽에서 오른쪽 토큰 생성과 확산 언어 모델의 병렬 복원 방식을 비교한 다이어그램] 확산 언어 모델(Diffusion LLM)이란 무엇인가 우리가 글을 쓸 때는 대개 첫 단어부터 마지막 단어까지 한 방향으로 써 내려갑니다. 앞 문장을 다 쓰기 전에는 뒤 문장을 확정하기 어렵고, 한 번 뱉은 문장을 되돌아가 통째로 고치는 일도 드뭅니다. 오늘날의 주류 대형 언어 모델(Large Language Model, LLM)도 정확히 이 방식으로 동작합니다. 토큰을 왼쪽에서 오른쪽으로 하나씩 예측하는 자기회귀(Autoregressive, 이하 AR) 생성입니다. 확산 언어 모델(Diffusion Language Model, 이하 dLLM)은 이 순차 생성이라는 전제 자체를 바꾼 언어 모델입니다. 답변 자리를 통째로 마스킹(masking)해 둔 상태에서 출발해, 여러 번의 복원(denoising) 단계를 거치며 마스킹된 토큰들을 병렬로 채워 넣습니다. 이미지 생성에서 노이즈…

DiffusionGemma 기술 문서 리뷰: 자기회귀 Gemma 4를 이산 확산 모델로 변환한 초고속 텍스트 생성에 대한 연구
DiffusionGemma 기술 문서 리뷰: 자기회귀 Gemma 4를 이산 확산 모델로 변환한 초고속 텍스트 생성에 대한 연구 읽을거리&정보공유[DiffusionGemma 논문 리뷰: 자기회귀 생성은 토큰을 하나씩 채우고 텍스트 확산 생성은 256토큰 캔버스를 병렬로 정제한다] DiffusionGemma 소개 글을 쓸 때 우리는 첫 글자부터 마지막 글자까지 순서대로만 써 내려가지 않습니다. 전체 얼개를 흐릿하게 잡아 두고 앞뒤를 오가며 고쳐 쓰다 보면 어느 순간 문장이 제자리를 찾습니다. DiffusionGemma 기술 보고서 는 언어 모델의 생성 방식을 정확히 이렇게 바꾸려는 연구입니다. Google DeepMind는 자기회귀(autoregressive, AR) 방식으로 학습을 마친 Gemma 4 26B A4B 모델을 이산 확산(discrete diffusion) 모델로 미세조정하여, 토큰을 왼쪽에서 오른쪽으로 하나씩 뽑는 대신 256개 토큰 묶음을 병렬로 반복 정제하도록 만들었습니다. 그 결과 NVIDIA H100 한 장에서 초당 약 1,500토큰이라는, 기존 AR 모델로는 도달하기 어려웠던 생성 속도를 얻었습니다. …

Block Diffusion: Interpolating Between Autoregressive and Diffusion Language Models - Arriola et al.
github.comGitHub - kuleshov-group/bd3lms: [ICLR 2025 Oral] Block Diffusion: Interpolating...
[ICLR 2025 Oral] Block Diffusion: Interpolating Between Autoregressive and Diffusion Language Models
OCR의 병렬 생성 적합성과 병렬 확정의 실패 사례
여러 위치를 한 번에 채우는 방식은 일반적인 텍스트 생성에서는 잘 통하지 않는 경우가 많습니다. 다음에 올 말은 앞의 텍스트가 결정하므로, 앞 내용을 모르는 채로 여러 토큰을 동시에 확정하면 서로 맞지 않는 결과가 나오기 쉽습니다. OCR은 사정이 다릅니다. 출력해야 할 텍스트가 이미 입력 이미지에 적혀 있기 때문입니다. 예를 들어 계산서에서 "매출" 다음에 올 숫자는 앞 문맥이 아니라 이미지가 결정합니다. 실제로 GravityOCR의 확산 초안은 AR 디코더의 출력과 라운드당 평균 17.4개(블록 크기 32 기준)의 토큰이 연속으로 일치하는데, 이는 많은 토큰이 시각 정보만으로 결정된다는 것을 보여줍니다.
그러나 시각 정보가 있어도 토큰 사이의 의존성이 완전히 사라지지는 않습니다. 텍스트는 읽기 순서를 지켜야 하고, 표와 수식의 태그와 구분 기호는 구조적으로 맞아야 합니다. 같은 단계에서 예측되는 토큰들은 서로의 새 값을 조건으로 삼을 수 없으므로, 각각은 그럴듯하지만 합쳐 놓으면 어긋나는 출력이 만들어질 수 있습니다.
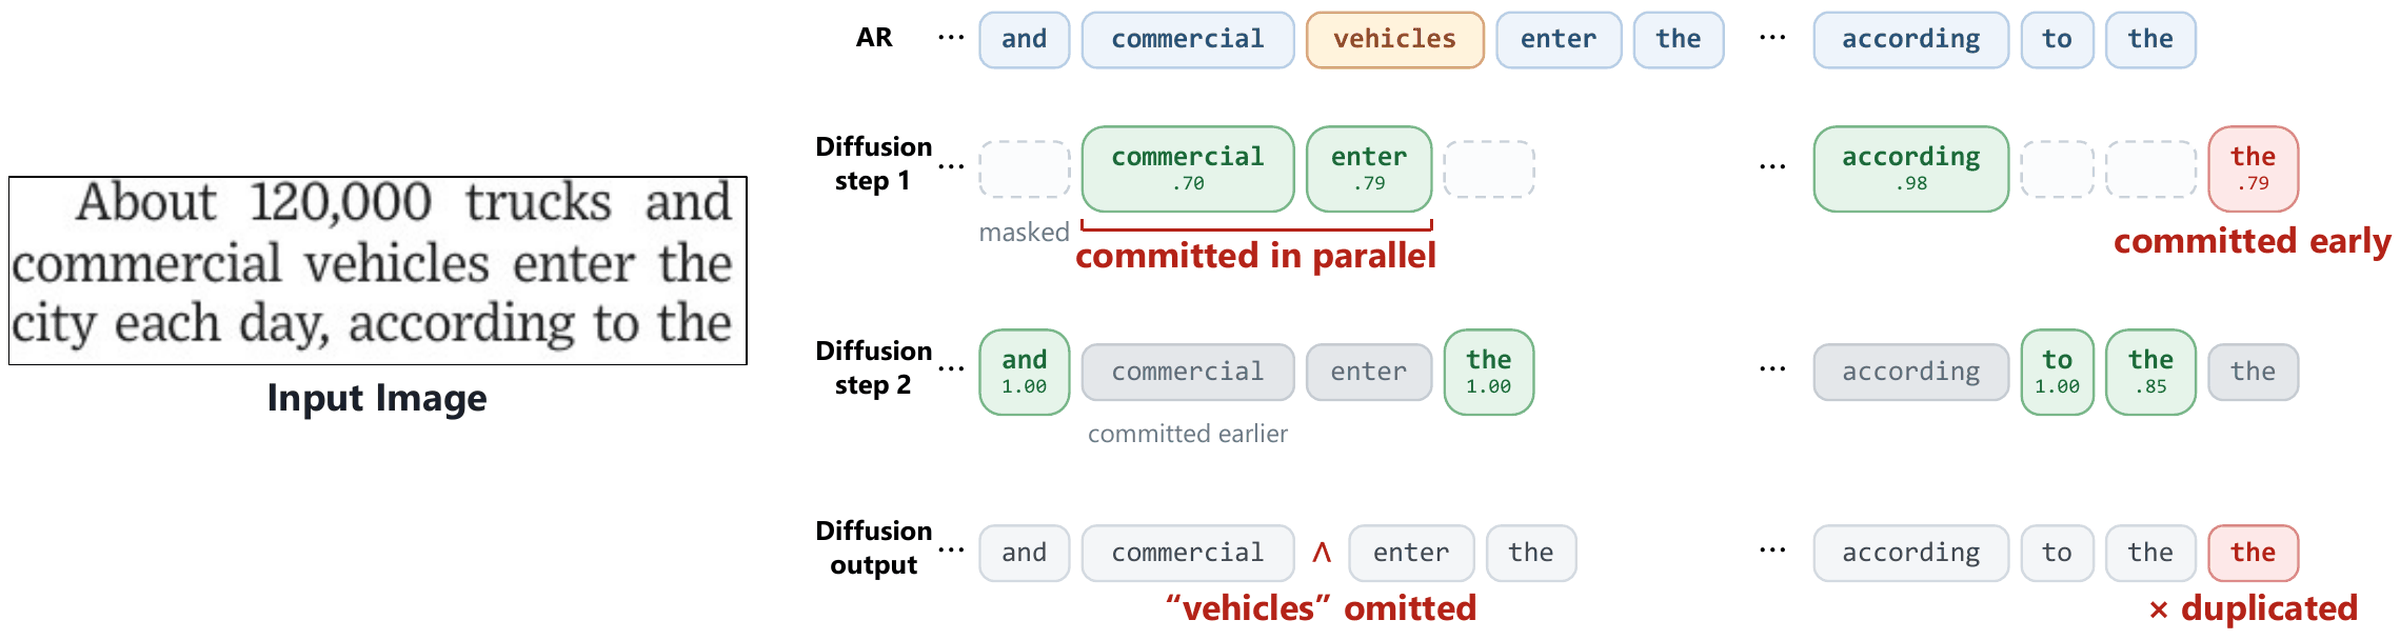
위 그림은 신뢰도 임계값 0.7로 병렬 확정했을 때의 실패 사례입니다. 한 문장을 디코딩하는 도중 "commercial"(신뢰도 0.70)과 "enter"(0.79)가 같은 단계에서 임계값을 넘어 함께 확정되었는데, 그 사이에 들어가야 할 "vehicles"의 자리가 사라졌습니다. 같은 단계에서 줄 끝의 "the"(0.79)도 확정되었고, 다음 단계에서 남은 문맥이 "…according to the"로 채워지면서 "to the the"라는 중복이 생겼습니다. 같은 가중치의 AR 디코더는 이 영역을 정확히 전사합니다.
이러한 오류가 쌓이면 벤치마크 점수로 드러납니다. GravityOCR 체크포인트를 검증 없이 블록 확산만으로 디코딩했을 때의 결과는 아래 표와 같습니다(최종 GRPO 체크포인트 기준).
디코딩 방식 신뢰도 임계값 \tau_c OmniDocBench Overall forward당 토큰 수(TPF) 블록 확산 (검증 없음) 0.7 86.06 15.43 블록 확산 (검증 없음) 0.9 91.54 11.72 블록 확산 (검증 없음) 0.95 92.53 9.97 블록 확산 (검증 없음) 0.99 93.57 7.28 자기 추측 디코딩 - 95.16 9.68검증 없는 블록 확산의 TPF는 토큰을 1개 이상 확정한 forward만 세고, 32토큰 블록이 끝날 때마다 KV 캐시를 기록하는 forward는 분모에서 뺍니다(MinerU-Diffusion의 셈법과 같습니다). 초안과 검증 forward를 모두 세는 자기 추측 디코딩보다 블록 확산 쪽에 유리한 셈법입니다. 블로그는 캐시 기록 forward까지 센 GRPO 이전 수치로, 임계값 0.7에서 forward당 9.59토큰(86.17점), 0.99에서 5.40토큰(93.23점)을 제시하며 같은 가중치의 자기 추측 디코딩(forward당 9.60토큰, 95.16점)과 비교했습니다.
위 표를 통해 검증 없는 블록 확산은 임계값으로 정확도와 병렬성을 맞바꾸는 구조라는 것을 알 수 있습니다. 비슷한 병렬성(forward당 약 10토큰)에서 비교하면 블록 확산은 92.53점, AR 검증을 붙인 자기 추측 디코딩은 95.16점으로, 같은 가중치와 같은 forward 예산이라면 그 일부를 검증에 쓰는 편이 정확도와 속도 모두에서 유리합니다. 확산 전용 OCR 모델인 MinerU-Diffusion과 비교해도 GravityOCR의 확산 모드는 모든 임계값에서 더 정확하지만, 같은 교환 관계를 보였습니다.
GravityOCR의 학습: 하나의 가중치에 AR 경로와 블록 확산 경로를 함께 학습
GravityOCR은 확산 경로를 제안(초안) 전용으로만 사용합니다. 이를 위해 먼저 GLM-OCR을 미세조정(Fine-tuning)해, 하나의 모델이 AR과 블록 확산 두 방식으로 모두 디코딩할 수 있도록 변환합니다. 두 모드는 비전 인코더, 언어 디코더, 언어 모델 출력층인 LM(Language Model) 헤드를 모두 공유하며, 아키텍처에 추가되는 것은 마스크 토큰 [M]의 학습 가능한 임베딩 하나뿐입니다. 이 임베딩은 기존 임베딩의 통계에 맞춘 정규분포에서 초기화합니다.
학습 단계에서는 하나의 정답 시퀀스로 세 개의 스트림을 만들어 한 번의 forward에 함께 넣습니다.
-
깨끗한 스트림(Clean Stream): 원본 정답 시퀀스에 토큰 단위 인과적 어텐션을 적용하고 일반적인 다음 토큰 예측 손실(AR loss)을 겁니다. 초안을 검증할 AR 경로의 능력을 유지하기 위한 것입니다.
-
손상된 스트림 2개(Corrupted Streams): 각 블록마다 마스킹 비율 t \sim \mathcal{U}(0,1) 을 샘플링해 토큰을 가린 스트림과, 정확히 그 반대 위치를 가린(비율 1-t) 스트림입니다. 두 스트림의 마스크가 상보적이므로 모든 응답 토큰이 정확히 한 번씩 확산 손실을 받습니다. 이 상보적 마스킹 방식은 Fast-dLLM v2를 따릅니다.

위 그림의 오른쪽 행렬은 각 스트림이 어느 위치를 볼 수 있는지를 나타냅니다. 파란 칸은 깨끗한 스트림 내부의 인과적 어텐션, 주황 칸은 손상된 블록 내부의 양방향 어텐션, 분홍 칸은 손상된 블록이 앞선 깨끗한 블록을 참조하는 부분입니다. 비어 있는 칸도 중요한데, 깨끗한 스트림은 손상된 스트림을 전혀 보지 않으므로 AR 경로가 마스크에 오염되지 않고, 손상된 블록은 같은 위치나 그 뒤의 깨끗한 블록을 보지 못하므로 정답이 그대로 새어 나가지 않습니다. 이미지와 프롬프트는 세 스트림 모두에서 마스킹하지 않습니다.
두 손실은 다음과 같이 합칩니다.
\mathcal{L} = \mathcal{L}_{\mathrm{AR}} + \lambda \mathcal{L}_{\mathrm{diff}}여기서 \mathcal{L}_{\mathrm{AR}} 은 깨끗한 스트림의 음의 로그 우도(Negative Log-Likelihood)이고, \mathcal{L}_{\mathrm{diff}} 는 두 손상 스트림에서 가려진 위치에만 거는 복원 손실입니다. 논문에서는 \lambda = 1 로 두고 전체를 1+\lambda 로 나눠, 두 목적 함수에 각각 0.5의 가중치를 줍니다.
학습 과정에서 눈에 띄는 설계가 하나 더 있습니다. 학습 시 모든 응답 뒤에 블록 크기(B=32)만큼의 EOS(End-of-Sequence) 토큰을 붙여, 모델이 마지막 블록을 EOS로 채우는 법을 배우게 합니다. 이때 AR 손실은 첫 번째 EOS에만 걸고 확산 손실은 모든 EOS에 겁니다. 논문에 따르면 이 제한이 없으면 AR 경로가 EOS를 과하게 예측해 Overall 점수가 4점 넘게 떨어졌습니다.
학습 데이터와 설정은 다음과 같습니다.
항목 설정 초기 가중치 GLM-OCR 공개 체크포인트 (비전 인코더와 언어 디코더 모두 학습) 학습 데이터 풀 영역(region) 단위 예시 1,230만 개, 주로 공개 데이터 (DocGenome, Docmatix, PubTables-1M, FinTabNet, SynthTabNet, PubTabNet, RVL-CDIP, DocLayNet, UniMER 학습 분할) 학습 세트 텍스트, 표, 수식을 60:20:20으로 맞춘 1,080만 개, 대부분 영어 정답(target) 대부분 기반 GLM-OCR의 전사 결과, 셀 주석이 있는 표 데이터(표 스트림의 약 39%)만 원본 주석 사용 하드웨어와 학습량 H100 16장(2노드), 40,000 스텝, 약 260억 forward 토큰 학습률 디코더 2\times10^{-5}, 비전 인코더 2\times10^{-6} 블록 크기 B=32정답 대부분은 기반 모델의 전사 결과입니다. 따라서 GravityOCR의 1차 학습은 새로운 인식 능력을 배우기보다, GLM-OCR의 출력을 AR과 확산 두 경로로 재현하도록 옮기는 과정에 가깝습니다. 저자들은 학습 데이터에 OmniDocBench 페이지가 포함되지 않았음을 문서 식별자, 텍스트 조각, 표 셀, 수식 문자열로 확인했다고 밝혔습니다.
GravityOCR의 추론: 확산 초안과 AR 검증을 반복하는 자기 추측 디코딩
추론은 두 번의 forward로 이루어진 라운드를 반복합니다. 이 구조는 작은 초안 모델이 여러 토큰을 제안하고 큰 모델이 한 번에 검증하는 추측 디코딩(Speculative Decoding)과 같은 원리인데, 초안 모델과 검증 모델이 같은 모델이라는 점에서 자기 추측 디코딩(Self-Speculative Decoding) 이라고 부릅니다.
-
초안(Draft): 마지막으로 확정된 토큰 x_0 뒤에 마스크 토큰 B 개를 붙여 forward를 한 번 수행합니다. x_0 위치는 인과적 어텐션으로 다음 AR 토큰 a_0 를 내고, 마스크 위치들은 확정된 앞부분과 블록 내부를 양방향으로 보며 초안 d_1, \dots, d_B 를 한꺼번에 냅니다. a_0 는 이미 AR 예측이므로 바로 확정합니다.
-
검증(Verify): [a_0, d_1, \dots, d_B] 를 인과적 어텐션으로 한 번 forward해 AR 예측 a_1, \dots, a_{B+1} 을 얻습니다. d_j = a_j 가 성립하는 가장 긴 앞부분 d_1, \dots, d_A 를 확정하고, 첫 불일치 위치에는 검증기의 토큰 a_{A+1} 을 대신 확정합니다. 따라서 한 라운드에 최소 2개(초안의 첫 토큰부터 틀린 경우), 최대 B+2 개(초안 전체가 수락된 경우)의 토큰을 확정합니다.

위 그림에서 a_1 = d_1, a_2 = d_2 는 수락되고, a_3 \neq d_3 에서 멈춰 검증기의 토큰 a_3 을 대신 확정합니다. 검증 forward가 수락된 앞부분의 KV 캐시를 함께 만들기 때문에 캐시를 채우기 위한 별도의 forward가 필요 없고, 거절된 토큰의 상태는 버립니다. 양방향으로 계산된 초안 쪽 상태는 캐시하지 않습니다. 초안 단계에서 여러 번 노이즈를 제거하며 초안을 다듬지 않고 forward 한 번으로 만든 초안을 곧바로 검증에 넘기는 것도 특징인데, 그 이유는 아래 실험 결과에서 다룹니다.
블로그에서는 블록 크기를 4로 줄인 예시를 애니메이션으로 보여줍니다.
위 예시에서 AR 디코딩이라면 forward 12번이 필요한 12개 토큰을 6번의 forward로 확정해, forward당 2.00토큰을 얻었습니다. 두 번째 라운드에서는 초안이 틀리지만 그 자리를 AR 검증기의 토큰이 대신하므로, 출력은 AR 디코딩과 같고 그 라운드에 확정되는 토큰 수만 줄어듭니다.
이 구조에서 확정되는 모든 토큰은 이미 확정된 앞부분이 주어졌을 때의 검증기(AR 경로) argmax 예측입니다. 따라서 정확한 산술(exact arithmetic)에서는 라운드를 거듭해도 같은 체크포인트의 AR 그리디 디코딩과 동일한 시퀀스가 나옵니다. 샘플링 디코딩에서도 추측 디코딩의 표준 수락-거절 규칙을 쓰면 AR 분포가 보존됩니다. 다만 실제 bf16 서빙 커널에서는 AR forward와 검증 forward가 서로 다른 어텐션 커널을 쓰기 때문에, 영어 OmniDocBench 영역 이미지 8,922개 중 96.6%에서 출력이 완전히 일치했습니다. 나머지 305건의 첫 불일치 위치를 fp32로 다시 계산해 보니 228건은 AR 쪽, 77건은 자기 추측 쪽 토큰과 일치했고, 상위 두 로짓의 차이 중앙값이 0.14 nats에 불과해 부동소수점 동률에 가까운 경우로 분석되었습니다.
논문은 속도 지표로 forward당 토큰 수(Tokens Per Forward, TPF) 를 사용하며, 초안 forward와 검증 forward를 모두 분모에 넣습니다.
\mathrm{TPF} = \frac{\text{확정된 출력 토큰 수}}{\text{forward 횟수}}AR 디코딩의 TPF는 정의상 1이고, GravityOCR은 라운드당 평균 17.4개의 초안 토큰이 수락되어 전체 TPF 9.7을 기록했습니다(이미지 인코딩과 프롬프트 사전 처리 forward는 제외).
추측 디코딩 더 알아보기
Fast Inference from Transformers via Speculative Decoding - Leviathan et al.
arXiv.orgFast Inference from Transformers via Speculative Decoding
Inference from large autoregressive models like Transformers is slow - decoding K tokens takes K serial runs of the model. In this work we introduce speculative decoding - an algorithm to sample from autoregressive models faster without any changes...
Orthrus: Dual-View 디퓨전 디코딩으로 LLM 추론을 가속하는 무손실 병렬 토큰 생성 프레임워크
Orthrus: Dual-View 디퓨전 디코딩으로 LLM 추론을 가속하는 무손실 병렬 토큰 생성 프레임워크 읽을거리&정보공유[Orthrus: 듀얼뷰 디퓨전 디코딩으로 LLM 추론을 가속하는 무손실 병렬 토큰 생성 프레임워크] Orthrus 소개 Orthrus는 자기회귀(Autoregressive) 대규모 언어 모델(LLM)의 정확한 생성 충실도와 디퓨전 모델(Diffusion Model)의 빠른 병렬 토큰 생성 능력을 한 모델 안에서 결합하기 위해 설계된 듀얼 뷰(Dual-View) 디퓨전 디코딩 프레임워크입니다. 기존 자기회귀 디코딩은 한 번의 forward pass 당 한 토큰만 생성하는 직렬적 병목을 가지고 있어 GPU 자원이 충분해도 처리량(throughput)을 끌어올리기 어려웠고, 반대로 디퓨전 언어 모델(dLLM)은 병렬 디코딩이 가능했지만 복잡한 추론(reasoning) 과제에서 조건부 드리프트(conditional drift)와 정확도 저하를 겪었습니다. Orthrus는 이 두 흐름을 화해시켜, strictly lossless 한 토큰 분포를 유지하면서도 최대 7.8배의 추론 가속을 …

TorchSpec: 추측 디코딩 초안 모델을 대규모로 학습하는 파이토치 네이티브 프레임워크
TorchSpec: 추측 디코딩 초안 모델을 대규모로 학습하는 파이토치 네이티브 프레임워크 읽을거리&정보공유[TorchSpec: 추측 디코딩 초안 모델을 대규모로 학습하는 파이토치 네이티브 프레임워크] TorchSpec 소개 TorchSpec은 추측 디코딩(speculative decoding)을 위한 초안 모델(draft model)을 학습하는 파이토치 네이티브 프레임워크입니다. 추측 디코딩은 작은 초안 모델이 여러 토큰을 미리 제안하고, 큰 대상(target) 모델이 이를 한 번의 순전파로 검증하는 방식으로 대규모 언어 모델의 생성 속도를 끌어올리는 기법입니다. 제안한 토큰이 받아들여지면 한 스텝에 여러 토큰을 확정할 수 있어 처리량과 지연 시간이 함께 개선됩니다. 잘 학습된 초안 모델일수록 이 효과가 안정적으로 나오기 때문에, 초안 모델을 어떻게 학습하느냐가 추측 디코딩의 실효성을 좌우합니다. 초안 모델 학습의 핵심은 대상 모델의 중간 은닉 상태(hidden states)를 초안 모델로 전달하는 데 있습니다. 그런데 프론티어 모델의 규모가 커지면서 이 은닉 상태를 옮기는 일 자…

OCR 디코딩 가속 방식 비교: 별도 초안 모델, MTP, 자기 추측 디코딩
OCR 디코딩을 빠르게 하는 방식들은 여러 토큰을 한 번에 제안한다는 점은 같지만, 누가 제안하고 누가 확정하는지가 다릅니다.
방식 대표 사례 초안 작성 주체 검증 추가 파라미터 별도 초안 모델 + 검증기 HunyuanOCR-1.5 + DFlash () 별도 모델 본 모델 파라미터 9,070만 개(90.7M) 규모의 초안 모델 다중 토큰 예측(Multi-Token Prediction, MTP) GLM-OCR () 본 모델에 붙인 예측 헤드 없음(그대로 확정) 또는 메인 LM 헤드 MTP 헤드 자기 추측 디코딩 GravityOCR 본 모델의 확산 경로 본 모델의 AR 경로 마스크 토큰 임베딩 1개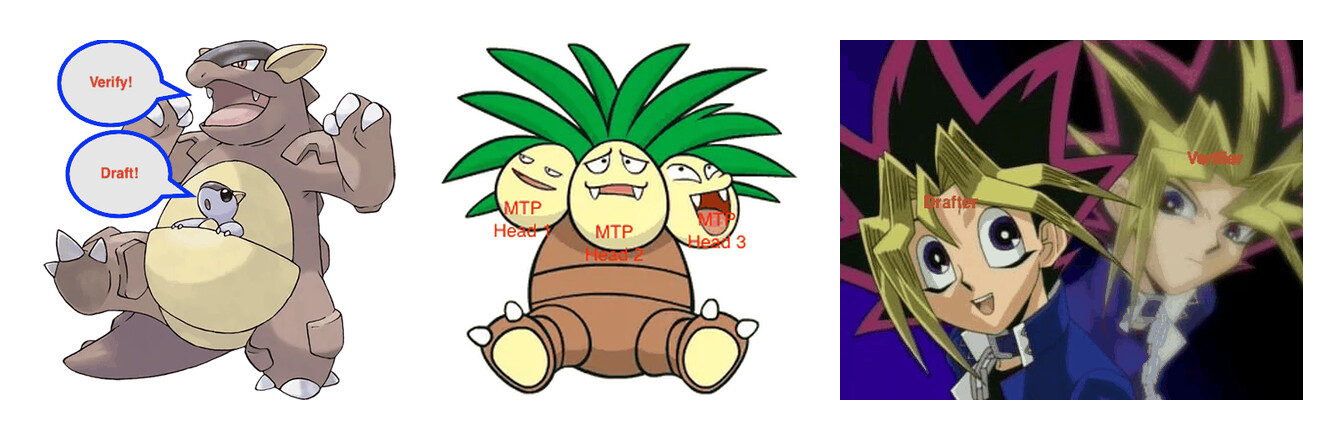
블로그는 세 방식을 위와 같은 그림으로 비유합니다. 별도 초안 모델 방식은 초안 담당과 검증 담당이 서로 다른 모델이라 빠르지만, 모델을 하나 더 학습하고 서빙하며 본 모델이 바뀔 때마다 초안 모델도 함께 맞춰야 합니다. MTP는 머리(헤드)를 여러 개 달아 한 번에 여러 토큰을 예측하고, 뽑은 토큰을 그대로 쓰거나 메인 LM 헤드로 검증합니다. 자기 추측 디코딩은 한 모델이 두 역할을 번갈아 맡아, 확산 경로가 초안을 쓰고 AR 경로가 검토합니다.
이 비교에서 GravityOCR과 방법론적으로 가장 가까운 선행 연구는 AR VLM을 블록 확산 모델로 변환하고 자기 추측 디코딩을 적용한 Fast-dVLM과, 언어 모델과 VLM을 AR, 확산, 자기 추측 세 모드로 동작하게 만든 Nemotron-Labs-Diffusion입니다. GravityOCR은 이 계열의 방법을 문서 OCR의 영역 단위 인식 모델에 적용하고, 아래의 AR 경로 강화학습을 더했습니다. 문서 파싱 가속에는 다른 방향의 연구도 있습니다. HSD(Hierarchical Speculative Decoding)는 추가 학습 없이 영역 단위 초안을 만들어 영역들을 병렬로 검증한 뒤, 페이지 단위 검증을 한 번 더 거쳐 문서 전체의 일관성을 유지합니다.
AR 경로에 적용한 GRPO 강화학습과 OCR 전용 보상 설계
토큰 단위 손실로 학습한 모델을 OCR 품질 지표에 맞춰 한 번 더 다듬기 위해, GravityOCR은 강화학습(Reinforcement Learning) 인 GRPO(Group Relative Policy Optimization)를 적용합니다. 확산 언어 모델에 강화학습을 적용하려면 여러 단계의 마스크 해제 경로(trajectory)에 대해 시퀀스 우도를 근사해야 하는데, 이 계산은 까다롭고 비용도 큽니다. GravityOCR은 최종 출력을 AR 검증기가 결정한다는 점을 이용해 이 문제를 피합니다. AR 경로의 정확한 자기회귀 우도로 표준 GRPO를 적용하면, 공유 파라미터가 갱신되면서 확산 초안 경로도 함께 바뀝니다.
보상(Reward) 은 OCR 작업 종류에 따라 다르게 설계했으며, 모두 0~1 범위의 값을 가집니다.
-
일반 텍스트: 정규화 편집 거리(Normalized Edit Distance, NED)를 이용한 편집 유사도 1-\mathrm{NED} 를 사용합니다.
-
HTML 표: 구조만 비교하는 TEDS(Tree-Edit-Distance-based Similarity)와 셀 내용 유사도를 0.45:0.55로 섞고, 행 수가 정답보다 많거나 적을 때와 같은 행이 반복될 때 감점합니다. 태그가 닫히지 않은 표는 0점입니다.
-
LaTeX 수식: 구분 기호와 공백 등을 정리해 정규화한 LaTeX의 편집 유사도를 쓰고, 괄호 짝이나
\begin/\end환경이 맞지 않는 등 형식 검사 중 정답은 통과하는데 예측만 실패한 항목의 개수 v 에 따라 0.3^{v} 을 곱해 줄입니다. -
공통 퇴화 방지: 8-gram 다양성 비율과 가장 긴 단일 문자 반복 길이로 계산한 계수를 모든 보상에 곱해, 같은 문자열을 반복하는 퇴화 출력을 억제합니다.
모든 보상은 예측과 정답을 OmniDocBench 공식 채점기와 같은 방식으로 정규화한 뒤 계산하므로, 평가에서 무시되는 표기 차이를 바꾸는 것으로는 보상을 올릴 수 없습니다. 수식 평가 지표인 CDM은 보상으로 쓰지 않았습니다.
GRPO는 공동 학습 40,000 스텝 체크포인트에서 출발해 전체 모델을 500 스텝 동안 미세조정했습니다. 한 스텝에 24개 프롬프트, 프롬프트당 28개 롤아웃(rollout)을 샘플링하고, 학습률 3\times10^{-6}, KL 발산(Kullback-Leibler Divergence) 페널티 \beta = 10^{-3} 을 사용했습니다. 프롬프트 풀은 공개 데이터의 영역 이미지 7,723개로, 92%가 표이며 어렵고 긴 표 위주로 골랐습니다. 그 결과 자기 추측 디코딩의 Overall 점수는 94.92에서 95.16으로 올랐고, TPF는 9.61에서 9.68로 거의 변하지 않았습니다. 확산 경로에 별도 목적 함수를 주지 않았는데도 초안과 검증기의 일치도가 유지된 것입니다.
검증 없는 블록 확산도 GRPO 이후 정확도가 비슷하거나 올랐습니다. 다른 임계값에서는 변화가 0.4점 미만이었지만 임계값 0.95에서는 89.62점에서 92.53점으로 2.91점 올랐는데, 부록에 따르면 GRPO 이전 모델은 이 임계값에서 CDM 0점을 받은 수식이 116개(전체 2,352개 중)로 GRPO 이후(37개)의 세 배였습니다. 앞 절에서 비슷한 병렬성으로 비교한 블록 확산 92.53점은 이 GRPO 이후 수치입니다.
OmniDocBench v1.6 벤치마크 결과와 페이지 처리 속도
품질은 문서 파싱 표준 벤치마크인 OmniDocBench v1.6(1,651페이지)의 공식 프로토콜로, 속도는 같은 벤치마크의 영어 페이지 100장을 H100 한 장에서 한 번에 한 페이지씩 처리하며 측정했습니다. GravityOCR과 GLM-OCR은 페이지마다 레이아웃 분석(페이지당 112~146ms)으로 찾은 약 18개 영역을 동시에 인식 요청합니다. 속도에는 각 시스템의 레이아웃 분석, 영역 인식, 결과 조립까지 모두 포함되며, 토크나이저가 모델마다 달라 모델 간 비교에는 초당 토큰 수 대신 초당 페이지 수를 씁니다. 모든 수치는 저자들이 각 모델의 공개 구현으로 직접 측정한 값입니다.
모델 디코딩 Text↓ TEDS↑ CDM↑ Overall↑ TPF 페이지/초 MinerU2.5 AR 0.045 0.881 0.959 93.18 1.0 0.407 MinerU2.5-Pro AR 0.037 0.935 0.969 95.57 1.0 0.399 MinerU-Diffusion 확산 0.073 0.853 0.916 89.87 5.2 0.059 PaddleOCR-VL-1.5 () AR 0.042 0.919 0.969 94.86 1.0 0.389 dots.ocr AR 0.048 0.865 0.917 91.14 1.0 0.116 DeepSeek-OCR-2 AR 0.049 0.859 0.933 91.42 1.0 0.022 HunyuanOCR-1.5 AR 0.036 0.952 0.949 95.52 1.0 0.313 HunyuanOCR-1.5 DFlash 0.036 0.952 0.949 95.52 9.9† 0.579 GLM-OCR (base) AR 0.040 0.934 0.970 95.48 1.0 0.571 GLM-OCR (base) MTP 0.040 0.934 0.970 95.48 3.7† 0.472 GravityOCR AR 0.040 0.928 0.967 95.16 1.0 0.554 GravityOCR 자기 추측 0.040 0.928 0.967 95.16 9.7 0.730† 별도 초안 파라미터를 쓰는 모드로, 초안 계산을 제외하고 기반 모델의 검증 1회당 수락된 토큰 수를 셉니다. MinerU-Diffusion의 TPF는 위의 검증 없는 블록 확산과 같은 셈법입니다. Text는 문자열 정규화 편집 거리, TEDS는 표, CDM(Character Detection Matching)은 수식 지표입니다.
위 표에서 GravityOCR의 Overall 점수는 원본 GLM-OCR보다 0.32점 낮은 95.16으로, 원본 점수의 99.7%를 유지합니다. 영역별로 보면 텍스트 지표는 같고 차이는 대부분 표(TEDS 0.928 vs. 0.934)에서, 일부는 수식(CDM 0.967 vs. 0.970)에서 발생했습니다. 속도에서는 초당 0.730페이지로 표 안에서 가장 빠르며, 같은 체크포인트의 AR 모드(0.554) 대비 1.32배입니다. 두 가지 추측 디코딩 기준선과의 비교도 눈에 띕니다. GLM-OCR에 내장된 MTP는 출력 길이 제한 없이 측정했을 때 forward당 3.7토큰을 확정하는데도 원본 AR 모드(0.571)보다 오히려 느린 0.472를 기록했고, 별도 초안 모델을 쓰는 HunyuanOCR-1.5 + DFlash(0.579)보다도 GravityOCR이 빠릅니다. 다만 HunyuanOCR은 레이아웃 단계 없이 페이지 전체를 한 번에 읽는 모델이라 파이프라인 경계가 달라 직접 비교에는 주의가 필요하다고 저자들도 밝히고 있습니다. 기술 보고서 부록에 따르면 dots.ocr과 DeepSeek-OCR-2도 페이지 전체를 한 요청으로 읽고, MinerU는 페이지당 약 1.3초가 드는 무거운 레이아웃 단계를 쓰는 등 시스템마다 파이프라인 구성이 다릅니다.
위 애니메이션은 OmniDocBench 한 페이지(영역 7개, 1,844토큰)를 두 방식으로 디코딩하는 모습을 실측 속도 그대로(6.3배 느리게 재생) 보여줍니다. AR 디코딩은 forward 1,844번에 2.86초, 자기 추측 디코딩은 124번에 1.06초가 걸려 이 페이지에서는 2.7배 빨랐습니다. 여기서 시간은 영역별 요청 시간을 기준으로 하며 레이아웃 분석은 들어가지 않습니다. 영역당 평균 약 263토큰으로 긴 출력이 많은 페이지의 예시이고, 영역 이미지 전체 평균은 1.74배, 레이아웃 분석까지 포함한 100페이지 평균은 1.32배입니다.
표와 수식 인식 전용 벤치마크에서도 결과를 확인했습니다. PubTabNet 검증 세트(표 9,115개)에서 GravityOCR의 TEDS는 0.871로 원본 GLM-OCR(0.803)보다 높았고, 구조만 보는 TEDS-struct도 0.858에서 0.916으로 올랐습니다. 다만 비교한 외부 모델 중에서는 dots.ocr이 TEDS 0.893, TEDS-struct 0.935로 GravityOCR보다 높았습니다. 수식 인식 벤치마크 UniMER-Test의 CDM은 0.962로, 원본(0.963)과 거의 같으면서 비교한 외부 모델들보다 높았습니다. PubTabNet 점수 상승에는 GRPO 프롬프트의 92%가 표였다는 점과 학습 데이터에 PubTabNet 학습 분할이 포함되었다는 점이 함께 작용했을 수 있습니다.
속도 향상의 조건: 추론 백엔드, 출력 유형, 출력 길이, 배치 크기
추론 백엔드와 측정 범위에 따른 차이
영역 이미지 단위로 AR과 자기 추측 디코딩을 비교하면 추론 백엔드에 따라 속도 향상 폭이 크게 달라집니다(영어 OmniDocBench 영역 이미지 8,922개, 배치 크기 1).
백엔드 디코딩 디코딩 구간 tok/s 전체 요청 tok/s 속도 향상 Hugging Face Transformers AR 53 51 - Hugging Face Transformers 자기 추측 293 161 5.53배 / 3.20배 SGLang AR 777 486 - SGLang 자기 추측 3,057 844 3.94배 / 1.74배디코딩 구간은 영역마다 고정으로 드는 비용(이미지 인코딩과 프롬프트 사전 처리)을 제외하고 토큰 생성 구간만 잰 값이고, 전체 요청은 고정 비용까지 포함한 값입니다. Transformers의 즉시 실행(eager) 구현은 커널 실행 오버헤드가 지배적이라 토큰 하나를 처리하든 초안 블록 전체를 처리하든 forward 비용이 비슷하므로, 속도 향상이 TPF 비율에 가까워집니다. 반면 SGLang은 융합 커널 덕분에 forward 자체가 싸지는 대신 처리하는 토큰 수에 비례해 비용이 늘고, 디코딩이 빨라진 만큼 고정 비용의 비중이 커져 전체 요청 기준 향상 폭이 작아집니다. 페이지 단위로 가면 여기에 레이아웃 분석과 결과 조립 비용까지 더해져 1.32배가 됩니다.
참고로 Trillion Labs 블로그에는 forward당 9.6토큰, 디코딩 구간 3.85배, 페이지 처리 1.34배(0.581 → 0.781페이지/초)로 적혀 있습니다. 이 중 forward당 토큰 수와 페이지 처리 속도가 기술 보고서에 적힌 GRPO 이전 체크포인트의 수치(TPF 9.61, 0.581 → 0.781페이지/초)와 일치하므로, 블로그는 GRPO 이전 체크포인트의 측정값을 인용한 것으로 보입니다. 이 글은 기술 보고서와 모델 카드의 최종 GRPO 체크포인트 수치를 기준으로 했습니다.
같은 부록에는 한 페이지의 영역 요청(약 18개)을 보내는 방식에 따른 차이도 나옵니다. GRPO 이전 체크포인트 기준으로 영역 요청을 모두 동시에 보내면 1.34배(0.581 → 0.781페이지/초), 하나씩 순차로 보내면 1.54배(0.273 → 0.420페이지/초)였습니다. 순차 요청일수록 GPU가 한가해 추측 디코딩의 이득이 커지며, 아래 배치 크기 실험과 같은 경향입니다.
출력 유형과 출력 길이에 따른 차이
위 애니메이션은 표 영역 하나를 자기 추측 디코딩으로 인식하는 과정으로, forward 16번에 214토큰(forward당 13.38토큰)을 확정하고 결과는 AR 그리디 디코딩과 바이트 단위로 같습니다. 이처럼 문법 제약이 강한 출력일수록 초안이 한 번에 잘 맞습니다.
출력 유형 영역 수 평균 출력 토큰 라운드당 수락 토큰 TPF AR tok/s 자기 추측 tok/s 속도 향상 텍스트 7,019 73 15.0 8.5 419 647 1.54배 수식 1,660 95 18.9 10.5 520 947 1.82배 표 243 872 25.0 13.5 732 2,462 3.36배 전체 8,922 99 17.4 9.7 486 844 1.74배위 표에서 표 영역은 32개 초안 토큰 중 평균 25.0개가 수락되어 텍스트(15.0개)보다 수락률이 높고, 출력도 평균 872토큰으로 길어 고정 비용이 잘 희석됩니다. 그 결과 표의 속도 향상은 3.36배로 텍스트(1.54배)의 두 배가 넘습니다. 출력 길이로 나눠 보면 이 경향이 더 분명합니다.
출력 길이 영역 수 라운드당 수락 토큰 TPF 속도 향상 128토큰 미만 7,257 14.8 8.4 1.43배 128~511토큰 1,496 18.1 10.1 2.02배 512~1,023토큰 92 18.4 10.2 2.76배 1,024토큰 이상 77 23.9 12.9 3.68배1,024토큰이 넘는 영역에서는 3.68배까지 빨라지지만, OmniDocBench 영역의 약 5분의 4가 128토큰 미만의 짧은 조각이라 전체 평균은 1.74배에 머뭅니다. 논문은 출력 유형별 차이의 상당 부분이 이러한 길이 효과라고 분석합니다.
기술 보고서 부록에는 최종 GRPO 체크포인트로 텍스트, 수식, 표 영역을 디코딩한 예시가 실려 있습니다. 출력의 각 문자를 그 문자를 확정한 라운드의 색으로 칠했고, 빨간 세로선은 초안이 거절되어 검증기의 토큰을 대신 확정한 위치입니다. 모든 예시의 출력은 같은 가중치의 AR 그리디 디코딩과 바이트 단위로 같습니다.

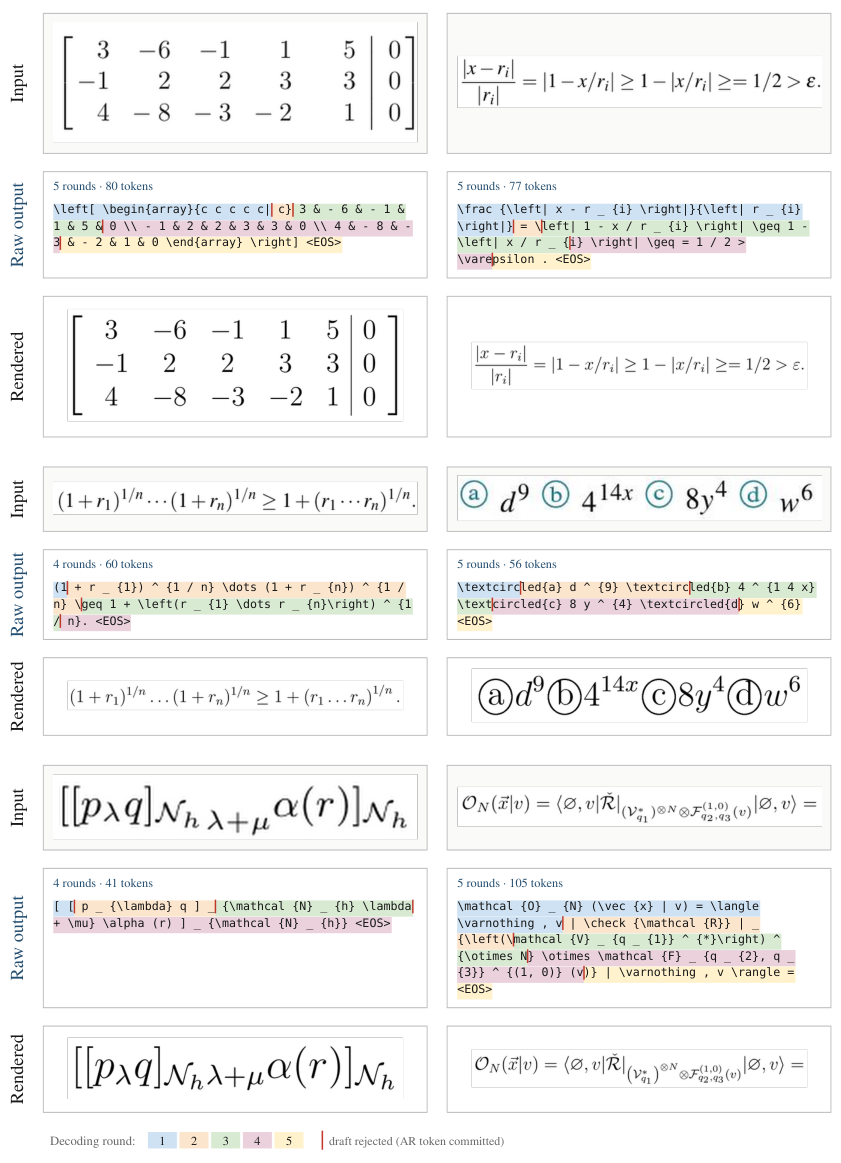
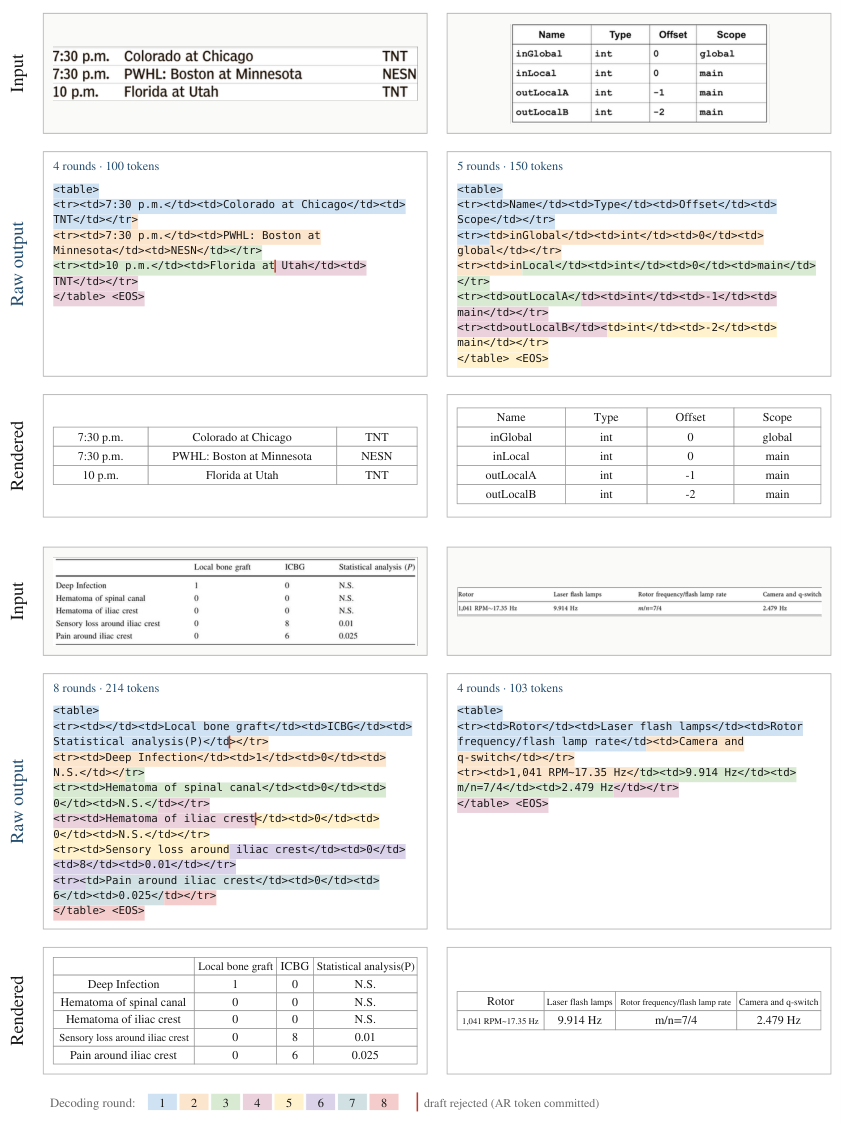
위 그림에서 텍스트 예시는 3~4라운드에 32~52토큰(라운드당 약 10~17토큰), 수식 예시는 4~5라운드에 41~105토큰(약 10~21토큰)을 확정했습니다. 표 예시는 4~8라운드에 100~214토큰을 확정해 모두 라운드당 25토큰 이상 나아갔고, 표에서 수락 길이가 가장 길다는 위 표의 결과와 같은 경향을 보입니다.
배치 크기에 따른 처리량 변화
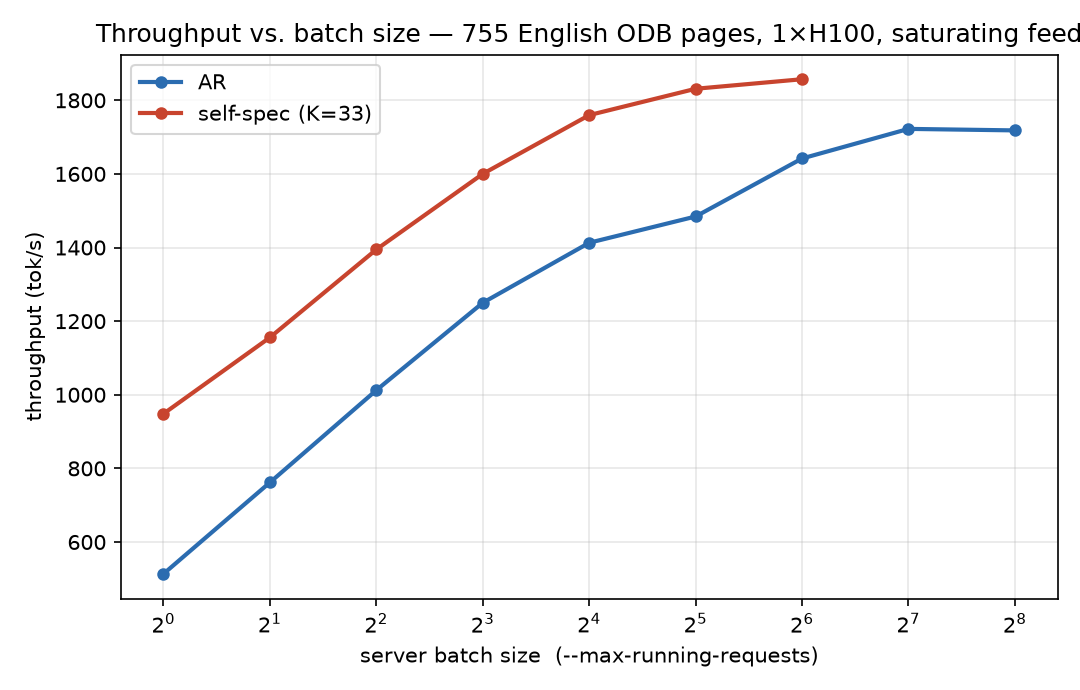
추측 디코딩은 GPU가 놀고 있을 때 가장 큰 이득을 냅니다. 배치 크기를 키우면 AR 디코딩도 GPU 연산을 채우기 시작해, 자기 추측 디코딩의 우위가 배치 1에서 1.85배, 배치 64에서 1.13배(AR 1,642 vs. 자기 추측 1,857 tok/s)로 줄어듭니다(GRPO 이전 체크포인트로 측정). 블로그에 따르면 두 방식을 각자의 최대 처리량끼리 비교하면 차이는 1.08배까지 좁혀집니다. 즉 GravityOCR의 이점은 지연 시간(Latency)이 중요한 단건 서빙에서 크고, 대량의 문서를 배치로 몰아 처리하는 오프라인 작업에서는 작습니다. 배치 크기에 맞춰 초안 길이를 조절하는 하드웨어 인식 동적 추측 디코딩(DSD)이 같은 문제를 다룬 사례입니다.
한 번의 초안 forward가 여러 번의 정제보다 유리한 이유
일반적인 확산 디코딩은 한 블록을 여러 단계에 걸쳐 정제합니다. GravityOCR에서도 초안을 여러 번 다듬은 뒤 검증에 넘길 수 있지만, 영어 영역 이미지 400개로 측정해 보니 정제 단계를 늘릴수록 라운드당 수락 토큰은 18.7개에서 24.7개로 늘어난 반면 추가 forward 비용이 더 빨리 늘어 TPF는 계속 감소했습니다(한 번의 초안 9.00 vs. 4단계 정제 6.93). OCR에서는 한 번에 만든 초안이 이미 충분히 정확하므로, 초안을 다듬는 데 쓸 forward로 다음 라운드를 도는 편이 효율적입니다.
학습 설계에 대한 절제 실험: AR 손실과 마스킹 방식
절제 실험(Ablation Study) 은 두 가지 설계 선택을 검증합니다. 첫 번째는 보조 AR 손실의 효과입니다. 사전 학습된 AR 모델에서 출발했으므로 AR 손실 없이도 검증은 가능하지만, 1만 스텝 체크포인트끼리 비교하면 AR 손실을 뺐을 때 Overall 점수가 95.02에서 93.64로 떨어졌습니다. TPF는 6.75(AR 손실 있음)와 6.96(없음)으로 비슷해, AR 손실은 초안 효율을 거의 해치지 않으면서 검증기의 정확도를 지킵니다. 블로그는 AR 손실을 보조 손실로 쓸 때 확산 디코딩 자체의 성능도 함께 오르는 것을 확인했다고 덧붙입니다.
두 번째는 마스킹 방식입니다. 초안 단계에서는 블록 전체가 마스크인 상태에서 한 번에 채우므로, 학습 때도 블록을 통째로 가리는 것이 더 잘 맞을 것처럼 보입니다. 그러나 결과는 반대였습니다. 블록마다 마스킹 비율을 균등분포에서 샘플링하는 방식이 모든 토큰을 가리는 방식보다 모든 체크포인트에서 TPF가 높았고(1만 스텝 기준 6.75 vs. 6.66), Overall 점수도 6개 체크포인트 중 5개에서 앞섰습니다(1만 스텝 기준 95.02 vs. 94.86).
GravityOCR 사용 방법
GravityOCR 체크포인트는 GLM-OCR과 같은 GlmOcrForConditionalGeneration 구조(CogViT 비전 인코더 + 0.5B 텍스트 디코더, 전체 0.9B)를 그대로 사용하므로, 기존 AR 파이프라인에서 GLM-OCR을 그대로 대체할 수 있습니다. AR 디코딩만 필요하다면 저장소 코드 없이 transformers>=5.8만으로 실행됩니다.
from transformers import AutoProcessor, GlmOcrForConditionalGeneration
import torch
from PIL import Image

repo = "trillionlabs/GravityOCR"
processor = AutoProcessor.from_pretrained(repo)
model = GlmOcrForConditionalGeneration.from_pretrained(repo, torch_dtype=torch.bfloat16, device_map="cuda")

image = Image.open("page_region.png").convert("RGB")
messages = [{"role": "user", "content": [{"type": "image", "image": image},
                                         {"type": "text", "text": "Text Recognition:"}]}]
inputs = processor.apply_chat_template(messages, add_generation_prompt=True, tokenize=True,
                                       return_dict=True, return_tensors="pt").to(model.device)
out = model.generate(**inputs, max_new_tokens=4096, do_sample=False)
print(processor.decode(out[0, inputs["input_ids"].shape[1]:], skip_special_tokens=True))
프롬프트는 GLM-OCR과 같이 Text Recognition:, Table Recognition:(HTML), Formula Recognition:(LaTeX) 세 가지입니다. 모델은 요청 하나당 레이아웃 영역 하나를 읽으므로, 페이지 전체를 처리하려면 GLM-OCR SDK처럼 PP-DocLayoutV3와 같은 레이아웃 검출기로 영역을 먼저 나눠야 합니다.
이 모델의 핵심인 자기 추측 디코딩은 저장소 코드가 필요합니다. SGLang v0.5.12에 저장소의 patches/sglang/ 패치를 적용한 뒤 아래와 같이 OpenAI 호환 엔드포인트로 서빙하거나(MODE=ar로 같은 체크포인트를 AR로 서빙해 직접 비교할 수 있습니다), 프로세스 안에서 바로 실행할 수 있습니다.
# SGLang v0.5.12 + our patch
git clone https://github.com/sgl-project/sglang $SGLANG_SRC && cd $SGLANG_SRC
git checkout $(cut -c1-40 $DOCR_ROOT/patches/sglang/sglang_BASE_COMMIT.txt)          # v0.5.12 base commit
git apply $DOCR_ROOT/patches/sglang/sglang_0.5.12_selfspec.patch
cp -r $DOCR_ROOT/patches/sglang/python .                                            # the new worker file
uv venv .venv-sglang --python 3.12 && uv pip install --python .venv-sglang/bin/python -r $DOCR_ROOT/env/sglang_venv_freeze.txt -e $SGLANG_SRC/python

# serve (MODE=spec = self-speculative, MODE=ar = plain autoregressive, same weights)
bash serve/serve_sglang_ocr.sh MODE=spec GPU=0 PORT=30500 CKPT=<path or trillionlabs/GravityOCR> CONTEXT=16384 VBIN=$PWD/.venv-sglang/bin
curl localhost:30500/v1/models          # OpenAI-compatible
서버 없이 프로세스 안에서 실행할 때는 src/infer_omnidocbench.py에 --spec_natcache 옵션을 주며, 이 옵션을 빼면 같은 스크립트가 AR로 동작합니다. 저장소 설명에 따르면 두 캐시 방식(--spec, --spec_natcache)과 AR 경로는 바이트 단위로 같은 텍스트를 출력합니다. 실행 환경은 Python 3.12, CUDA 12.8, H100 기준으로 정리되어 있습니다.
설치부터 서빙, 평가까지의 절차는 저장소의 AGENTS.md에 단계별로 정리되어 있으며, 코딩 에이전트에게 이 파일을 넘겨 그대로 따라 하게 해도 된다고 안내하고 있습니다. 모델 파일에는 bf16 가중치(2.2GB)와 함께 block_diffusion.json이 포함되어 있습니다.
{"bd_size": 32, "mask_id": 59282, "ar_loss_weight": 1.0, "mask_schedule": "uniform", ...}
bd_size는 학습에 쓴 블록 크기로 서빙할 때도 같은 값을 써야 하고, mask_id는 초안에 쓰는 <|mask|> 토큰의 ID입니다. ar_loss_weight가 0보다 크면 AR 경로가 학습된 체크포인트라 자기 초안을 스스로 검증할 수 있습니다.
GravityOCR의 한계와 적용 시 고려사항
GravityOCR은 검증 단계를 더해 같은 병렬성(forward당 약 10토큰)에서 블록 확산만 쓸 때보다 Overall 점수를 2.6점 높였지만, 도입을 검토할 때 확인할 점이 몇 가지 있습니다.
-
한국어 성능은 보고되지 않았습니다: 미세조정 데이터는 대부분 영어이고, 모델 카드는 중국어가 기반 모델 수준으로 동작한다고만 밝히고 있습니다. 속도 측정도 모두 영어 페이지로 이루어졌습니다. 한국어 문서에서 확산 초안의 수락률이 영어만큼 나오는지는 별도로 확인이 필요합니다.
-
페이지 단위 이득은 디코딩 구간 이득보다 훨씬 작습니다: 디코딩 구간 3.94배가 페이지 처리 1.32배로 줄어드는 것은 레이아웃 분석, 이미지 인코딩, 프롬프트 사전 처리가 가속 대상이 아니기 때문입니다. 짧은 텍스트 영역이 대부분인 문서라면 체감 향상은 더 작을 수 있습니다.
-
배치 처리에서는 우위가 크게 줄어듭니다: 배치 64에서 1.13배, 최대 처리량끼리는 1.08배로, 대량 문서를 오프라인으로 처리하는 환경에서는 AR 서빙과 큰 차이가 나지 않습니다.
-
"같은 출력"은 bf16 서빙에서 96.6%입니다: 정확한 산술에서는 AR과 동일하지만, 실제 서빙 커널에서는 나머지 영역에서 부동소수점 동률로 인한 차이가 생깁니다. 품질 점수는 두 경로 모두 95.16으로 같게 보고되었습니다.
-
학습 코드는 공개되지 않았습니다: 저장소는 공개 모델의 추론, 서빙, 평가만 다루며, 학습 코드와 강화학습 코드, 데이터 파이프라인은 포함하지 않는다고
AGENTS.md에 밝혀 두었습니다. 다른 OCR 모델에 같은 변환을 적용하려면 기술 보고서의 설명을 바탕으로 학습 과정을 직접 구현해야 합니다. -
비교 수치는 모두 저자 측 재측정입니다: 외부 모델은 각자의 공식 추론 스택(vLLM, PaddleX, Transformers 등)과 각자의 파이프라인 구성(레이아웃 단계 유무 포함)으로 측정했고, GravityOCR과 GLM-OCR AR은 SGLang으로 측정했습니다. GLM-OCR의 MTP 모드도 공식 vLLM 경로로 쟀기 때문에 스택 차이가 결과에 섞였을 수 있습니다. 문서 OCR 벤치마크에서 이러한 측정 조건의 차이가 순위에 미치는 영향은 벤치마크를 믿기 어려운 이유 - 홈 어드밴티지 글에서도 다룬 바 있습니다.
라이선스
GravityOCR의 코드와 공개 가중치는 MIT 라이선스로 배포되고 있어, 연구 목적은 물론 상업적 용도로도 자유롭게 사용 및 수정이 가능합니다. 기반 모델인 GLM-OCR도 Z.ai의 MIT 라이선스를 따르며, SGLang 패치는 SGLang과 같은 Apache License 2.0이 적용됩니다.
Diffusion으로 OCR 디코딩 가속하기 소개 블로그
Trillion Labs ResearchDiffusion으로 OCR 디코딩 가속하기 — Trillion Labs Research
OCR 모델을 AR과 block diffusion 겸용으로 변환해, diffusion으로 초안을 쓰고 AR로 검증하는 self-speculative decoding — 품질 손실 없이 디코딩 3.85배 가속.
Diffusion Drafts, AR Verifies: Accelerating Document OCR with Self-Speculative Decoding 기술 보고서
arXiv.orgDiffusion Drafts, AR Verifies: Accelerating Document OCR with...
Autoregressive OCR vision-language models accurately convert document images into text and structured markup, but require one sequential decoding step per output token, limiting inference speed. Unlike open-ended text generation, OCR outputs are...
GravityOCR 모델 (Hugging Face)
huggingface.cotrillionlabs/GravityOCR · Hugging Face
We’re on a journey to advance and democratize artificial intelligence through open source and open science.
GravityOCR GitHub 저장소
github.comGitHub - trillion-labs/GravityOCR
Contribute to trillion-labs/GravityOCR development by creating an account on GitHub.
더 읽어보기
-
GLM-OCR: 0.9B 파라미터로 SOTA 성능을 달성한 초경량 오픈소스 OCR 모델 (feat. Z.ai)
-
확산 언어 모델(Diffusion LLM)의 개념과 동작에 대한 연구 정리: LLaDA에서 DiffusionGemma까지
-
DFlash: 블록 확산(Block Diffusion) 기반으로 LLM 추론 속도를 높이는 오픈소스 라이브러리 (feat. Z.ai)
-
Orthrus: Dual-View 디퓨전 디코딩으로 LLM 추론을 가속하는 무손실 병렬 토큰 생성 프레임워크
-
Unlimited OCR: KV 캐시를 고정해 수십 페이지를 한 번에 인식하는 장문 OCR에 대한 연구 (feat. Baidu)
-
한국 초지능 연구 스타트업 Trillion Labs, 한국어로 처음부터 학습한 Tri Series의 중간 체크포인트 공개
-
gWorld: Trillion Labs가 공개한, 실행 가능한 코드로 모바일 세상을 시뮬레이션하는 생성형 월드 모델
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
파이토치 한국 사용자 모임은 이런 글들을 한국어로 정리해 나누고 있습니다. 회원으로 가입하시면 주요 글들을 이메일로 보내드리고, 텔레그램(Telegram)과 Slack/Discord/Teams/Dooray/GoogleChat 등으로도 새 글 알림을 받으실 수 있습니다.
아래쪽에 좋아요를 눌러주시면 다음 글을 정리하는 데 힘이 됩니다~
1개의 게시물 - 1명의 참여자