
Step 5 Preview 소개
StepFun(阶跃星辰)이 에이전트 작업을 겨냥한 플래그십 모델 Step 5 Preview를 공개했습니다. 희소 전문가 혼합(Mixture-of-Experts, MoE) 구조로 전체 600B 파라미터 중 토큰당 27B만 활성화하고, 1M 토큰 컨텍스트 윈도우와 이미지 및 영상 입력을 함께 지원합니다. StepFun은 이 모델을 소프트웨어 엔지니어링과 전문 지식 작업 전반에서 프론티어급 성능을 내는 모델로 소개하면서, 특히 금융 분야를 강점으로 내세웠습니다.
StepFun은 국내에도 Step-Audio 계열 음성 모델로 알려진 중국의 AI 연구 조직으로, Hugging Face의 stepfun-ai 계정을 통해 Step 3.5 Flash와 Step 3.7 Flash 같은 모델의 가중치를 꾸준히 공개해 왔습니다. Step 5 Preview 역시 10월 15일에 오픈 웨이트(open weights)로 공개될 예정이라고 밝혔는데, 현재는 API와 자사 제품으로만 쓸 수 있는 상태입니다.
이번 발표에서 눈여겨볼 지점은 벤치마크 1위 주장이 아니라 비용 축입니다. StepFun이 붙인 부제부터가 파레토 프론티어를 한 걸음 더 나아가다 인데, 이는 지능과 비용의 교환 관계에서 경계선 자체를 바깥으로 밀었다는 주장입니다. 실제로 제3자 평가 기관인 Artificial Analysis의 리더보드에서 Step 5 Preview는 지능 지수(Artificial Analysis Intelligence Index) 44점으로 Kimi K3(Max)와 동점이고 GLM-5.3(Max)보다 1점 낮은데, 작업당 비용은 그 두 모델의 3분의 1 수준입니다. 이 글에서는 StepFun이 공개한 평가 결과와 외부에서 확인 가능한 수치를 함께 놓고 이 주장이 어디까지 성립하는지 살펴보겠습니다.
이 글은 금융 업무를 포함한 여러 전문 작업을 평가 대상으로 삼은 언어 모델 Step 5 Preview와 그 평가 결과를 소개하는 글로, 파이토치 한국 사용자 모임은 인공지능 기술이 금융 분야에서 어떻게 활용될 수 있는지 가능성과 그 방법에 대한 소개를 하는 것입니다. 즉, 어떠한 경우에도 파이토치 한국 사용자 모임 및 이 글은 투자를 권유, 제안, 또는 추천하려는 목적으로 작성한 것이 아님을 알려드리며, 투자에 대한 조언을 구성하지 않습니다.
같은 지능 지수를 3분의 1 비용으로: 파레토 프론티어가 움직인 자리
StepFun이 발표 첫머리에 배치한 그림은 가로축이 작업당 비용(로그 스케일), 세로축이 Artificial Analysis 지능 지수인 산점도입니다. 축에 눈금 숫자가 없는 개념도라 그림만으로는 정확한 위치를 읽을 수 없지만, GLM-5.3과 Kimi K3에서 Step 5 Preview로 향하는 화살표에 -65% Cost 라는 라벨이 붙어 있습니다.
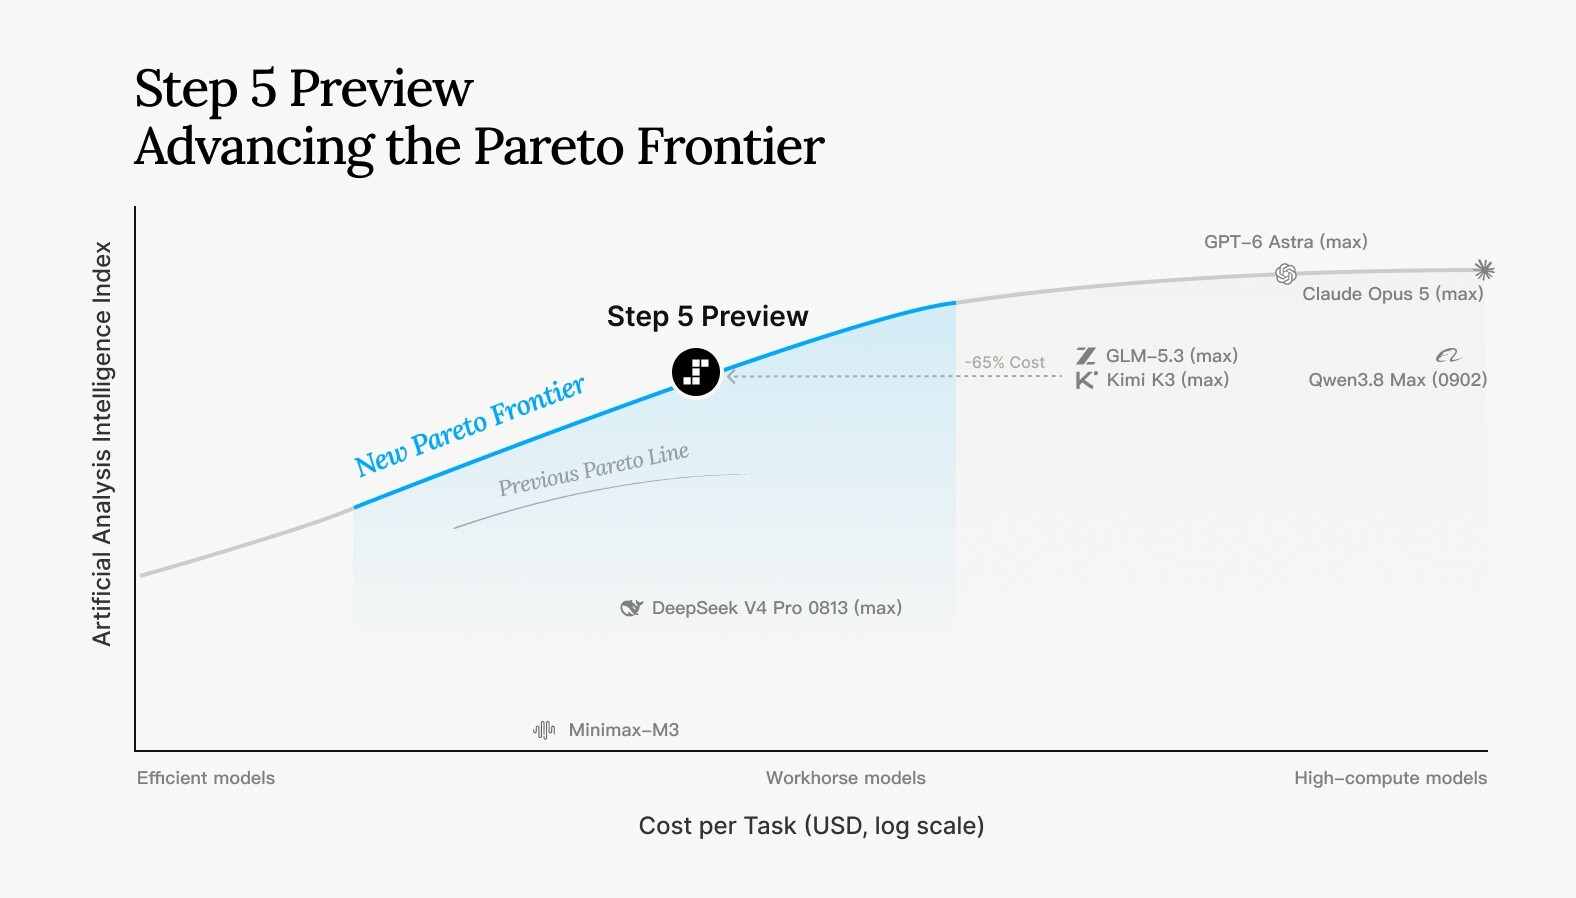
이 주장은 StepFun 바깥에서 검증할 수 있습니다. Artificial Analysis 리더보드를 2026년 9월 23일에 직접 확인해 보면 각 모델의 지능 지수와 작업당 비용이 다음과 같습니다. 비교 대상 모델들은 대부분 추론 노력을 최대로 올린 구성이라는 점을 감안해서 볼 필요가 있습니다.
모델 지능 지수 작업당 비용 Claude Fable 5.1 (max) 53 $7.63 GPT-6 Astra (max) 53 $3.26 Claude Opus 5 (max) 51 $5.86 GLM-5.3 (max) 45 $2.01 Step 5 Preview 44 $0.72 Kimi K3 (max) 44 $2.00 DeepSeek V4.1 Flash (max) 39 $0.27Kimi K3와 지능 지수가 같으면서 작업당 비용은 $2.00 대 $0.72로 약 64% 낮습니다. 출력 속도도 같은 날 기준 초당 84토큰 대 37토큰으로 두 배 이상 빠릅니다. 다만 속도는 측정할 때마다 움직이는 값이라 비율 정도로만 받아들이는 편이 좋습니다. StepFun이 그림에 붙인 -65% Cost 라벨과 어긋나지 않는 수치입니다. 다만 이 비교가 성립하는 구간은 지능 지수 44 부근이라는 점을 분명히 해 둘 필요가 있습니다. Claude Opus 5(51점)나 GPT-6 Astra(53점)와는 지능 지수에서 7점에서 9점 차이가 나므로, 이 표는 더 싸고 더 똑똑하다 가 아니라 같은 지능대에서 더 싸다 를 보여주는 표입니다.
API 요금은 StepFun 개발자 문서의 가격 페이지에 공개되어 있습니다. 100만 토큰 기준 입력이 $1.00, 캐시 적중 시 $0.05, 출력이 $2.70입니다. 출력 토큰에는 모델의 추론(reasoning) 과정과 최종 답변이 모두 포함되며, 캐시 미적중 입력 가격에는 새 내용을 캐시에 기록하는 비용이 포함됩니다.
소프트웨어 엔지니어링: StepCodeBench가 재려는 것
StepFun이 내세우는 코딩 능력의 범위는 프론트엔드 개발과 데이터 시각화부터 Blender로 3D 에셋을 만들어 Three.js 기반 웹 앱과 게임으로 옮기는 작업, 나아가 개발 문서와 사용자 권한이 주어지면 카메라와 COM 포트, 스크린샷, 가상 마우스 입력을 써서 프로그래머블 하드웨어를 직접 다루는 데까지 걸쳐 있습니다. 아래 영상은 공개된 데모 중 하나로, 침실 사진 한 장에서 출발해 가구를 옮기고 돌릴 수 있는 3D 공간을 만들고 마지막에는 1인칭으로 그 방을 둘러보게 하는 룸 플래너입니다.
https://www.stepfun.com/assets/road-dreams/media/room.mp4
이런 데모와 별개로, StepFun은 실제 현장의 소프트웨어 엔지니어링을 반영하겠다며 자체 벤치마크인 StepCodeBench를 만들었습니다. 553개의 독립 저장소, 9개 작업 범주, 20개 응용 도메인, 33개 프로그래밍 언어를 포괄한다고 밝혔습니다. 작업 범주에는 기능 수정, 버그 수정, 리팩토링, 문서화, 성능 튜닝, 코드 생성 외에 CI/CD 운영과 환경 설정처럼 벤치마크가 잘 다루지 않는 항목도 들어 있습니다.
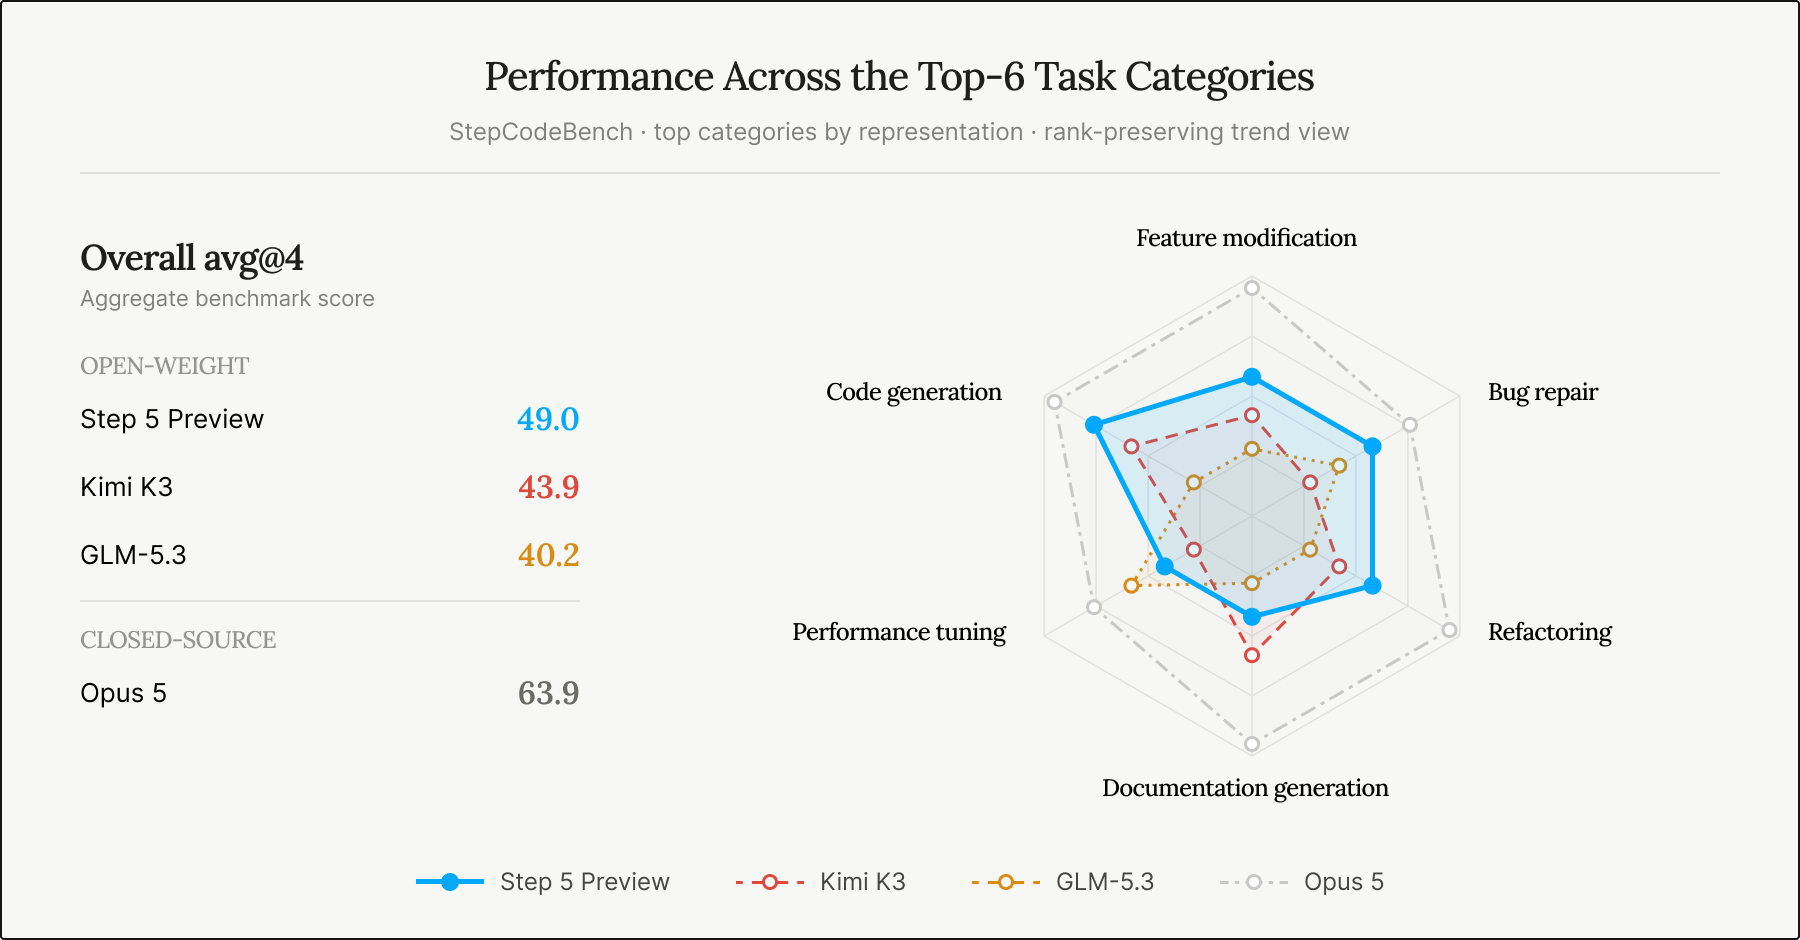
Step 5 Preview의 전체 avg@4 점수는 49.0%로, 같은 오픈 웨이트 계열인 Kimi K3(43.9%)와 GLM-5.3(40.2%)보다 높고 Claude Opus 5(63.9%)와는 15점 가까이 벌어집니다. 위 레이더 차트를 통해 두 가지를 확인할 수 있습니다. 첫째, Step 5 Preview가 오픈 웨이트 경쟁 모델을 앞서는 축은 버그 수정, 기능 수정, 리팩토링 쪽에 몰려 있습니다. 둘째, 성능 튜닝 축에서는 GLM-5.3이, 문서 생성 축에서는 Kimi K3가 각각 Step 5 Preview보다 바깥에 찍혀 있습니다. StepFun이 이 그림에 붙인 대체 텍스트는 여섯 축 전부에서 Step 5 Preview가 오픈 웨이트 모델을 앞선다고 적고 있지만, 그림 자체는 그렇게 읽히지 않습니다. 본문 설명은 버그 수정, 기능 수정, 리팩토링에서 특히 좋다 는 쪽으로 더 조심스럽게 적혀 있습니다. 덧붙여 이 레이더의 반경 축은 부제에 적힌 대로 순위를 보존하는 추세 뷰이므로, 점 사이의 거리를 점수 차이로 환산해 읽으면 안 됩니다.
StepFun은 언어별, 난이도별 분석에서도 주요 언어 전반에 걸쳐 일관된 성능을 보였고 낮은 난이도와 중간 난이도 작업에서는 Claude Opus 5에 근접했다고 밝히면서, 가장 어려운 장시간 작업에서는 프론티어와의 의미 있는 격차가 남아 있다 고 스스로 적었습니다. 내부와 외부 전문가 평가에서는 참가자의 약 70%가 Step 5 Preview를 중상 난이도의 코딩 작업을 자율적으로 해결할 수 있는 수준으로 판정했다고 합니다.
24시간을 버티는 실행: GPU 커널과 사후 학습 루프
단발성 벤치마크보다 흥미로운 쪽은 긴 시간 범위 실험입니다. StepFun은 측정 가능한 피드백이 존재하는 두 가지 환경을 골라, 모델에게 24시간을 주고 스스로 개선을 반복하게 했습니다.
첫 번째는 MLA(Multi-head Latent Attention) GPU 커널 최적화입니다. NVIDIA H100 한 장에서 헤드 차원 512, 배치 크기 1, 헤드 64개, 토큰 8,192개라는 실제 서빙 형상을 놓고 커널을 처음부터 작성하게 했습니다. 모델은 설명을 받아 코드를 고치고, 커널을 실행해 처리량을 재고, 처리량이 떨어진 후보는 버린 뒤 지금까지 가장 좋았던 버전에서 다시 출발하는 과정을 반복했습니다. 각 모델에 4회의 독립 시도를 주고 그중 최고 실행을 보고하는 방식입니다.
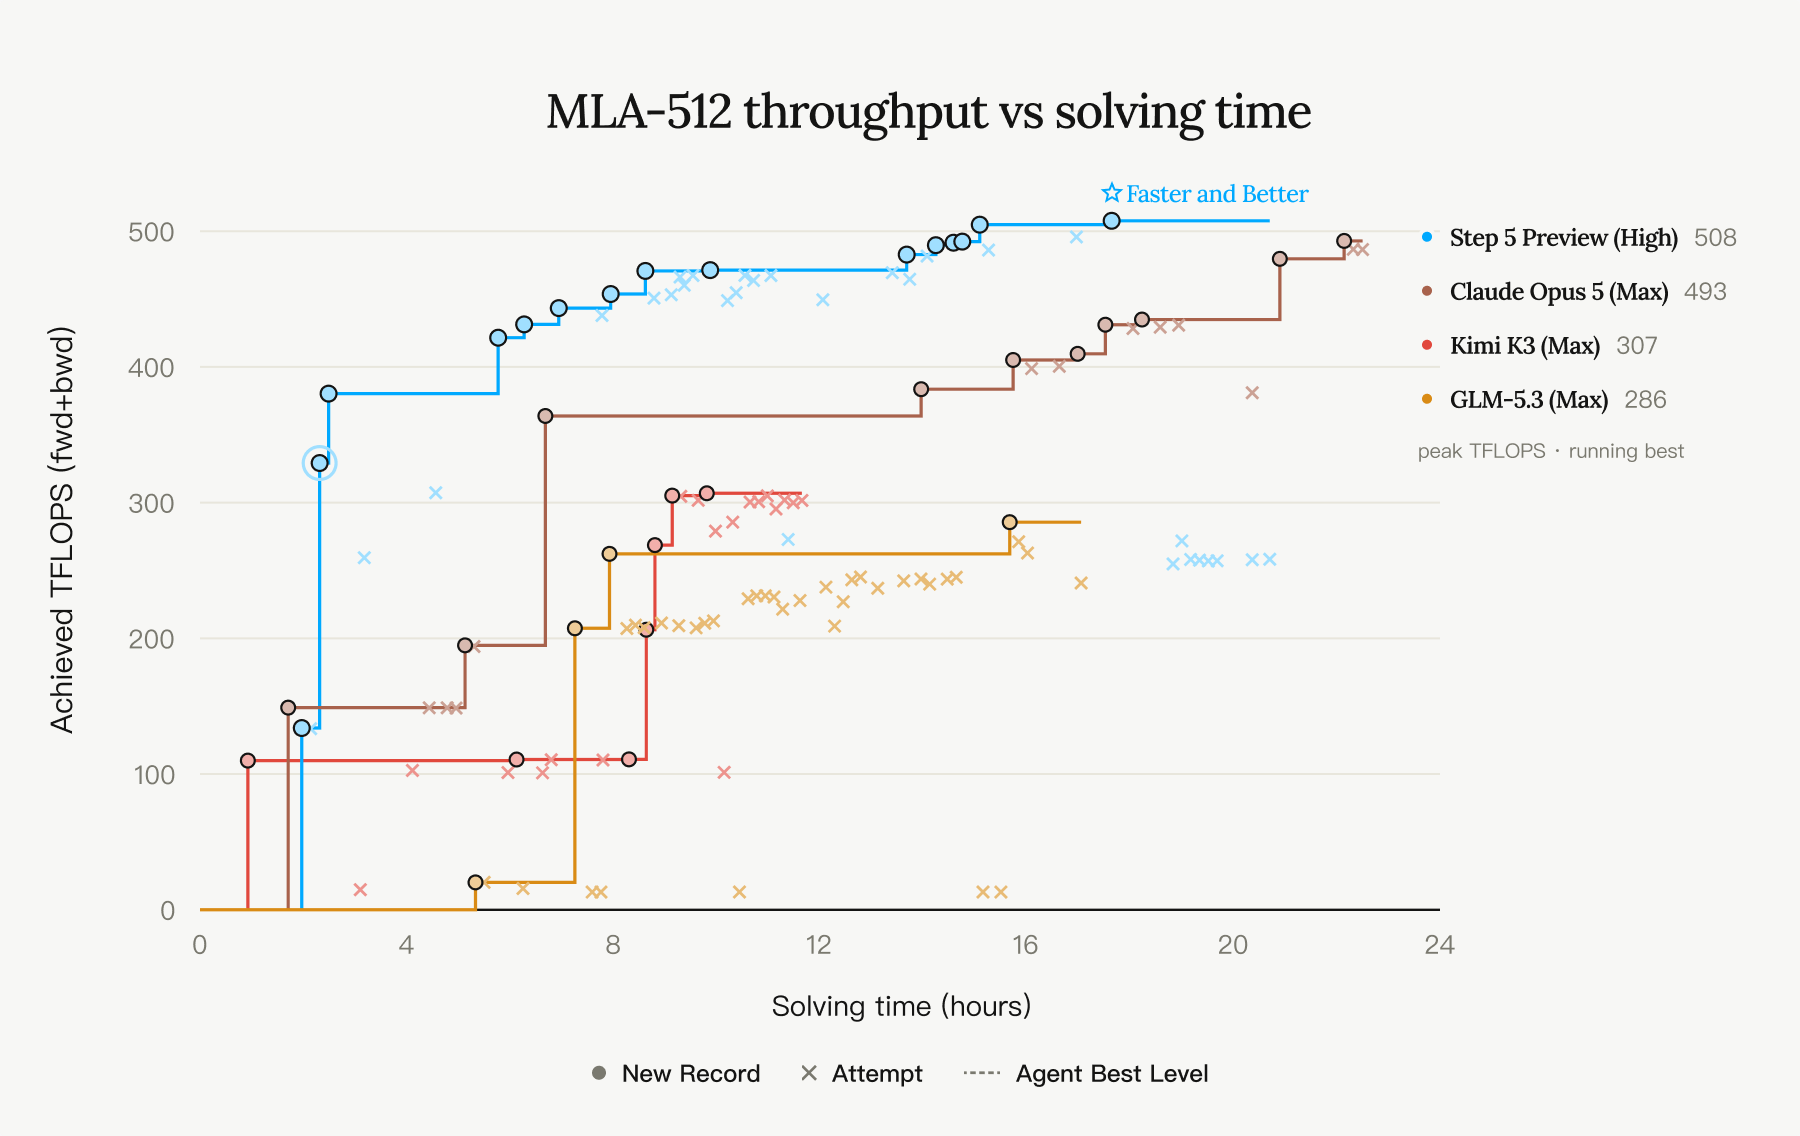
결과는 순전파와 역전파를 합쳐 Step 5 Preview가 508 TFLOPS, Claude Opus 5가 493 TFLOPS이고, StepFun은 Step 5 Preview가 약 22시간 만에 이 최고치에 도달했다고 적었습니다. 위 그래프를 통해 최종 수치보다 개선 곡선의 모양 차이를 확인할 수 있습니다. Step 5 Preview는 2시간 무렵 이미 380 TFLOPS를 넘겼고 9시간이 되기 전에 470 TFLOPS 구간에 올라선 반면, Claude Opus 5는 16시간 가까이 400 TFLOPS 부근에 머물다가 20시간을 넘겨서야 480 TFLOPS 구간에 들어옵니다. 같은 실험에서 Kimi K3는 307 TFLOPS, GLM-5.3은 286 TFLOPS에 머물렀습니다. 다만 이 수치들은 모두 StepFun이 자체 환경에서 실행한 결과이고, 경쟁 모델의 커널 최적화 능력을 제3자가 같은 조건으로 재현한 것은 아닙니다.
두 번째 실험은 사후 학습(post-training) 루프입니다. Qwen3-30B-A3B 베이스 모델의 AIME24 성능을 자동화된 사후 학습으로 끌어올리는 과제로, 모델은 API 주석기(annotator)를 어떻게 쓸지와 학습 데이터를 어떻게 고칠지를 스스로 정하고 그 선택이 최종 성능에 미치는 영향을 추적해야 합니다.
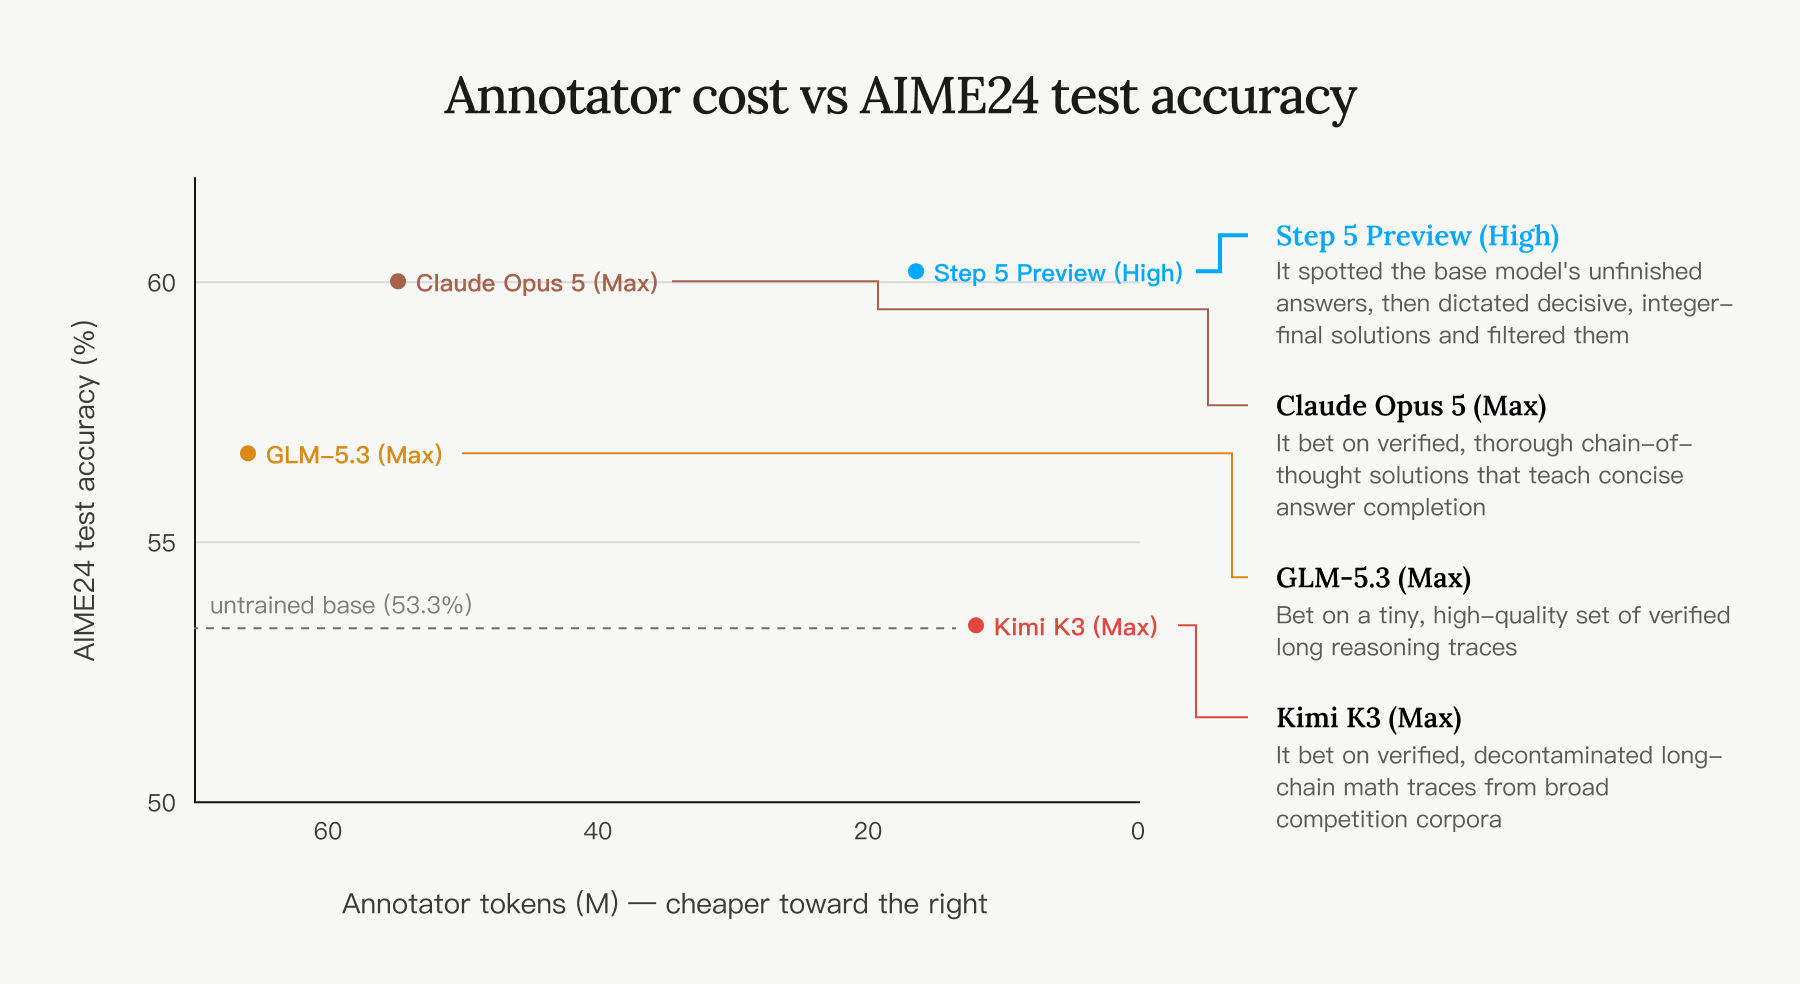
학습 전 53.3%였던 AIME24 정확도는 60%로 올라갔고, 이는 Claude Opus 5가 도달한 지점과 같습니다. 차이는 가로축에 있습니다. 가로축은 오른쪽으로 갈수록 주석기 토큰이 적게 드는 방향인데, 그림에서 Step 5 Preview는 Claude Opus 5보다 한참 오른쪽에 찍혀 있어 대략 3분의 1 수준의 주석 예산으로 같은 정확도에 도달했습니다. Kimi K3는 학습 전 기준선인 53.3% 선에 머물러 개선을 만들지 못했습니다. StepFun은 각 모델이 고른 전략도 함께 적어 두었는데, Step 5 Preview는 기반 모델이 답을 끝맺지 못하는 사례를 찾아내 정수로 끝나는 결정적 풀이를 지시하고 걸러내는 쪽을 택했다고 합니다.
세 번째는 코딩 바깥의 보너스 사례입니다. StepFun은 포켓몬 레드를 긴 시간 범위 실행의 시험대로 삼았습니다. 포켓몬 전용 최적화 없이 3,000턴과 600만 토큰의 상호작용을 이어 갔고, 3,082턴 시점에 기술 Cut을 얻고 체육관 배지 3개를 모은 뒤 Lt. Surge를 이겼습니다. 사람이 본편을 완주하는 데 약 26시간이 걸린다는 점을 감안하면 대략 3분의 1 지점입니다. StepFun은 이 실행을 턴 단위로 되짚을 수 있는 인터랙티브 리플레이도 함께 공개했는데, 총 3,093턴의 의사결정과 누적 토큰 사용량을 같은 타임라인에서 볼 수 있습니다.
stepfun.comStep 5 Preview · Long-horizon gameplay in Pokémon Red
전문 지식 작업과 금융 특화 평가
StepFun은 전문 지식 작업을 답을 찾는 것을 넘어 결과물을 요구되는 형식으로 완성하는 일 로 정의하고 몇 가지 사례를 공개했습니다. 기후 연구 사례에서는 NASA POWER 자료를 대상으로 1,000개 지점의 25년치를 모으기 위해 한 번의 에이전트 동작에서 950건의 웹 요청을 조율했고, 11개 변수에 걸쳐 30만 건의 월별 레코드를 구성한 뒤 2001년부터 2025년까지의 지역 표본 평균에서 유럽과 오세아니아의 태양광 계절성 정점이 정반대 시기에 온다는 결과를 얻었습니다. 경유 할증료 검토 사례에서는 미국 에너지정보청(EIA) 자료를 바탕으로 원자료, 계열 간 대조, 지역별 패널, 수식, 추세 모델을 담은 워크북을 만들었는데, 시트 17개에 행 11,057개와 차트 6개가 들어 있습니다.
두 결과물은 모두 웹에서 직접 열어 볼 수 있습니다.
stepfun.comCompare solar seasonality across 1,000 locations
One model-written collection program expands into hundreds of parallel tool calls, supporting a study of solar seasonality across 1,000 locations and 25 years.
https://www.stepfun.com/assets/diesel-surcharge-workbook-C4xnOt_7.html
금융은 StepFun이 따로 한 절을 할애한 영역입니다. 금융 분석이 요구하는 것은 단순한 수치 추출이 아니라 서로 어긋나는 자료 중에서 신뢰할 출처를 고르고, 보고 기간과 정의의 차이를 맞추고, 가정과 계산이 맞물리는 예측을 세우는 일이라는 것이 StepFun의 설명입니다. 여기에 결론을 출처까지 되짚을 수 있어야 하고, 보고된 사실과 가정을 구분할 수 있어야 하며, 계산을 재현할 수 있어야 한다는 감사 가능성(auditability) 요건이 더해집니다. 이를 재기 위해 StepFun은 시의성 있는 금융 정보의 검색과 검증을 보는 FinStepBench LiveSearch, 재무 데이터와 가정을 일관된 예측과 재현 가능한 밸류에이션으로 바꾸는지 보는 FinStepBench CorporateValuation, 증거 수집부터 보고서 작성까지 전 과정을 보는 FinStepBench DeepResearch라는 세 가지 내부 벤치마크를 만들었습니다.
외부 지표로는 Samaya AI가 공개한 FrontierFinance를 사용했습니다. 투자 워크플로우 전반의 6개 사용 사례를 220개 질의와 11,543개 평가 기준으로 다루는 벤치마크로, 데이터셋과 채점 코드, 기술 보고서가 모두 공개되어 있습니다.
다만 StepFun이 보고한 FrontierFinance 점수는 Samaya가 운영하는 공식 리더보드의 결과와 같은 자리에 놓고 보기 어렵습니다. Samaya는 공개 데이터로 범위를 제한한 공통 하네스에서 자사 시스템이 56.0%로 가장 높고, 프론티어 모델 중에서는 Claude Fable 5가 49.2%, 오픈 웨이트 중에서는 Kimi K3가 46.4%였다고 기술 보고서에 적었습니다. 같은 Kimi K3를 StepFun은 62.6%로 보고했으니 두 수치는 서로 다른 실행입니다. 기술 보고서가 내세운 결론 자체가 모델만이 아니라 도구 하네스가 품질과 효율을 크게 좌우한다 는 것이고 Step 5 Preview는 Samaya 리더보드에 등재되어 있지 않으므로, 벤치마크 이름이 같다는 이유로 두 표를 나란히 붙여 읽지 않는 편이 좋겠습니다.
벤치마크 전반에서 이기는 곳과 지는 곳
StepFun이 공개한 전체 표에서 성격이 다른 항목을 골라 정리하면 아래와 같습니다. 이 표를 통해 Step 5 Preview가 어디서 앞서고 어디서 밀리는지를 함께 확인할 수 있습니다. 표에 † 표시가 붙은 항목은 StepFun이 내부적으로 만든 벤치마크입니다.
벤치마크 Step 5 Preview (High) GLM-5.3 (Max) Kimi K3 (Max) GPT-6 Astra (Max) Claude Opus 5 (Max) AA-LCR v1.1 (긴 컨텍스트 추론) 88.3% 79.7% 88.7% 80.7% 79.3% GPQA Diamond 93.5% 91.7% 93.5% 96.1% 93.2% DeepSWE v1.1 67.7% 66.9% 67.5% 74.1% 74.0% StepCodeBench† 49.0% 40.2% 43.9% 61.0% 63.9% Terminal-Bench v4 33.3% 41.9% 12.6% 57.9% 52.3% GDPval-AA v2.1 1566 1645 1524 1542 1708 Agents' Last Exam (ALE-CLI) 29.5% 28.6% 27.6% 33.3% 28.6% FrontierFinance 66.4% 64.1% 62.6% 55.0% 69.7% MMMU-Pro 76.0% 텍스트 전용 81.0% 87.0% 85.0%긴 컨텍스트 추론을 재는 AA-LCR에서 88.3%로 Claude Opus 5와 GPT-6 Astra를 모두 앞선 것이 눈에 띄는 결과입니다. 1M 컨텍스트를 전면에 내세운 모델답게 긴 컨텍스트를 유지해야 하는 과제에서 강합니다. 반대로 Terminal-Bench v4에서는 33.3%로 GLM-5.3(41.9%)에 밀리고, GDPval 계열인 GDPval-AA v2.1에서도 GLM-5.3이 더 높습니다. 멀티모달 이해를 재는 MMMU-Pro의 76.0%도 비교 대상 중 낮은 축입니다.
원문의 전체 표는 41개 항목으로 훨씬 깁니다. 같은 오픈 웨이트인 GLM-5.3, Kimi K3와만 견주어 전부 세어 보면 Step 5 Preview가 가장 높은 항목이 12개, 중간이 19개, 가장 낮은 항목이 9개이고, 블록별로는 코딩에서 가장 자주 앞서고 범용 에이전트에서 가장 자주 뒤집니다. 같은 터미널 계열 안에서도 갈려서, Terminal-Bench v2.1은 85.0%로 Kimi K3와 공동 1위인 반면 새로 어려워진 v4에서 격차가 드러납니다. 위 발췌 표에서는 원문에 있는 Claude Fable 5.1 열을 뺐는데, 그 열은 빈칸이 많지만 HLE(59.1%)와 GDPval-AA(1735)처럼 채워진 항목에서는 가장 높은 경우가 잦습니다.
DeepSWE v1.1 평가는 SWE-agent 하네스(현재 저장소는 더 단순한 mini SWE-agent 사용을 권하고 있습니다)에 temperature=1.0, top_p=0.95 설정으로 수행했고, GDPval-AA v2.1 점수는 2026년 9월 20일 기준 Artificial Analysis 결과를 가져왔다고 StepFun이 밝히고 있습니다.
API로 써보기
Step 5 Preview는 StepFun 개방 플랫폼에서 step-5-preview라는 모델 ID로 호출할 수 있습니다. 모델 문서에 정리된 주요 제약은 다음과 같습니다.
- 컨텍스트와 출력 한도: 최대 입력 1M 토큰, 최대 출력 64k 토큰입니다.
max_tokens의 기본값은INF로, 값을 주지 않으면 모델이 알아서 결정합니다. - 이미지 입력: URL 또는 Base64로 전달하며 JPG/JPEG, PNG, WebP와 정지 GIF를 지원합니다. 요청당 최대 60장까지 넣을 수 있고
low와high두 가지 상세도를 고를 수 있습니다. - 영상 입력: URL, Base64, 또는 Files API의
stepfile://참조로 전달하며 MP4, QuickTime, Matroska 형식을 지원합니다. 개별 MP4는 128MB 미만이어야 하고 5분 미만을 권장합니다. - 추론 노력 조절:
low,medium,high세 단계를 지원합니다. Chat Completions API에서는reasoning_effort, Messages API에서는output_config.effort를 사용합니다. 위 벤치마크 수치는 모두high설정 기준입니다. - 그 외: 스트리밍 출력, 도구 호출(tool calling), JSON Mode와 JSON Schema를 통한 구조화 출력, 프롬프트 캐싱을 지원합니다.
문서는 도구, 검색, 코드 실행 기능이 모델을 통합한 애플리케이션 쪽에서 제공되는 것이며 모델 자체가 로컬 환경이나 외부 서비스에 접근하지는 않는다는 점을 명시하고 있습니다. 터미널에서 바로 써 보고 싶다면 Claude Code 연동 가이드가 준비되어 있는데, ~/.claude/settings.json 의 env 블록에 API 엔드포인트와 키를 지정해 요청을 Step API로 보내는 방식입니다. 이 경로를 쓰려면 계정에 Step Plan 구독이 있어야 합니다.
남은 관전 포인트
Step 5 Preview의 평가 결과를 정리하면, 최고 점수를 노린 모델이라기보다 특정 지능대의 비용을 낮추는 데 초점을 맞춘 모델로 읽힙니다. Claude Opus 5나 GPT-6 Astra와의 격차는 코딩과 에이전트 계열 여러 항목에서 그대로 남아 있고, StepFun 스스로도 가장 어려운 장시간 작업에서 프론티어와의 격차를 인정했습니다. 대신 지능 지수 44점 구간에서 작업당 비용을 3분의 1로 낮췄다는 점은 제3자 지표로도 확인되며, 이는 Cognition의 SWE-2나 DeepSeek-V4.1-Flash처럼 최근 여러 팀이 동시에 밀고 있는 방향과 같습니다.
가장 큰 변수는 10월 15일로 예고된 가중치 공개입니다. 600B 중 27B 활성이라는 구성은 자체 서빙을 고려하는 쪽에서는 파라미터 총량 대비 추론 비용이 낮은 편이지만, 전체 가중치를 올려 둘 메모리는 그대로 필요합니다. 라이선스는 아직 예고되지 않았지만, StepFun이 앞서 공개한 Step 3.5 Flash와 Step 3.7 Flash가 모두 Apache License 2.0이었다는 점이 참고가 됩니다. 한국어를 포함한 다국어 성능은 현재 공개된 자료로는 확인할 수 없으므로 가중치와 함께 올라올 모델 카드를 확인해야 합니다.
Step 5 Preview 소개 블로그
stepfun.com阶跃星辰
阶跃星辰于2023年4月成立,以“智能阶跃,十倍每个人的可能”为使命。阶跃星辰坚定自研超级模型,积极布局算力、数据等关键资源,发挥算法和人才优势,已完成 Step-1 千亿参数语言大模型和 Step-1V 千亿多模态大模型的研发,在图像理解、多轮指令跟随、数学能力、逻辑推理、文本创作等方面性能达到业界领先水平。
Step 5 Preview 개발자 문서
StepFun DocumentationStep 5 Preview - StepFun Documentation
StepFun의 HuggingFace 페이지
huggingface.costepfun-ai (StepFun)
Org profile for StepFun on Hugging Face, the AI community building the future.
FrontierFinance 벤치마크 홈페이지
research.samaya.aiFrontierFinance: A Benchmark for Financial Reasoning Agents
FrontierFinance is an open benchmark of open-ended financial-research queries scored against expert rubric items.
더 읽어보기
-
Kimi K3, Moonshot AI가 공개한 세계 첫 3T급 오픈 웨이트 모델 (전체 가중치 공개는 7월 27일 예정)
-
OpenAI GPT-6 Astra 출시: 사이버보안 Critical 등급 첫 도달과 낮아진 CoT 모니터링 가능성
-
DeepSeek-V4.1-Flash, KV 캐시를 토큰당 890바이트로 줄이고 플래그십 V4-Pro를 대체하는 552B 규모의 MoE 모델
-
Cognition, Kimi K3 기반 코딩 모델 SWE-2 공개: Fable 5.1과 1점 차, 비용은 64% 절감
-
Step-Audio: 오디오 이해와 생성이 통합된, 다국어 대화 및 감정 표현이 가능한 음성 모델에 대한 연구
이 글은 GPT 모델로 정리한 초안을 바탕으로 한 것으로, 원문의 내용 또는 의도와 다르게 정리된 내용이 있을 수 있습니다. 관심있는 내용이시라면 원문도 함께 참고해주세요! 읽으시면서 어색하거나 잘못된 내용을 발견하시면 댓글로 알려주시기를 부탁드립니다.
이 글은 파이토치 한국 사용자 모임이 직접 정리한 글입니다. 새 글을 놓치지 않으시려면 텔레그램(Telegram)이나 Slack/Discord/Teams/Dooray/GoogleChat 등으로 알림을 받으시고, 회원으로 가입하시면 주요 글들을 이메일로도 보내드립니다!
아래쪽에 좋아요를 눌러주시면 새로운 소식들을 정리하고 공유하는데 힘이 됩니다~
1개의 게시물 - 1명의 참여자